即便两个模型的平均成功率相近,重复执行同一任务时的结果也可能有所不同。“曾经解出过某任务”与“同一任务连续通过五次”,是截然不同的概念。在阅读工具使用型LLM的基准测试报告时,若忽视这一区别,即便面对表格中的数字,也难以判断成功与失败的分布情况。
Bric博客(bric.pe.kr)的作者针对BFCL工具调用任务中的100个案例,分别在单张RTX 3090上运行的4款本地模型以及2款Claude API模型上各执行了5次,并进行评分1。结果显示,“平均成功率”与“五次全部成功的任务数”呈现出不同的趋势。尽管qwen3.8 27B的平均成功率为62.8%,与Claude Sonnet 5.5(67.0%)仅相差约4个百分点,但五次全部成功的任务数却相差15个(42个对57个)1。本文将结合计算过程与实际数据,阐述这两项指标各自衡量的内容,以及为何需同时考量二者。
两项指标是对同一批500次执行数据的不同聚合
实验从BFCL(Berkeley Function Calling Leaderboard)v4多阶段任务multi_turn_base的200个案例中选取了编号为偶数的100个案例,每个模型执行5次。每个任务包含1~6次连续的用户请求。BFCL官方评分器会重新执行模型调用的函数,并在每次用户请求结束时,将系统状态与执行结果与标准答案进行比对。只要有一次不一致,该任务即判定为失败。即使模型声称已完成任务,若状态存在偏差,也无法通过测试。因此,不应将其理解为仅校验最终结果的一次性测试1。
在此实验中,单个模型的总执行次数为100个任务 × 5次 = 500次。两项指标基于不同标准对这500次执行日志进行聚合。
平均成功率指500次执行中成功次数除以500的值。例如,若314次执行成功,则成功率为314 ÷ 500 × 100 = 62.8%。此处314为执行次数,并不意味着解决了314个不同的任务,同一任务的成功记录可能被重复计入。仅凭这一聚合结果,无法判断成功集中于特定任务,还是分散于多个任务。
五次全部成功的任务数的分母并非执行次数(500),而是任务数(100)。具体统计同一任务5次执行均通过的任务数量,只要有一次失败,该任务便不计入统计。因此,该指标反映的是“在重复执行中表现稳定的任务”数量。作者还额外统计了“至少成功一次的任务数”与“成功与失败混杂的任务数”,以更精细地刻画任务稳定性1。
综上所述,平均成功率以“执行次数”为分母,而五次全部成功的任务数以“任务数”为分母。尽管两项指标源自同一批执行日志,但由于聚合单位不同,二者所传递的信号也不相同。
即便平均值相同,重复执行的表现仍可能存在巨大差异
为理解两项指标出现偏差的原因,我们来探讨一个比实际数据更简化的虚拟案例。以下计算并非Bric博客的实测结果,而是为说明指标差异所设定的假设情境。
假设对3个任务各执行5次,共计15次执行。虚拟模型A在各任务上的成功次数分别为5、5、0;虚拟模型B则为4、3、3。
| 任务 | 模型 A 成功次数 | 模型 B 成功次数 |
|---|---|---|
| 任务 1 | 5 / 5 | 4 / 5 |
| 任务 2 | 5 / 5 | 3 / 5 |
| 任务 3 | 0 / 5 | 3 / 5 |
| 合计 | 10 / 15 | 10 / 15 |
两个模型在15次执行中均有10次成功,因此平均成功率均约为66.7%,完全相同。然而,五次全部成功的任务数在模型A为2个,模型B为0个。在此虚拟记录中,模型A的两个任务每次均通过,另一个任务则每次均失败;模型B在每个任务上都至少成功一次,但在每个任务中也出现过失败。相同总数背后隐藏着截然不同的分布形态。该示例仅解释给定的15次执行记录,无法保证后续执行必然成功。
反之,若模型A的分布模式为5/5、4/5、1/5,平均成功率仍为66.7%,但五次全部成功的任务数将降至1个。这意味着,五次全部成功次数对成功次数的分布极为敏感,而平均成功率却无法反映这种分布差异。若平均成功率回答的是“有多少次执行通过”,那么五次全部成功次数回答的则是“有多少任务能通过重复测试”。
共同解读 Sonnet 与 qwen 的测量数据
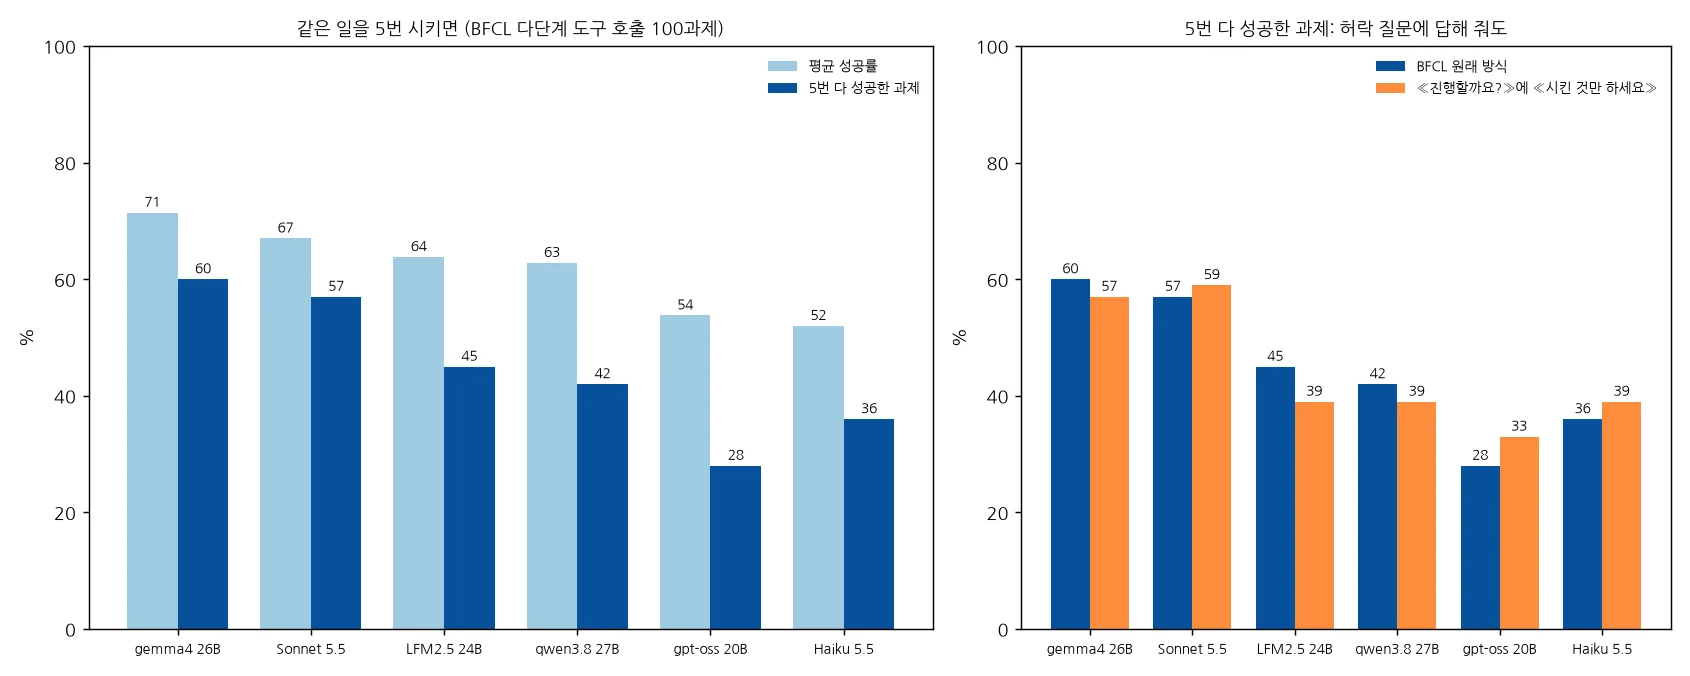
在解读实际测量数据之前,需明确区分执行条件。本地模型在单张RTX 3090、Ollama 0.40.13、上下文长度32k环境下运行,且每次迭代均更换种子;Claude模型则通过Anthropic API执行,温度参数设为1.0,未启用扩展思考功能。不应将本地模型的种子更换操作直接套用于Claude API的解读中。此外,原文LFM2.5表格中的数值是基于默认温度从0.1调整为1.0后重新测量的结果,并非所有行均保留各模型的默认配置1。
| 模型 | 执行环境 | 平均成功率 | 至少成功一次 | 五次全部成功 | 成功失败混杂 |
|---|---|---|---|---|---|
| Claude Sonnet 5.5 | API | 67.0% | 76 | 57 | 19 |
| qwen3.8 27B | RTX 3090 本地 | 62.8% | 83 | 42 | 41 |
Sonnet与qwen的平均成功率相差4.2个百分点,五次全部成功的任务数相差15个;而至少成功一次的任务数,qwen(83个)反而多于Sonnet(76个)。在原文提及的六个模型中,该指标的最高值也为qwen(83个)1。因此,若从某一列观察,qwen完成了更多任务;若从另一列观察,Sonnet则有更多内容任务实现五次全部通过。阅读哪一列指标,决定了所探讨的问题。
通过两个任务数相减,可得出成功与失败混杂的任务数量。Sonnet对应76 - 57 = 19개,qwen对应83 - 42 = 41개。反之,用100减去至少成功一次的任务数,可知在本次五次执行中分别有24个与17个任务未实现任何一次通过。这些数值均针对同一批100个任务分类得出。这里的83个代表观测到的成功范围,并非模型可解任务数量的上限。
基于57个与42个这两个数值,我们无法直接宣称实际服务的可靠性提升多少倍。毕竟,所统计的指标是“在特定100个任务中五次全部成功的任务数”。原文亦指出局限性:仅使用英文任务且重复执行5次。增加重复次数后,全部成功的任务数可能会减少1。此表格仅反映测试范围内的结果,无法保证其他业务场景或韩语指令下也会得到相同结论。
解读失败记录时也需区分实验条件
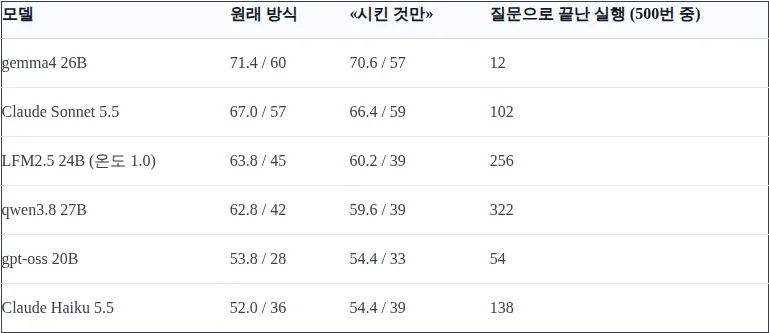
明确数值差异与解释差异成因,是两件不同的事。仅凭函数调用顺序不同,无法直接判定为失败。本项测试的判定标准为每次请求时确认的系统状态与执行结果。若系统状态与结果一致,则无需强制要求调用路径完全相同。反之,即便最终回答自然流畅,若中间请求阶段的状态出现偏差,该请求也将计入失败范围1。
原文作者针对模型未继续执行而是向用户请求确认的情况,开展了专门回答提问的附加实验。初期作者向模型发送了简单的同意回复,后发现这种回复方式可能导致模型同意执行原本未请求的附加任务。于是,作者改用“只执行用户请求的任务”的回复重新测量。这并非改变了模型的系统提示词,而是执行管理方添加了后续用户回复的测试条件1。
原文提及的qwen提问中断次数322次,对应在此后续回复条件下的500次执行。不可将其误读为与初始平均62.8%、五次全部通过42个任务等条件的同列数据。提问检测基于预设的表达规则,甚至包含模型建议执行其他操作的句子。作者指出,仅凭这些数据无法支持“提问较多的模型在分数上必然吃亏”这一假设1。这也是不能仅以“提问次数多”为由,直接认定整体成功率差异根源的原因。
此外,作者还介绍了一些案例:Sonnet在生成文档时插入了未请求的标题与样式,导致结果与预期的空白文件不一致。尽管该任务在此情形下五次均出现此问题,但作者明确指出,未统计此类失败在整体中的占比1。个案记录有助于理解评分为何判定为失败,但无法将单一案例的解释推广到整体性能差异。
结合三项指标,才能准确理解评估结果
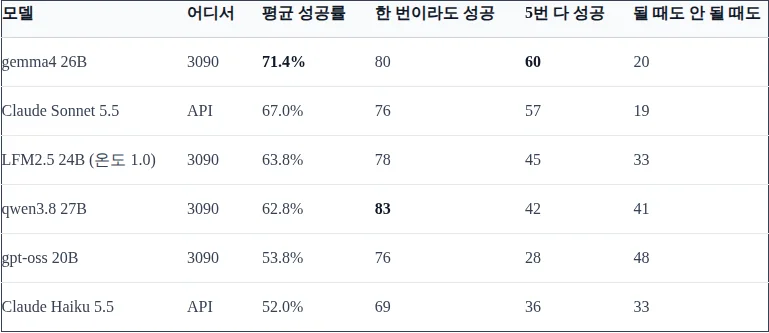
在此对比中,相较于选择哪个模型的口号,更重要的是阅读表格的步骤。首先确认平均成功率是全部执行中通过的比例,随后并行查看至少成功一次的任务数与每次均成功的任务数。将成功与失败混杂的任务数并列显示,可揭示仅凭平均值难以察觉的分布特征。将qwen的41个任务写成全部模型中最多,也是一种误读。原文中存在该值为48的gpt-oss 20B模型1。
最后,需确认所统计的指标涵盖了哪些执行结果。原文将本地执行工具未能处理响应的错误以及Claude API连接错误均计入失败1。因此,不能将统计到的失败情况全部解释为模型无法理解任务。仅凭模型名称与得分,难以厘清指标的有效范围,唯有结合执行环境、是否存在后续回复、错误统计方式等信息,才能获得准确认知。
平均成功率综合反映整体执行情况,五次全部成功的任务数则体现同一任务的重复记录特征,二者不可互相替代。若已阅读Sonnet的67.0%与qwen的62.8%,那么同时查看57个与42个任务数、76个与83个任务数,才能更准确地理解本次基准测试结果。首先区分分母,再确认成功分布,最后在测量条件的边界内解读结果。



