亚马逊大规模内部工单分类系统的AI成本降低了约98%。这并不是因为选择了更廉价的大语言模型,而是因为将AI从撰写“冗长说明(作文)”改为仅选择“一个正确答案(选择)”,尽管处理的是同一项任务。
通过改变输出格式,平均处理时间从4秒降至不足1秒,每百万次请求的成本从约22,200美元降至500美元。我们将通过亚马逊内部工单系统团队(Carr·Mehul)公开的案例,探讨为何仅减少输出就能显著改善成本和速度。1, 2
为什么工单分类需要“长篇分析文”
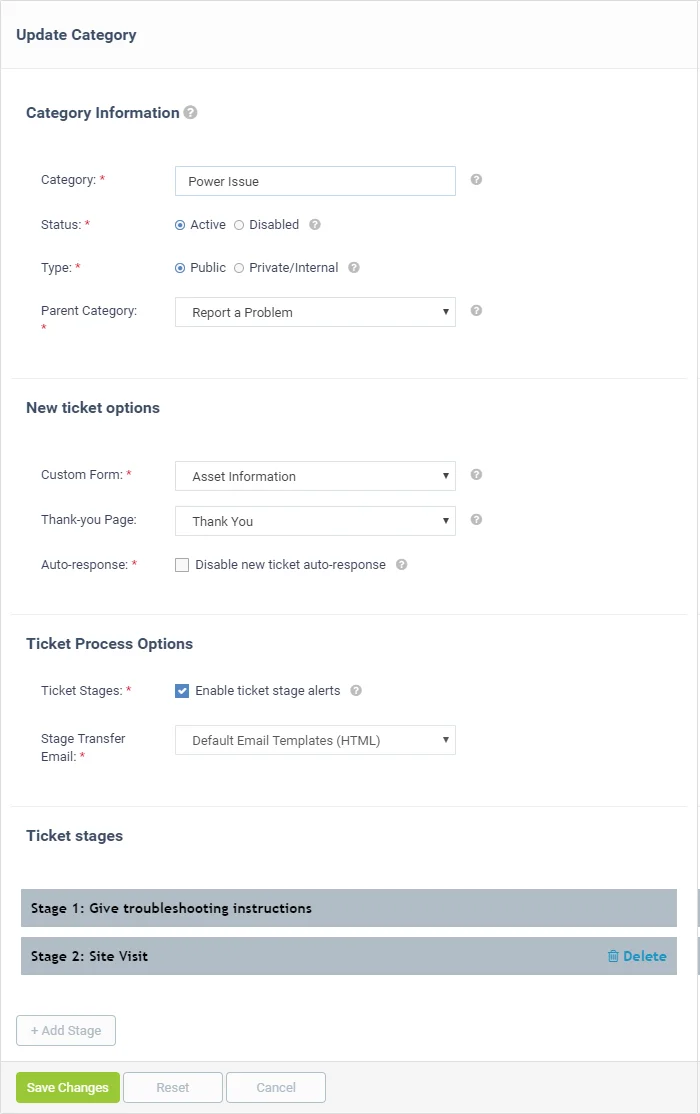
亚马逊的内部工单系统大规模处理以下任务:将客户升级请求、服务器容量申请、自动警报、安全发现等事项分类为20个固定类别之一。2
此前,这项工作由名为“Claude Sonnet 4.6”的大语言模型(LLM)承担。AI分析工单内容,并生成复杂的JSON格式文本,其中包括选择该标签的理由。AI每次为一张工单输出的文本量(词元)平均达到170个。2
然而,若剖析分类这一业务的本质,它就是“从给定的20个列表中选择一个”。在不需长篇写作的任务中,却在进行过度的“创作”。大语言模型通常根据输入和输出使用的词元数量按比例收费。因此,AI生成不必要的冗长说明越多,成本就越急剧增加。2
切除文本生成装置的“决策模型”
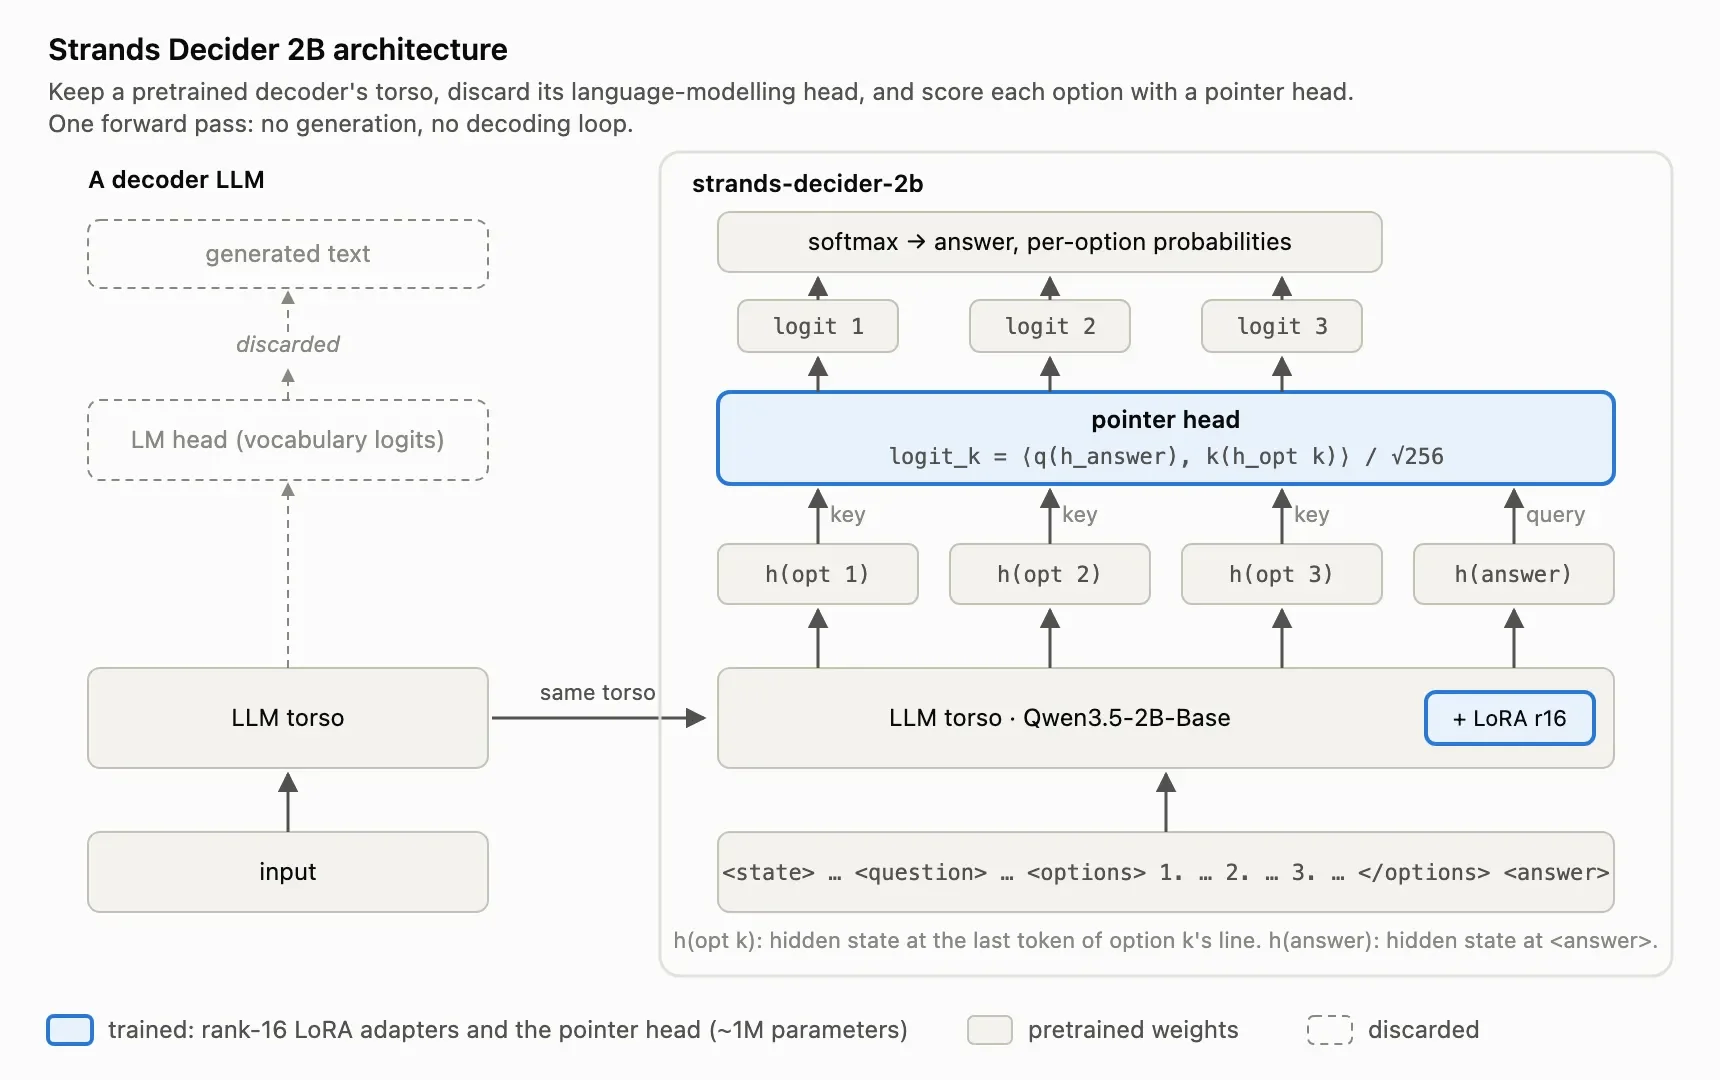
通过strandsagents.com博客公开系统结构的亚马逊内部工程团队,使用名为“Strands Decider”的决策模型替换了原有系统。该模型在内部结构上与通用生成式AI不同。2, 3
通用AI拥有名为“LM head(语言模型头)”的文本生成装置,它通过选择下一个字符来构成句子。相比之下,Strands Decider从预训练语言模型的主体(torso)中切除了这个LM head。3
取而代之的是附加了一个名为“pointer head(指针头)”的小型结构,用于为每个候选选项评分。与其命令AI直接写出答案,不如询问“从A到T中哪个最合适,其概率是多少?”,并仅让其计算概率和置信度分数。由于无法生成文本,因此不会产生列表之外的荒谬答案;同时,逐字生成文本的过程消失,处理速度大幅加快。3
亚马逊团队最初使用2B规模的模型,后转换为在测试中表现更佳的基于Gemma 4的“E4B”模型进行运营。2 值得注意的是,E4B模型在JevBench v1这一公开任务的231项评估中,记录了81.0%的准确率。4
输入数据压缩与顺序变量控制
不仅改变了输出格式,输入数据也根据模型的处理限制进行了高效压缩。
原运营环境中存在的20个标签的详细描述文,已超过决策模型4,096个词元的最大处理容量。因此,将其重写为一两句长度的简短“判定标准”。此外,为了处理无法精确归入任何列表的工单,增加了“none”这一选项。若工单内容较长,系统会删减最旧的评论以控制篇幅。2
团队还发现了数据标注顺序改变结果的现象。即使是内容相同的工单数据,仅改变AI读取JSON键的排序顺序,被指定为答案的概率最大波动0.19。为解决这一问题,亚马逊团队采用了预先按字母顺序等对请求数据所有键值排序后再传递的方式。2
从按量付费转为固定费用结构,成本降低98%的计算
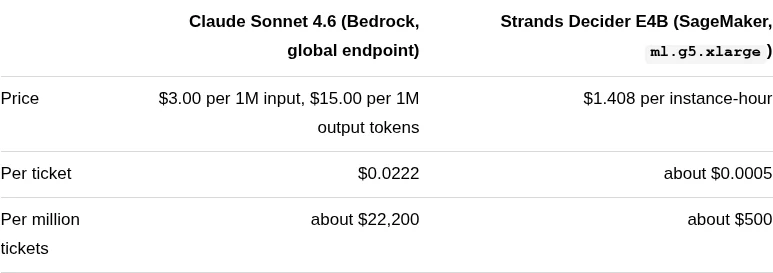
经过这些调整,每张工单分类产生的成本大幅下降。成本骤减的核心原因在于“计费结构的变化”。
| 比较项目 | 原有:Claude Sonnet 4.6 | 替换:Strands Decider E4B |
|---|---|---|
| 平均调用时间 | 4,215 ms | 897 ms |
| 总使用词元 | 6,724个 | 2,010个 |
| 输出格式 | 平均170个词元的JSON | 1个选项(1个词元) |
| 单次成本 | $0.0222 | 约 $0.0005 |
| 每百万次成本 | 约 $22,200 | 约 $500 |
表来源:亚马逊内部工单分类系统比较资料 2
像Claude Sonnet 4.6这样的大语言模型API采用“按量付费”制。每百万输入词元收费3美元,每百万输出词元收费15美元。因此,输出量减少和输入压缩导致成本降低是理所当然的。2
另一方面,运行Strands Decider E4B的方式是直接运营按小时计费的云服务器实例(ml.g5.xlarge),属于“固定费用”结构。该服务器实例的小时费用为1.408美元。1, 2
由于单次处理时间仅约640ms(0.64秒),满载运行时单台服务器每小时可处理约5,600张工单。在此状态下,每百万次的单价降至250美元左右。但实际运营中需为流量激增预留缓冲容量,因此包含所有因素在内,每百万次的实际成本测算为约500美元。2
摆脱根据AI写作长度计算的“字数比例计费”,转变为与服务器运行时间成比例的“固定费用”体系,预计这将带来每年高达数百万美元的大规模成本节约。1, 2
实际流量中的双重化验证过程
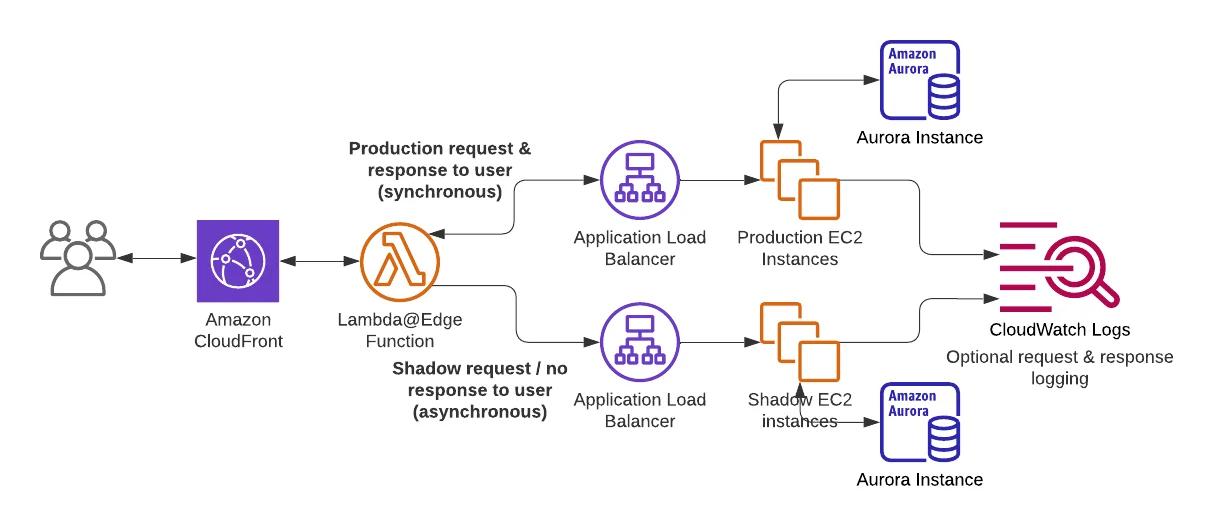
即使性能指标良好,如果将新模型突然应用于正在运行的系统,也可能发生预期外的错误。为安全切换系统,亚马逊团队引入了名为“DUAL模式”的双重化结构。2
在DUAL模式下,真实客户数据同时传输给原有的Sonnet模型和新的Decider模型。但最终应用到系统中的分类结果仍沿用原有Sonnet的结果。仅当两个模型结果不一致时,才将其单独记录,以精确比较和分析分类差异。亚马逊工程团队表示,通过这一过程获得了比离线评估更多的运营信息。此外,若新模型出现问题,他们已设置好安全机制,仅需更改配置即可在45秒内立即回退至原有系统。1, 2
另一方面,在调整置信度阈值后,使用另一组真实工单集合对两个模型进行评估的结果显示,Decider模型的分类效果优于运行中的Sonnet。1, 2
哪些任务适用这种方式
基于决策模型的替换在特定条件下能带来明确的效率提升。根据亚马逊团队公开的资料,这种方式在“从预定列表中选择一个的封闭式任务”、“处理量巨大”且“延迟时间至关重要”的环境中特别有效。1, 2
相反,由于不生成文本的模型特性,其不适用于生成详细分析句子。如果分类标签必须附带长篇说明,或者列表每周变更,或者分类所需的有用上下文超过数千词元的处理限制,则难以取代大语言模型。1, 2
如果是无需指示AI进行复杂推理和长文本写作、仅需从预定列表中选择一个的封闭式任务,且处理量巨大、现有路径延迟时间至关重要的环境,那么减轻长句生成的负担,将在成本和速度两方面带来巨大优势。1, 2
参考资料
- ↩
- Amazon saves millions by replacing Sonnet 4.6 with Strands Decider · strandsagents.com↩
- Introducing Strands Decider 2B: a small, open source, decision model · strandsagents.com↩
- Strands Decider adds four Gemma 4 models · strandsagents.com↩