Amazon ha reducido en aproximadamente un 98 % los costes de IA de su sistema interno de clasificación de tickets, utilizado a gran escala. No se trata de una elección deliberada de modelos de lenguaje de gran tamaño (LLM) más económicos, sino de un cambio en la estrategia: mientras la IA generaba previamente 'explicaciones detalladas (redacción larga)', ahora únicamente se limita a seleccionar 'la respuesta correcta (una sola opción)'.
Al modificar el formato de salida, el tiempo medio de procesamiento se redujo de 4 segundos a menos de 1 segundo, y el coste por millón de casos pasó de aproximadamente 22 200 dólares a 500 dólares. Analizaremos este caso publicado por el equipo interno del sistema de tickets de Amazon (Carr·Mehul) para entender cómo la simple reducción de la salida puede mejorar de forma tan espectacular tanto la velocidad como el coste. 1, 2
¿Por qué se necesitaba un 'análisis detallado' para clasificar tickets?
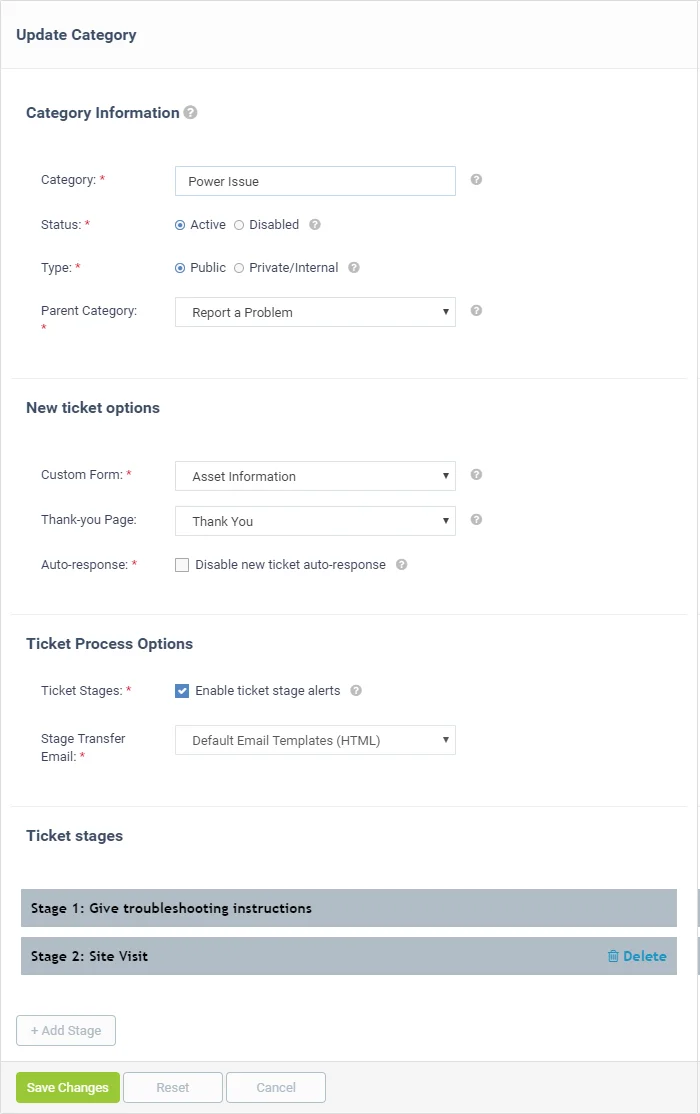
El sistema interno de tickets de Amazon gestiona a gran escala tareas que consisten en clasificar escalados de atención al cliente, solicitudes de capacidad de servidor, alertas automáticas y hallazgos de seguridad dentro de una de 20 categorías fijas. 2
Anteriormente, la tarea corría a cargo de un LLM llamado 'Claude Sonnet 4.6'. La IA analizaba el contenido del ticket y generaba un texto complejo en formato JSON que incluía también las razones por las que se había seleccionado dicha etiqueta. La cantidad de texto (tokens) generada por la IA para cada ticket alcanzaba una media de 170. 2
Sin embargo, si analizamos la naturaleza esencial de la clasificación, esta se reduce simplemente a 'elegir una opción de entre una lista dada de 20'. Se estaba realizando una excesiva 'redacción' para una tarea que no exigía ningún tipo de composición textual. Habitualmente, los LLMs se facturan en proporción al número de tokens utilizados en la entrada y en la salida. Cuanto más largas son las explicaciones innecesarias que la IA se ve obligada a generar, más se disparan los costes. 2
Un 'modelo decisor' que elimina el dispositivo de generación de texto
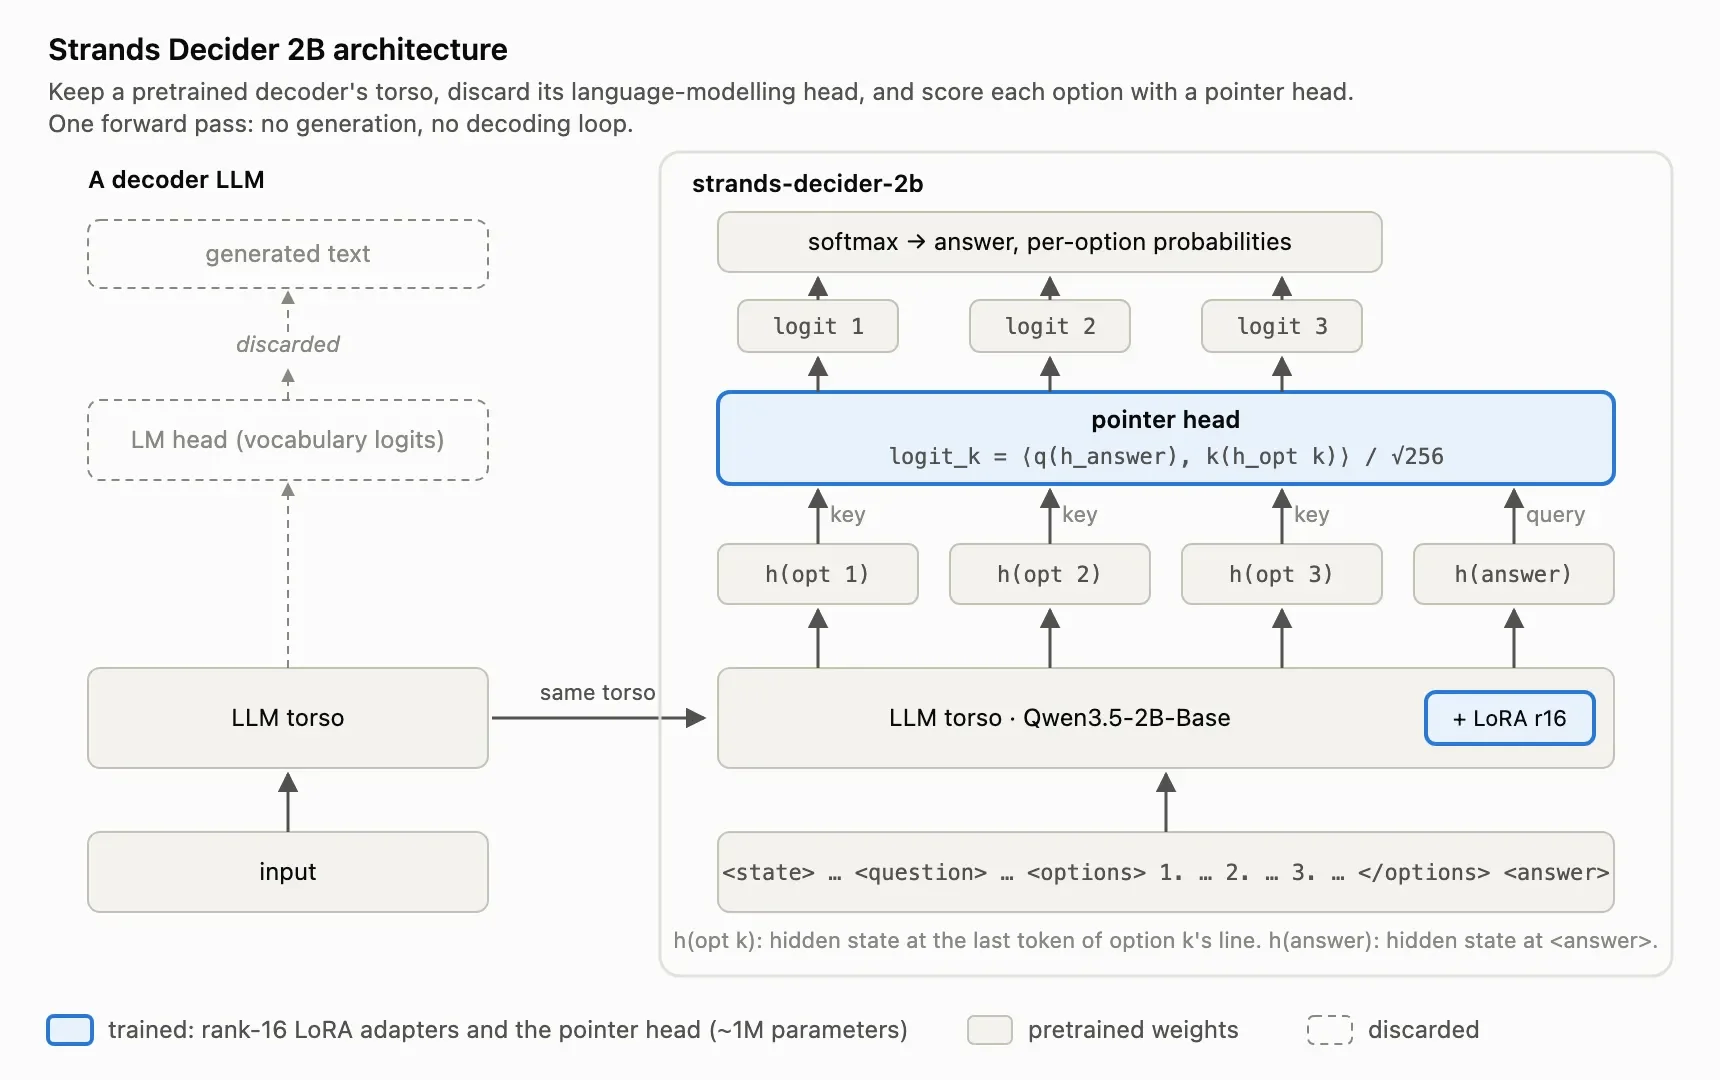
El equipo de ingenieros internos de Amazon, que hizo pública la arquitectura del sistema a través del blog strandsagents.com, sustituyó el sistema por un modelo decisor llamado 'Strands Decider'. Este modelo difiere de los modelos generativos convencionales incluso en su estructura interna. 2, 3
Los modelos de IA convencionales disponen de un dispositivo de generación de texto denominado 'LM head' (cabezal LM), que selecciona el carácter siguiente para construir frases. Por el contrario, Strands Decider elimina dicho LM head del tronco (torso) del modelo lingüístico preentrenado. 3
En su lugar, se incorpora una pequeña estructura llamada 'pointer head' (cabezal puntero) que asigna puntuaciones a cada una de las opciones candidatas. En lugar de ordenar a la IA que redacte directamente la respuesta, se le formula la pregunta: «¿Cuál de A a T es la más adecuada y con qué probabilidad?», de modo que solo calcula probabilidades y puntuaciones de confianza. Como no puede generar texto, resulta imposible que produzca respuestas descabelladas fuera de la lista; además, al desaparecer el proceso de escritura letra por letra, la velocidad de procesamiento aumenta notablemente. 3
El equipo de Amazon empleó inicialmente un modelo de 2B parámetros y, tras observar mejores resultados en las pruebas, pasó a operar con un modelo 'E4B' basado en Gemma 4. 2 Como dato adicional, el modelo E4B alcanzó una precisión del 81,0 % en la evaluación pública de 231 tareas de JevBench v1. 4
Compresión de los datos de entrada y control de variables dependientes del orden
No solo se modificó el formato de salida, sino que también se comprimirón eficientemente los datos de entrada para adaptarse a los límites de procesamiento del modelo.
Las descripciones detalladas de las 20 etiquetas presentes en el entorno operativo original ya superaban la capacidad máxima de procesamiento del modelo decisor, limitada a 4 096 tokens. Por ello, se reformularon en breves 'criterios de decisión' de una o dos frases de longitud. Además, para gestionar tickets que no encajaban exactamente en ninguna categoría, se añadió la opción 'none' (ninguna). Cuando el contenido de un ticket resultaba excesivamente extenso, el sistema recortaba los comentarios empezando por los más antiguos hasta ajustar el volumen. 2
También se observó que el orden de representación de los datos puede alterar los resultados. Aunque los datos del ticket fueran idénticos en contenido, el simple hecho de que cambiara el orden de alineación de las claves JSON que la IA debía leer provocaba una variación de hasta 0,19 en la probabilidad señalada como respuesta. Para solventar esto, el equipo de Amazon adoptó un sistema que preordena alfabéticamente (o mediante otro criterio fijo) las claves de todos los datos de solicitud antes de transmitirlos. 2
Cambio de estructura de facturación por uso a costes fijos: 98 % de reducción
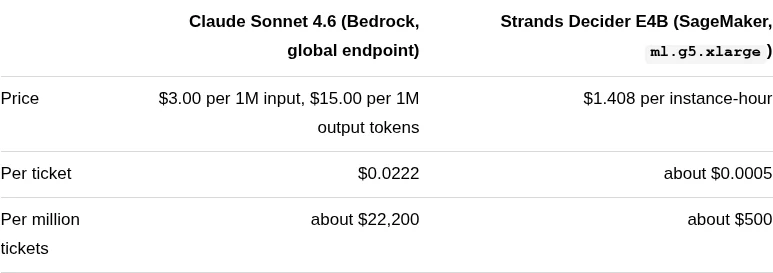
Gracias a estos ajustes, el coste por ticket clasificado disminuyó drásticamente. La razón principal de esta caída reside en el 'cambio de la estructura de facturación'.
| Concepto comparado | Anterior: Claude Sonnet 4.6 | Nuevo: Strands Decider E4B |
|---|---|---|
| Tiempo medio de llamada | 4 215 ms | 897 ms |
| Tokens totales utilizados | 6 724 | 2 010 |
| Formato de salida | JSON de media 170 tokens | Una sola opción (1 token) |
| Coste por caso | 0,0222 USD | Aprox. 0,0005 USD |
| Coste por millón de casos | Aprox. 22 200 USD | Aprox. 500 USD |
Fuente de la tabla: Material comparativo del sistema interno de clasificación de tickets de Amazon 2
Las API de los LLMs, como Claude Sonnet 4.6, siguen un modelo de 'pago por uso'. Se facturan 3 USD por millón de tokens de entrada y 15 USD por millón de tokens de salida. En consecuencia, es natural que los costes disminuyan cuando se reduce la cantidad de salida y se comprime la entrada. 2
Por el contrario, el modo de ejecución de Strands Decider E4B se basa en una estructura de 'costes fijos', consistente en pagar una tarifa horaria por gestionar directamente una instancia de servidor en la nube (ml.g5.xlarge). El coste por hora de esta instancia de servidor es de 1,408 USD. 1, 2
Dado que el tiempo de procesamiento por caso es de aproximadamente 640 ms (0,64 s), un único servidor en funcionamiento a plena capacidad puede gestionar unos 5 600 tickets por hora. En este escenario, el coste unitario por millón de casos bajaría a unos 250 USD. No obstante, en la práctica operativa debe mantenerse una capacidad holgada para hacer frente a picos de tráfico, por lo que el coste real por millón de casos, incluyendo todos estos factores, se calculó en unos 500 USD. 2
El paso de una 'facturación proporcional al número de caracteres', dependiente de cuántas palabras genera la IA, a un sistema de 'costes fijos' proporcional al tiempo de funcionamiento del servidor, se prevé que conduzca a un ahorro a gran escala estimado en varios millones de dólares anuales. 1, 2
Proceso de validación con redundancia bajo tráfico real
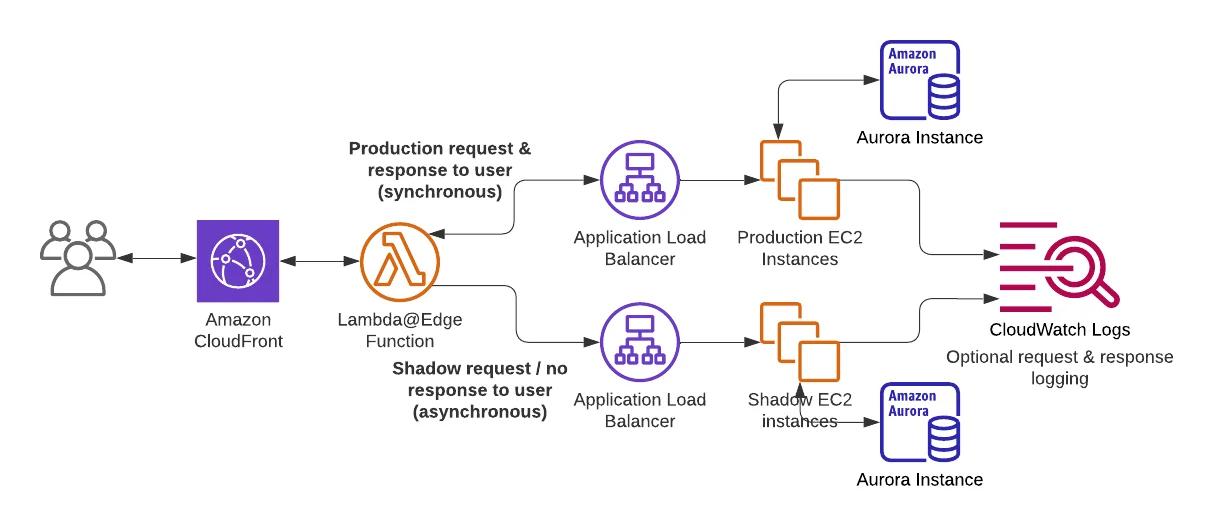
Aunque los indicadores de rendimiento sean favorables, la aplicación repentina de un nuevo modelo a un sistema en operación puede provocar errores inesperados. Para llevar a cabo la transición con seguridad, el equipo de Amazon implementó una estructura de redundancia denominada 'modo DUAL'. 2
En modo DUAL, los datos reales de clientes se envían simultáneamente al modelo Sonnet existente y al nuevo modelo Decider. Sin embargo, los resultados de clasificación que finalmente se aplican al sistema provienen del modelo Sonnet clásico. Solo cuando los resultados de ambos modelos difieren, se registran por separado para comparar y analizar con precisión las discrepancias de clasificación. El equipo de ingenieros de Amazon comenta que este proceso les permitió obtener información operativa mucho más valiosa que la obtenida en evaluaciones offline. Asimismo, establecieron un mecanismo de seguridad que, en caso de problema con el nuevo modelo, permite revertir al sistema original en tan solo 45 segundos mediante un simple cambio de configuración. 1, 2
Por otro lado, tras ajustar el umbral de confianza y evaluar ambos modelos con un conjunto independiente de tickets reales, los resultados mostraron que el modelo Decider ofrecía una clasificación mejor que la del modelo Sonnet operativo. 1, 2
¿En qué tipos de tareas puede aplicarse esta metodología?
La sustitución mediante modelos decisores ofrece eficiencias claras bajo ciertas condiciones. Según la documentación publicada por el equipo de Amazon, este método resultó especialmente eficaz en entornos donde se trataba de 'tareas cerradas (seleccionar una opción de una lista predefinida)', se gestionaba un 'volumen de procesamiento inmenso' y la 'latencia (tiempo de respuesta)' era un factor crítico. 1, 2
En cambio, por su naturaleza de modelo que no genera texto, resulta inadecuado para la creación de frases de análisis detalladas. Cuando una explicación larga es indispensable junto a la etiqueta de clasificación, cuando la lista cambia semanalmente, o cuando el contexto útil necesario para la clasificación supera el límite de procesamiento de varios miles de tokens, es posible que no sea factible sustituir un LLM. 1, 2
Si se trata de una tarea cerrada en la que basta con elegir una opción de una lista predefinida, sin necesidad de encargar a la IA razonamiento complejo ni redacción extensa, y si el volumen de procesamiento es masivo y la latencia de la ruta existente es importante, eliminar la carga de generar frases largas aporta ventajas significativas tanto en costes como en velocidad. 1, 2
Referencias
- ↩
- Amazon saves millions by replacing Sonnet 4.6 with Strands Decider · strandsagents.com↩
- Introducing Strands Decider 2B: a small, open source, decision model · strandsagents.com↩
- Strands Decider adds four Gemma 4 models · strandsagents.com↩