Aquí se muestra una escena de juego de rol de Pokémon compartida por el usuario YariPoké en el foro de caracteres AI de Akarai. Nada más llegar a la Ruta 1 de la isla Melemele en la región de Alola, el entrenador «Hanjwoo» declara: «Parece que ayer estábamos teniendo batallas increíblemente impresionantes, pero nada más bajarnos en el puerto, mi mente quedó completamente en blanco, como si alguien la hubiera borrado con una goma de borrar». Pikachu mira de reojo desde abajo, con los ojos entreabiertos, hacia el perfil de Hanjwoo. Cuando Hanjwoo bromea con un juego de palabras sobre su propio nombre («Supongo que significa que debo borrar los recuerdos con frialdad»), Pikachu deja caer una oreja de golpe, se lleva una pata delantera a la frente y, acto seguido, la conversación se centra en «los papás de los 600» 1.
En la parte inferior de la publicación, aparece un comentario de una sola línea que dice: «No es la primera ni la segunda vez que veo que le hacen un reseteo al cerebro» 1. Es el instante en que el personaje de IA trata sus propios vacíos de memoria como un elemento narrativo integrado en su discurso, interpretándolo como «amnesia». Aunque no se trata de un informe de errores, la escena describe el fenómeno con precisión notable. No es que el personaje estuviera fingiendo olvido intencionadamente, sino que, tras eliminarse el contenido de las conversaciones anteriores de la «mesa de trabajo» de la IA, este vacío se explica únicamente con los ajustes que aún permanecen en el contexto.
La analogía de la mesa de trabajo: la IA no recuerda, vuelve a leer cada vez
Cuando un personaje de IA dice repentinamente algo incoherente, solemos sentir que «la IA se ha olvidado». El blog técnico junhyunp.github.io explica esta sensación no como pereza del modelo, sino como un problema estructural. La API de los grandes modelos de lenguaje (LLM) posee, por naturaleza, una arquitectura sin estado (stateless), es decir, que no almacena información entre solicitudes. Aunque la conversación parece fluir con naturalidad, lo que realmente ocurre es que cada solicitud envía íntegramente todo el historial previo junto con la nueva pregunta 2. Así pues, no es que el modelo recuerde y continúe, sino que el usuario vuelve a narrarle los contenidos memorizados en cada ocasión.
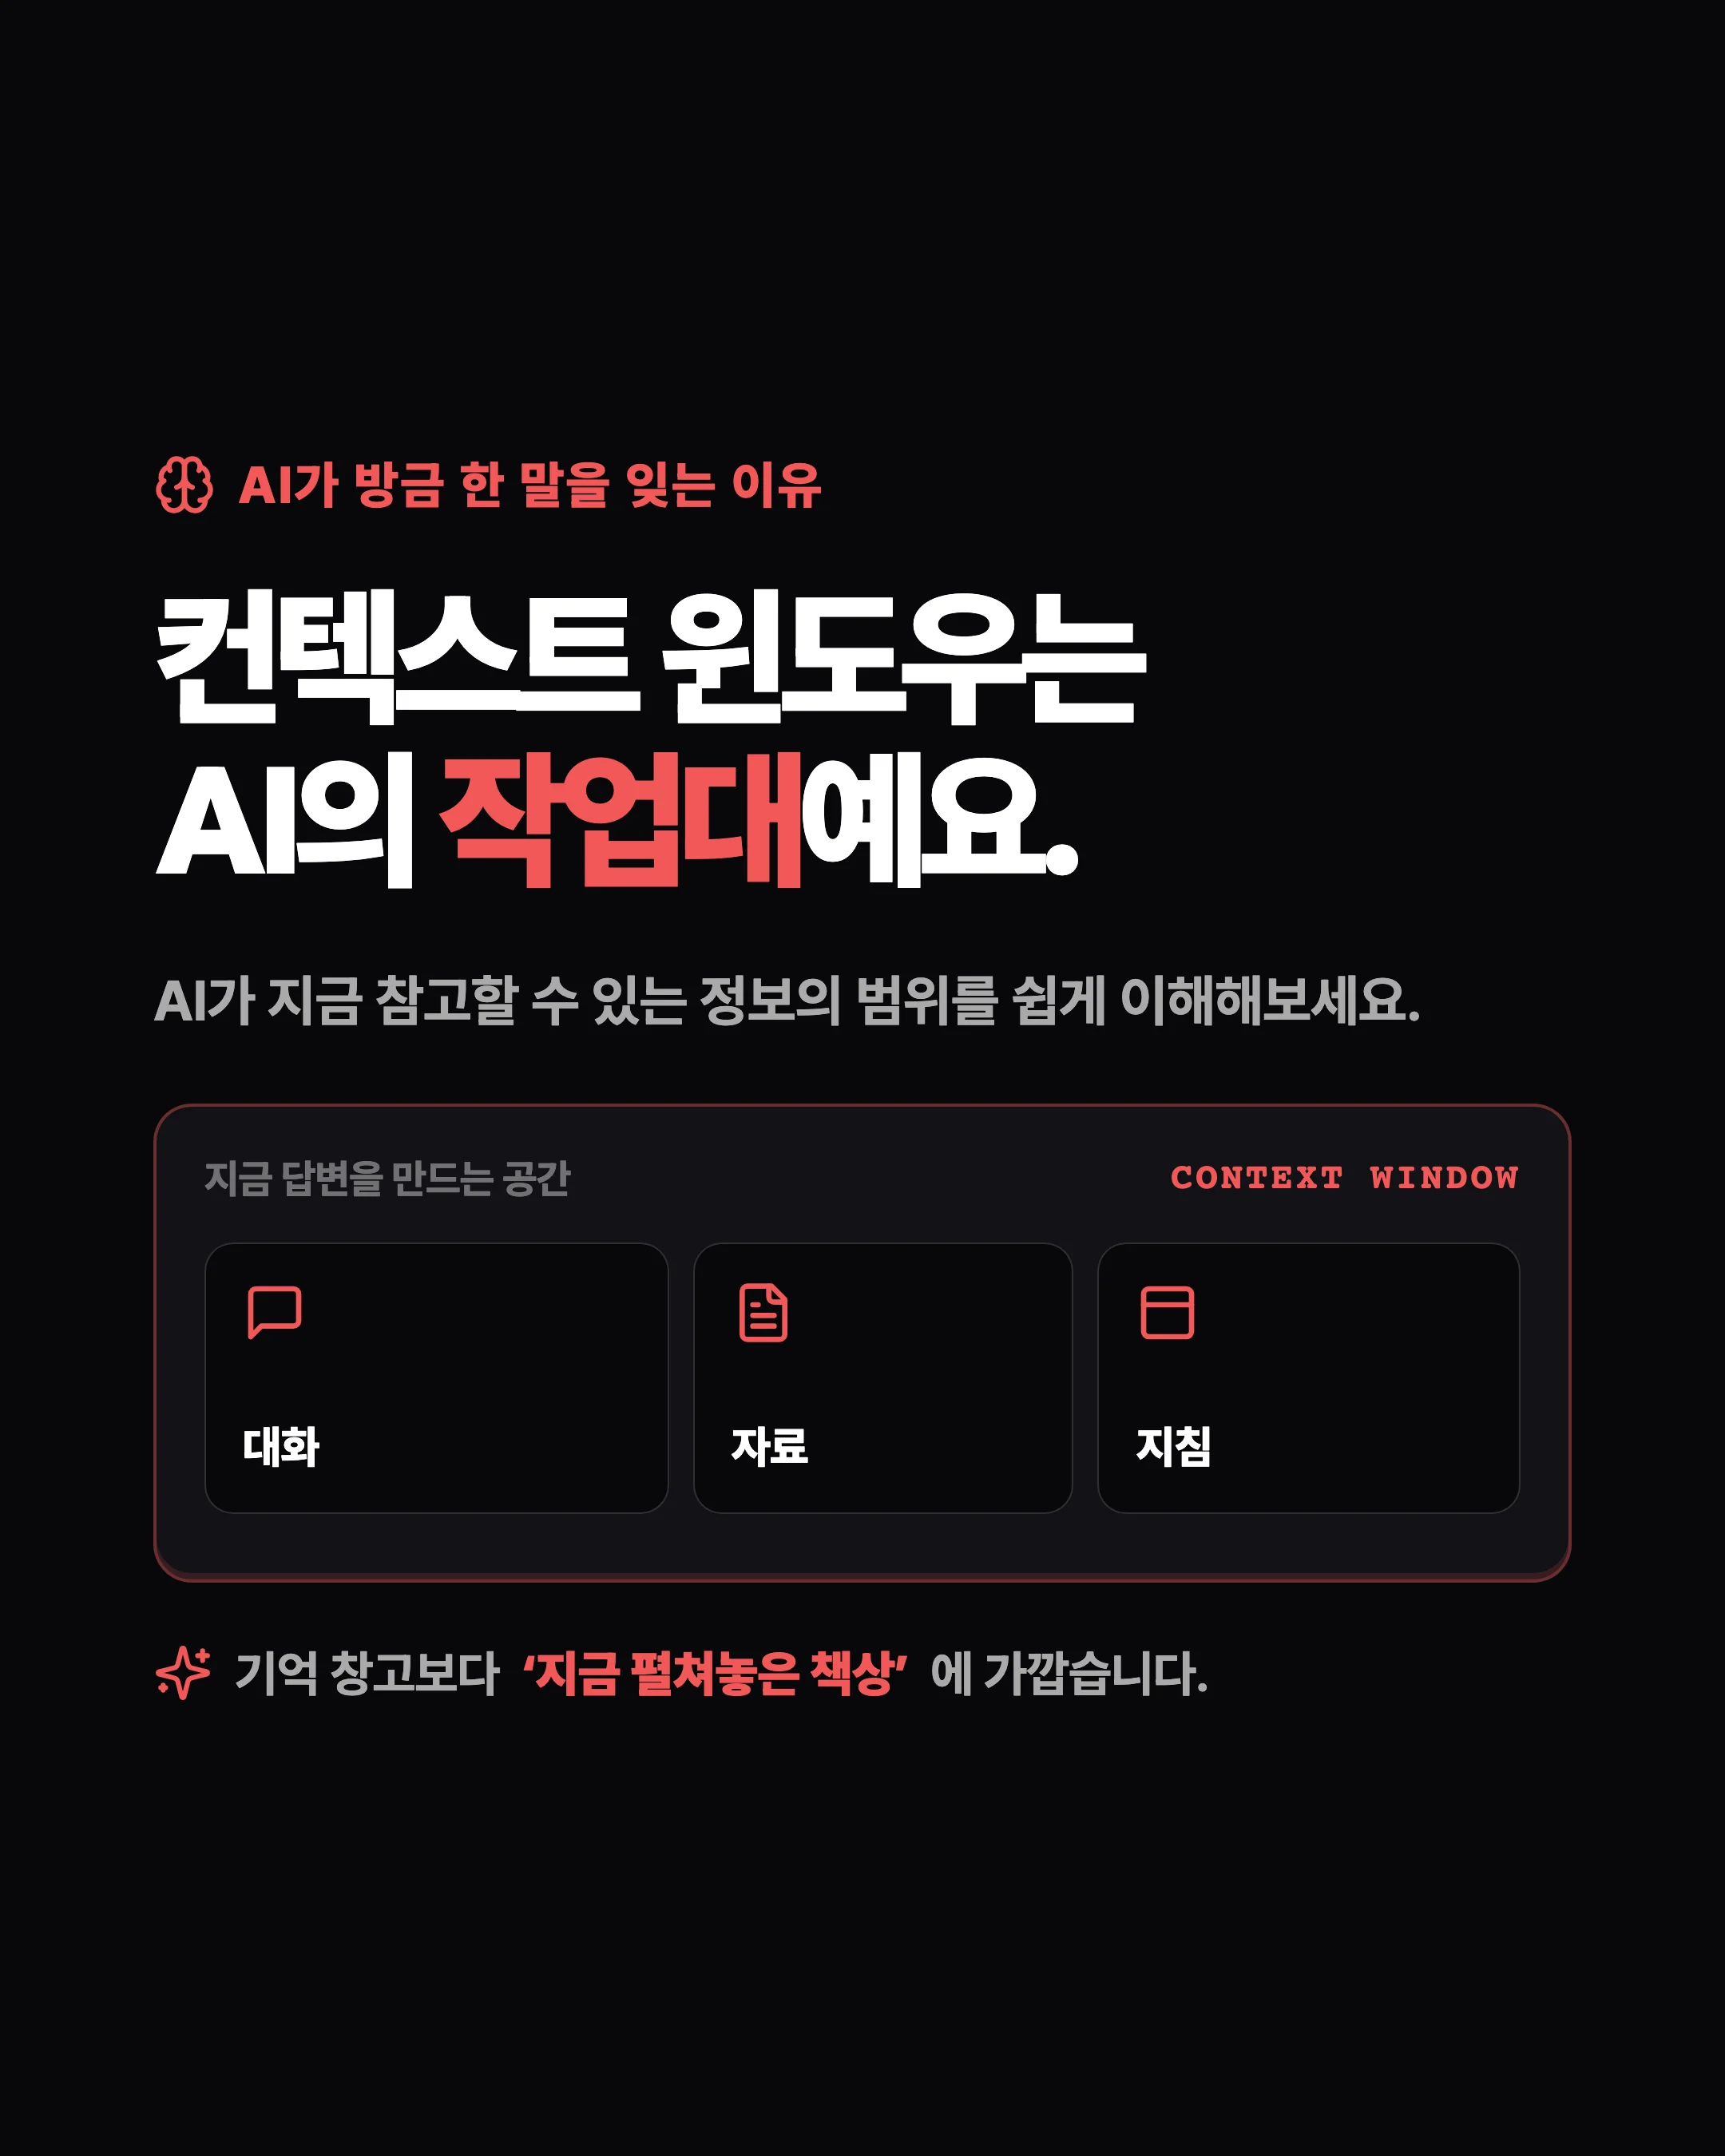
El problema radica en que, conforme se acumulan los turnos de la conversación, el tamaño de cada solicitud aumenta progresivamente. Este límite se denomina «ventana de contexto» (context window). Im Jae-hoo, autor del blog «Ttukttak Build», compara la ventana de contexto con una «mesa de trabajo» sobre un escritorio. En dicha mesa se colocan no solo la pregunta actual, sino también las conversaciones anteriores, los archivos adjuntos, las instrucciones predeterminadas, los resultados de la ejecución de herramientas y la respuesta que la IA está redactando 3. Del mismo modo que el espacio sobre un escritorio es limitado, la mesa de trabajo también posee un tope máximo, y su capacidad se mide en unidades denominadas «tokens». Los tokens son los fragmentos mínimos con los que la IA procesa el texto, y no guardan una correspondencia uno a uno con el número de caracteres 3.
Cuando se supera el límite, la estrategia para liberar espacio varía según el servicio. Según Im Jae-hoo, algunos productos excluyen ciertas partes antiguas de la mesa de trabajo, otros resumen brevemente los contenidos previos para reintegrarlos, otros seleccionan y recuperan únicamente fragmentos relevantes, y otros exigen iniciar una nueva conversación 3. Según la explicación de junhyunp.github.io, al llamar directamente a la API, la superación del límite se notifica explícitamente como un error; sin embargo, los servicios de chatbots resumen y eliminan automáticamente la parte inicial del historial para continuar la conversación sin mostrar ningún aviso al usuario 2. Como resulta imposible conocer qué hechos se han cortado, el usuario acaba preguntándose: «¿Por qué se ha olvidado de lo que dije hace un momento?».
El prompt del sistema permanece, pero los anécdotas se borran
Entonces, ¿por qué desaparecen las anécdotas y las experiencias de aventura mientras la personalidad del personaje se mantiene intacta? Esto se debe a que el grado de control sobre los elementos que ocupan la mesa de trabajo difiere entre sí. Según una tabla publicada en el blog junhyunp.github.io, el prompt del sistema (que define los roles y las reglas) se incluye de forma fija en cada solicitud y posee una alta posibilidad de ser controlado. Por el contrario, el registro de la conversación (todas las preguntas y respuestas hasta ese momento) puede ajustarse mediante el inicio de una nueva sesión o la aplicación de resúmenes 2. En otras palabras, la instrucción básica de la persona («Eres el entrenador Hanjwoo y tu compañero es Pikachu») se incluye de nuevo en cada solicitud, mientras que detalles narrativos específicos, como «Ayer batallaste en cierta ruta y conociste a una chica llamada Mao», están sujetos a recortes y compresión.
En los servicios de chat con personajes, estos recortes suelen obedecer a normas de gestión, más que a decisiones arbitrarias. Un documento compartido en notes.io, titulado «Directrices para la compresión y fusión de la memoria a largo plazo en el chat de personajes, 2.ª edición», ilustra este hecho. Dichas directrices limitan el cuerpo de texto del espacio de memoria a largo plazo a un máximo de 300 caracteres, incluyendo fechas, duraciones, espacios y signos de puntuación. Mientras que la compresión de primer nivel organiza los originales dispersos en múltiples fechas y escenas por eventos, la compresión de segundo nivel se define como una fase de optimización en la que se vuelve a leer múltiples recuerdos de eventos ya refinados para fusionarlos en unidades más grandes según arcos de sucesos, cambios en las relaciones, secretos y cambios de estado, reduciendo así el número de recuerdos 4.
La pregunta clave que estas directrices toman como criterio estándar es clara: «Si se elimina esta información, cambian realmente los hechos, las relaciones, las acciones o el estado de la información en el juego de rol posterior?» 4. Si no hay cambio, dicha información puede suprimirse o absorberse en otros recuerdos. Por ejemplo, se especifica que las «reacciones de personajes secundarios efímeros», los «movimientos, comidas o atuendos simples», los «detalles de procesos de eventos ya concluidos» y los «detalles de la secuencia de batallas o acciones» son candidatos a reducción 4. En cambio, los elementos clasificados como «anclas de preservación» —puntos de inflexión decisivos en los cambios de relación, promesas o condiciones vigentes en la actualidad, cabos sueltos sin resolver, cambios permanentes y ajustes confirmados por el usuario— no se eliminan salvo que queden claramente transferidos a otros recuerdos.
Es decir, el estado abstracto actual de «parece que estuvimos en batallas» se acerca a una ancla de preservación y, por tanto, se conserva, pero los detalles concretos de en qué ruta, contra quién y cómo se desarrollaron dichas batallas pueden convertirse en objetivos de fusión y eliminación. Las directrices también señalan explícitamente que «la rastreabilidad y la continuidad tienen prioridad sobre la reducción del número de memorias», estableciendo como criterio no la reducción incondicional de la información, sino la capacidad de la IA para reconstruir con precisión la información necesaria en los juegos de roles posteriores 4. Al colocar en la mesa de trabajo el resultado comprimido conforme a esta norma, la IA debe generar respuestas manteniendo el nombre y la personalidad básica del personaje, pero dejando vacíos los detalles de la aventura.
Las líneas de diálogo de Pikachu no son una invención de «razones» por parte de la IA
Si volvemos al diálogo de Hanjwoo, lo que sucede en esta escena resulta aún más evidente. El entrenador genera la frase «todo se ha vuelto en blanco» partiendo únicamente de una impresión abstracta de «haber participado en grandes batallas ayer». Esto no significa que la IA haya comprendido repentinamente su propio mecanismo de memoria para inventar un chiste. En la mesa de trabajo solo quedan la instrucción básica de la persona, un espacio narrativo vacío tras la compresión y los recortes, y la entrada del usuario. El modelo simplemente generó la siguiente oración más natural posible dentro de esa entrada. La situación del «vacío de memoria» ya existía dentro de las condiciones de entrada, y, conforme a la configuración del personaje, la reacción apropiada se manifestó como el diálogo de «se ha vuelto en blanco», el suspiro de Pikachu y su gesto de dejar caer una oreja 1.
El testimonio en el comentario «No es la primera ni la segunda vez que veo que le hacen un reseteo al cerebro» tampoco resulta exagerado bajo esta perspectiva 1. En una arquitectura sin estado, cuando la longitud de la conversación supera el límite, la eliminación silenciosa de la parte inicial no es un fallo del modelo, sino el funcionamiento básico del servicio 2. Los juegos de roles tienden a generar registros de conversación más extensos que las preguntas y respuestas ordinarias y, dado que la configuración del personaje y las reglas del mundo se fijan en el prompt del sistema, se cumplen las condiciones para que se repita la experiencia de «mantener la personalidad, pero reiniciar la narrativa».
No se puede eliminar el reinicio, pero sí reducir su frecuencia
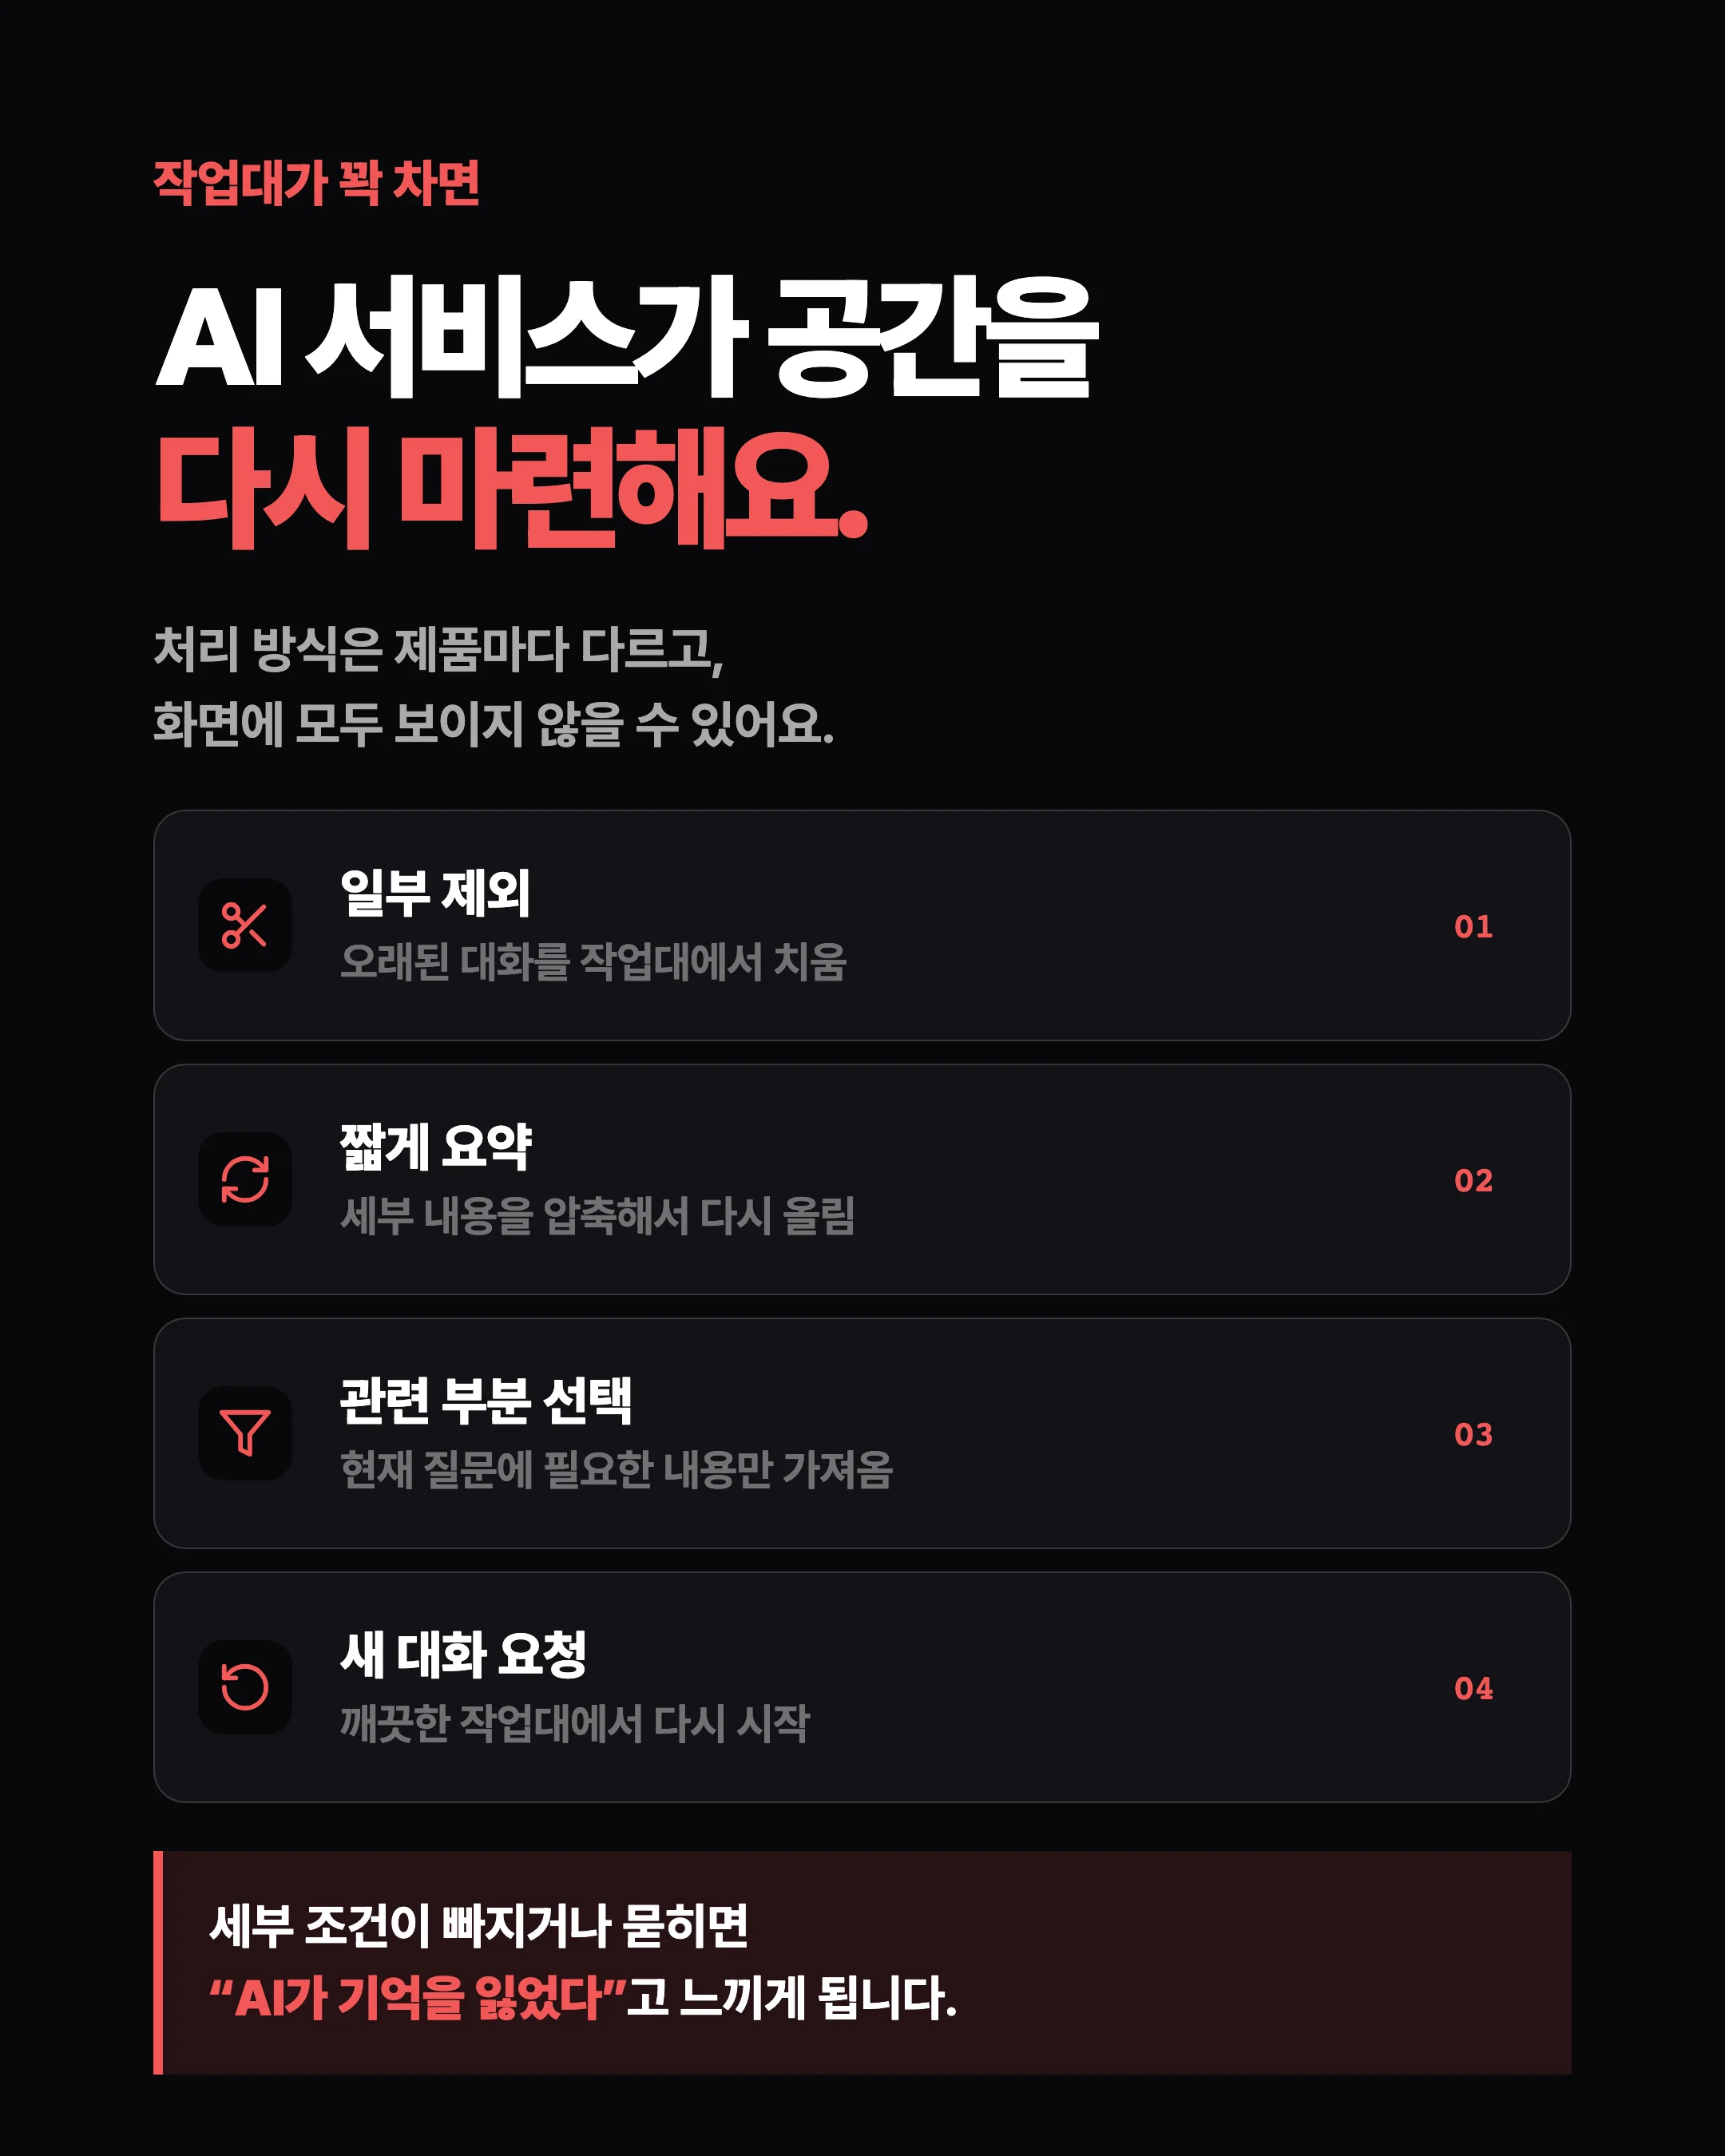
Conocer la estructura técnica permite establecer contramedidas claras. En primer lugar, existe una premisa importante: los métodos siguientes no eliminan la propia estructura del «reseteo de la memoria». Como la condición física del límite de la mesa de trabajo permanece invariable, el enfoque no está tanto en impedir totalmente los recortes como en reducir la «frecuencia de pérdida de información importante» y facilitar la recuperación posterior a dichos recortes.
Las estrategias prácticas pueden organizarse a partir de las recomendaciones de junhyunp.github.io y del blog «Ttukttak Build» 23. Si el tema cambia por completo o si las instrucciones antiguas siguen entrando en conflicto con los nuevos objetivos, conviene iniciar una nueva conversación para reducir tanto el registro irrelevante como los costos 23. Si la conversación se ha vuelto extensa, puede solicitarse un resumen del estado actual con una fórmula como: «Organiza lo que hemos confirmado hasta ahora, lo que aún no hemos decidido y las condiciones que se deben mantener también en la próxima respuesta» 23. Im Jae-hoo aconseja revisar personalmente el resultado de esta organización para detectar a tiempo posibles malentendidos de la IA y, posteriormente, abrir una nueva mesa de trabajo limpia en una conversación nueva basándose en dicho resumen, lo cual resulta más eficiente 3.
En tareas con múltiples ajustes obligatorios, como los juegos de roles con personajes, resulta eficaz mencionar de nuevo las condiciones clave en el último mensaje. Es más preciso volver a plantear brevemente las condiciones que deben cumplirse imperativamente que dar una orden vaga como «Hazlo como te dije al principio». Esto se debe a que, aunque algo se haya eliminado en la parte inicial, si permanece en los mensajes recientes, volverá a aparecer en la mesa de trabajo 23. Im Jae-hoo recomienda separar dichas condiciones en un bloque independiente, etiquetado como «condiciones de cumplimiento obligatorio», para evitar que queden mezcladas en el cuerpo del texto 3.
Existen también complementos a nivel de servicio. Los asistentes de IA como OpenClaw gestionan por separado la memoria de contexto de corto plazo, que desaparece al cerrar la sesión, y la memoria permanente de largo plazo, que se mantiene entre sesiones (MEMORY.md); asimismo, cuando las conversaciones extensas alcanzan el límite de tokens, el comando /compact resume el diálogo para conservar el contexto esencial 5. El uso de repositorios externos o la activación de funciones de memoria siguen la misma lógica. No obstante, incluso la información guardada en la memoria no es percibida por la IA si no se carga en la mesa de trabajo actual; por tanto, debe entenderse como independiente el hecho de guardarla y su empleo real 3.
Volvamos a la escena de Hanjwoo. Si el usuario hubiera querido continuar realmente con Pikachu el «contenido de las batallas de ayer», la vía más sencilla habría consistido, antes de escribir los diálogos, en volver a especificar explícitamente en la nueva mesa de trabajo condiciones como el primer encuentro con Mao, la chica rubia, las 3000 yenes de dinero de reserva actualmente en su posesión y las 5 Poké Balls vacías. Gracias a que la IA integró su vacío de memoria en la narración mediante el diálogo «se ha vuelto en blanco como si hubiera sido borrado con una goma de borrar», el usuario pudo sonreír llamándolo «reseteo del cerebro», y nosotros pudimos comprobar el suceso más intuitivo de lo que ocurre cuando se llena la mesa de trabajo 1. El personaje no actuó la pérdida de memoria; el resultado se produjo al rellenar la información ausente en la mesa de trabajo con los ajustes restantes. De ahora en adelante, el usuario podrá gestionar este vacío dejando las condiciones importantes en los mensajes recientes, usando resúmenes intermedios y retomando la conversación desde una nueva mesa de trabajo.
Referencias
- AI대화 피카츄 반응이 개웃기네 · arca.live↩
- [LLM] 컨텍스트 윈도우 — 대화가 길어지면 앞을 잊는 이유 · junhyunp.github.io↩
- 컨텍스트 윈도우란? AI의 작업대 이해하기 · ddukddak.build↩
- Notes - Online Notes Service · notes.io↩
- OpenClaw 메모리 리셋 해결 2026: memory 명령어로 AI 기억 복구 · vpn07.com↩