아마존이 대규모로 사용하던 내부 티켓 분류 시스템의 AI 비용을 약 98% 줄였습니다. 더 저렴한 대형 언어 모델을 선택한 것이 아닙니다. 같은 작업을 처리하면서도, AI에게 '긴 설명문(작문)'을 쓰게 하던 것을 '정답 한 단어(선택)'만 고르게 하는 방식으로 바꿨기 때문입니다.
출력 형식을 바꾸자 평균 처리 시간이 4초에서 1초 미만으로 줄었고, 100만 건당 비용은 약 22,200달러에서 500달러로 떨어졌습니다. 왜 출력이 줄어드는 것만으로 비용과 속도가 극적으로 개선될 수 있는지, 아마존 내부 티켓 시스템 팀(Carr·Mehul)이 공개한 사례를 통해 살펴보겠습니다. 1, 2
티켓 분류에 왜 '긴 분석문'이 필요했을까
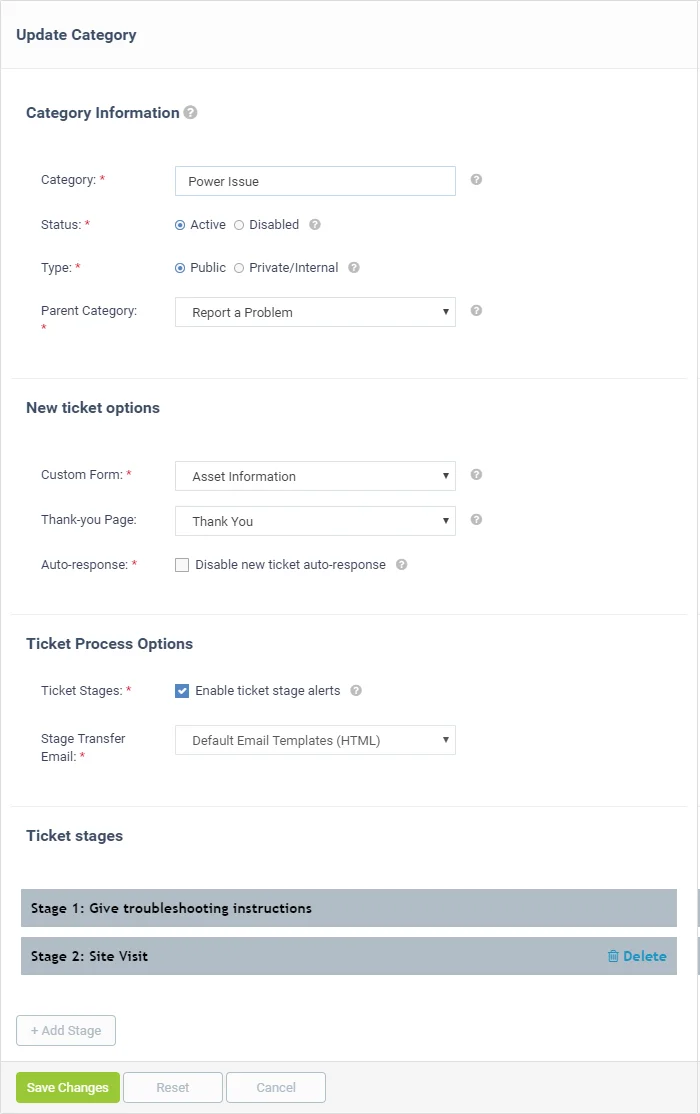
아마존의 내부 티켓 시스템은 고객 에스컬레이션, 서버 용량 요청, 자동 경보, 보안 발견 사항 등을 20개의 고정된 범주 중 하나로 분류하는 작업을 대규모로 처리합니다. 2
기존에는 'Claude Sonnet 4.6'이라는 대형 언어 모델(LLM)이 이 작업을 맡았습니다. AI는 티켓 내용을 분석하고, 왜 해당 라벨을 선택했는지에 대한 이유까지 포함한 복잡한 JSON 형식의 텍스트를 생성했습니다. 티켓 한 건당 AI가 출력하는 텍스트의 양(토큰)이 평균 170개에 달했습니다. 2
하지만 분류라는 업무의 본질을 뜯어보면 '주어진 20개 목록 중 하나를 고르는 것'입니다. 긴 글쓰기가 필요하지 않은 작업에 과도한 '작문'이 이루어지고 있었던 셈입니다. 대형 언어 모델은 보통 입력과 출력에 사용된 토큰 수에 비례해 요금이 부과됩니다. AI가 불필요한 설명을 길게 생성할수록 비용이 급격히 늘어나는 구조입니다. 2
텍스트 생성 장치를 잘라낸 '의사결정 모델'
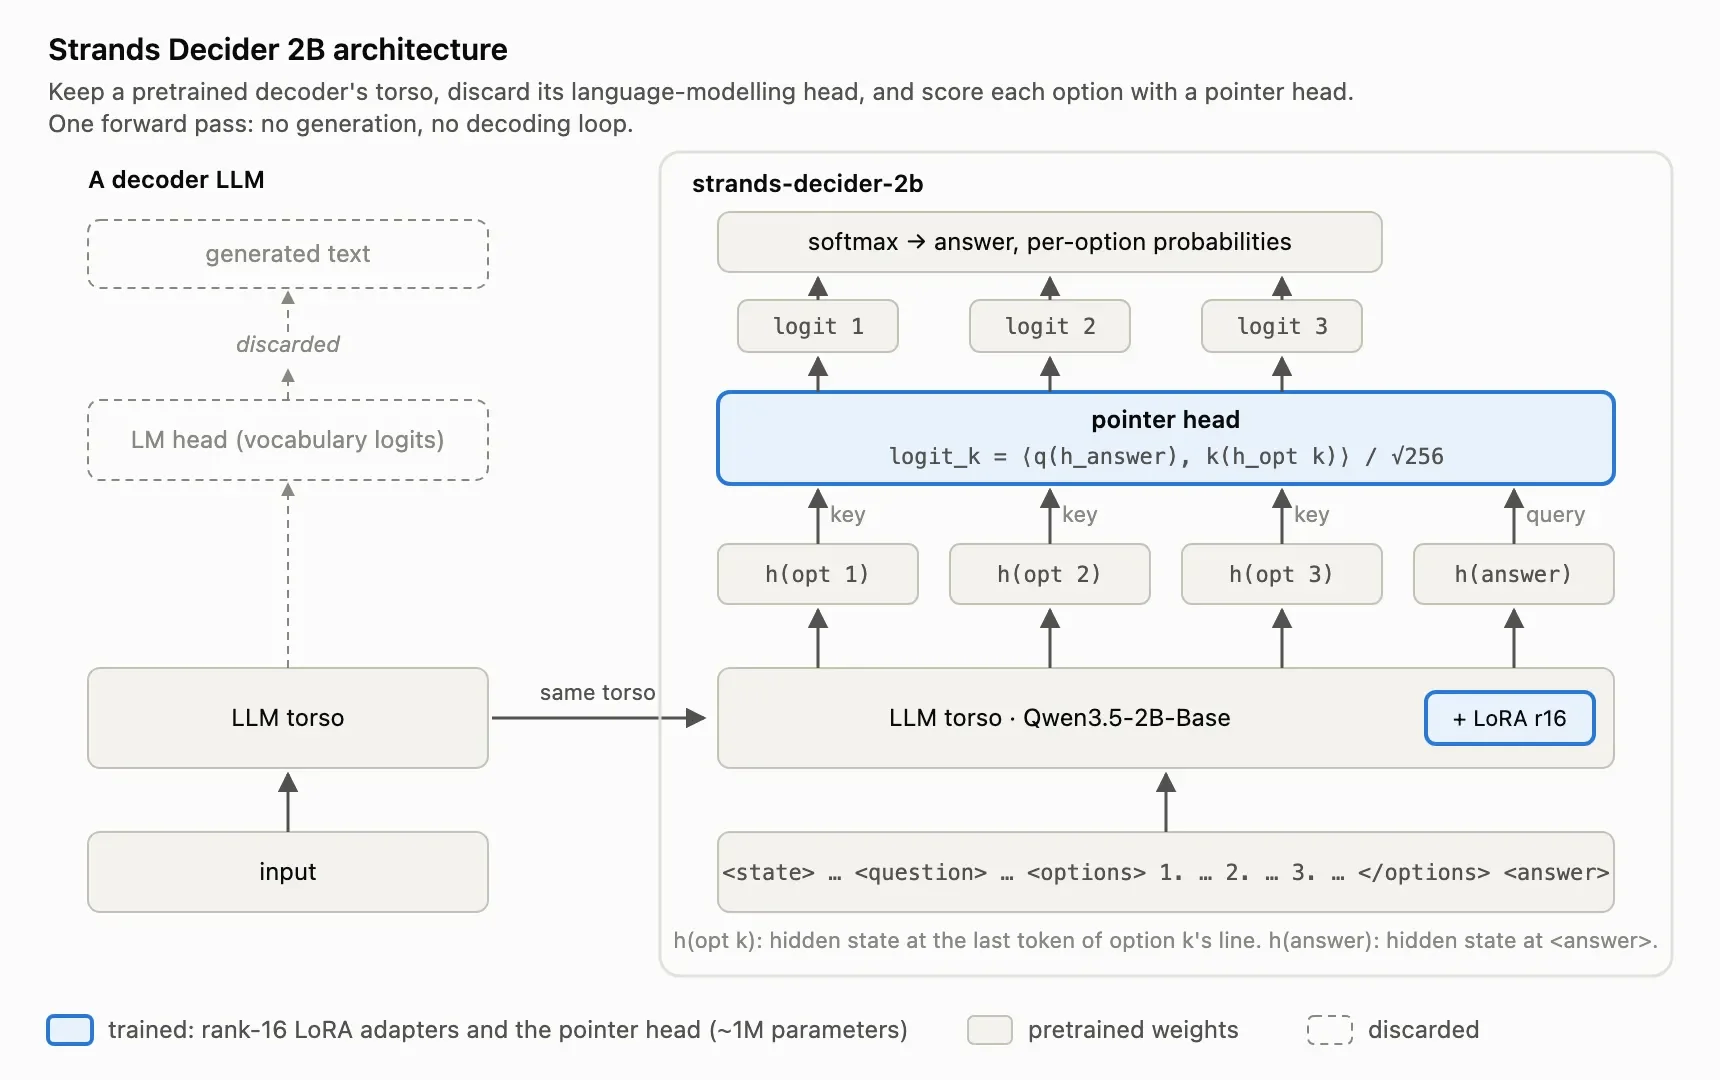
strandsagents.com 블로그를 통해 시스템 구조를 공개한 아마존 내부 엔지니어 팀은 'Strands Decider'라는 의사결정 모델로 시스템을 교체했습니다. 이 모델은 일반 생성형 AI와 내부 구조부터 다릅니다. 2, 3
일반적인 AI는 다음에 올 글자를 선택해 문장을 만들어내는 'LM 헤드(LM head)'라는 텍스트 생성 장치를 지닙니다. 반면, Strands Decider는 사전 학습된 언어 모델의 몸통(torso)에서 이 LM 헤드를 잘라냈습니다. 3
대신 각 선택지 후보에 점수를 매기는 '포인터 헤드(pointer head)'라는 작은 구조물을 붙였습니다. AI에게 답을 직접 써보라고 명령하는 대신, "A부터 T 중 어느 것이 가장 적합하고, 그 확률은 몇 퍼센트인가?"라고 묻고 확률과 신뢰도 점수만 계산하도록 만든 것입니다. 텍스트를 생성하지 못하기 때문에 목록 밖의 엉뚱한 답을 만들어낼 수 없으며, 글자 단위로 하나씩 글을 써 내려가는 과정이 사라져 처리 속도가 대폭 빨라집니다. 3
아마존 팀은 처음 2B 규모의 모델을 사용하다가 테스트에서 더 나은 결과를 보인 Gemma 4 기반의 'E4B' 모델로 전환해 운영했습니다. 2 참고로 E4B 모델은 JevBench v1이라는 공개 태스크 231개 평가에서 81.0%의 정확도를 기록했습니다. 4
입력 데이터 압축과 순서에 따른 변수 통제
출력 형식만 바꾼 것이 아닙니다. 입력 데이터 또한 모델의 처리 한계에 맞게 효율적으로 압축했습니다.
기존 운영 환경에 있던 20개 라벨의 상세한 설명문은 의사결정 모델의 최대 처리 용량인 4,096 토큰을 이미 초과하고 있었습니다. 따라서 이를 한두 문장 길이의 짧은 '판정 기준'으로 다시 작성했습니다. 또한 어느 목록에도 정확히 들어맞지 않는 티켓을 처리하기 위해 'none'이라는 선택지를 추가했습니다. 티켓 내용이 긴 경우 시스템이 가장 오래된 댓글부터 잘라내어 분량을 맞췄습니다. 2
데이터의 표기 순서가 결과를 바꾸는 현상도 발견했습니다. 내용상으로는 동일한 티켓 데이터라도 AI가 읽는 JSON 키의 정렬 순서가 바뀌기만 해도, 답으로 지목하는 확률이 최대 0.19까지 변동했습니다. 이를 해결하기 위해 아마존 팀은 모든 요청 데이터의 키 값을 알파벳 순서 등으로 미리 정렬하여 전달하는 방식을 채택했습니다. 2
종량제에서 고정비 구조로 바뀌어 98% 줄어든 비용 계산
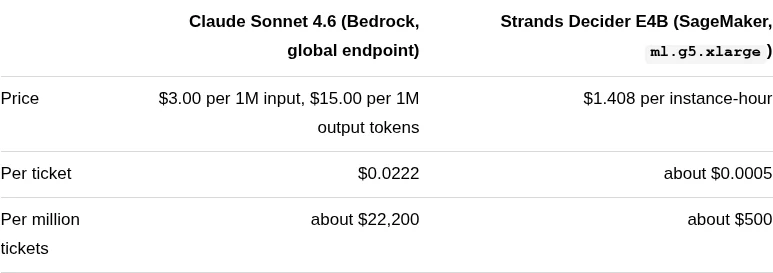
이러한 조정을 통해 티켓 분류 1건당 발생하는 비용이 크게 줄었습니다. 비용이 급감한 핵심 이유는 '과금 구조의 변화'에 있습니다.
| 비교 항목 | 기존: Claude Sonnet 4.6 | 교체: Strands Decider E4B |
|---|---|---|
| 평균 호출 시간 | 4,215 ms | 897 ms |
| 총 사용 토큰 | 6,724개 | 2,010개 |
| 출력 형식 | 평균 170개 토큰의 JSON | 선택지 1개 (1개 토큰) |
| 건당 비용 | $0.0222 | 약 $0.0005 |
| 100만 건당 비용 | 약 $22,200 | 약 $500 |
표 출처: Amazon 내부 티켓 분류 시스템 비교 자료 2
Claude Sonnet 4.6과 같은 대형 언어 모델 API는 '종량제'입니다. 입력 100만 토큰당 3달러, 출력 100만 토큰당 15달러가 부과됩니다. 따라서 출력량이 줄고 입력이 압축되면 비용이 줄어드는 것은 당연합니다. 2
반면, Strands Decider E4B를 구동하는 방식은 클라우드 서버 인스턴스(ml.g5.xlarge)를 시간당 비용을 내고 직접 운영하는 '고정비' 구조입니다. 이 서버 인스턴스의 시간당 비용은 1.408달러입니다. 1, 2
한 건당 처리 시간이 약 640ms(0.64초)에 불과하므로, 완전 가동 시 서버 하나가 한 시간당 약 5,600건의 티켓을 처리할 수 있습니다. 이 상태라면 100만 건당 단가는 250달러 수준까지 떨어집니다. 다만 실제 운영에서는 트래픽 급증에 대비한 여유 용량을 유지해야 하므로, 이를 모두 포함한 100만 건당 실제 비용은 약 500달러로 산출되었습니다. 2
AI가 얼마나 길게 글을 쓰는가에 따라 계산되는 '글자 수 비례 요금'에서 벗어나, 서버 가동 시간에 비례하는 '고정비' 체계로 바뀐 것이 연간 수백만 달러에 이를 것으로 예상되는 대규모 비용 절감으로 이어질 전망입니다. 1, 2
실제 트래픽에서의 이중화 검증 과정
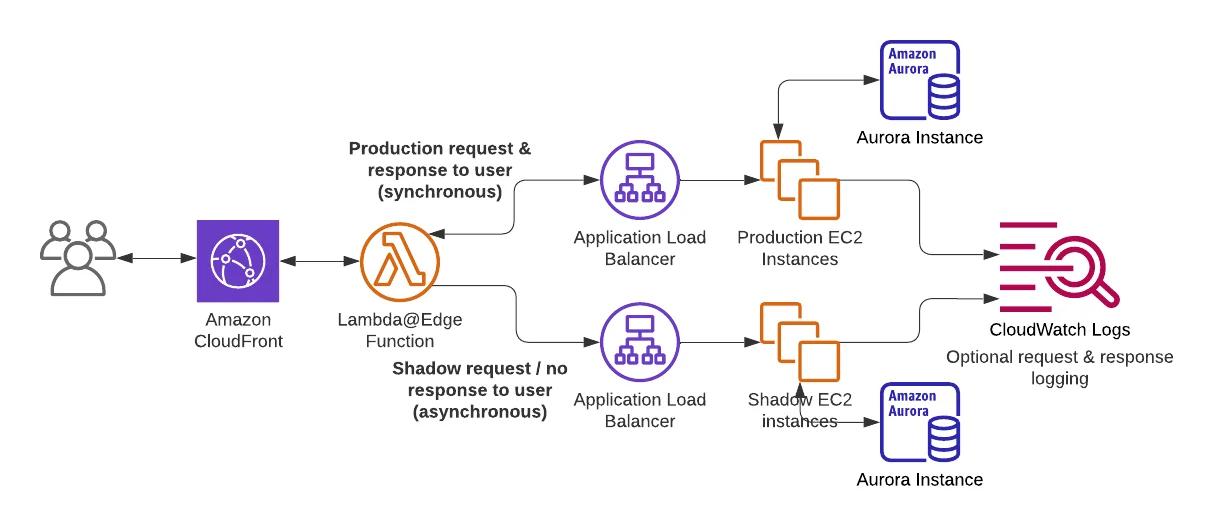
성능 지표가 좋다고 해서 운영 중인 시스템에 갑자기 새 모델을 적용하면 예상치 못한 오류가 발생할 수 있습니다. 아마존 팀은 시스템을 안전하게 전환하기 위해 'DUAL 모드'라는 이중화 구조를 도입했습니다. 2
DUAL 모드에서는 실제 고객 데이터가 기존 Sonnet 모델과 새로운 Decider 모델에 동시에 전달됩니다. 하지만 최종적으로 시스템에 적용되는 분류 결과는 기존 Sonnet의 것을 유지했습니다. 두 모델의 결과가 다를 경우에만 이를 별도 기록하여 분류 차이를 정밀하게 비교·분석했습니다. 아마존 엔지니어 팀은 이 과정을 거치며 오프라인 평가보다 더 많은 운영 정보를 얻을 수 있었다고 전합니다. 만약 새로운 모델에서 문제가 발생하더라도 설정 변경만으로 45초 만에 기존 시스템으로 즉시 복귀할 수 있는 안전장치를 마련해 두었습니다. 1, 2
한편, 신뢰도 임계값을 조정한 뒤 별도의 실제 티켓 집합으로 두 모델을 평가한 결과, Decider 모델이 운영 중인 Sonnet보다 더 좋은 분류 결과를 보였습니다. 1, 2
어떤 작업에 이 방식이 적용될 수 있을까
의사결정 모델 기반의 교체는 특정 조건에서 명확한 효율을 가져다줍니다. 아마존 팀이 공개한 자료에 따르면, 이 방식은 '미리 정해진 목록에서 하나를 고르는 폐쇄형 작업'이면서 '처리량이 방대하고', '대기 시간(지연)이 중요한' 환경에서 특히 효과적이었습니다. 1, 2
반면, 텍스트를 생성하지 않는 모델의 특성상 상세한 분석 문장 생성에는 부적합합니다. 분류 라벨에 긴 설명문이 필수적이거나, 목록이 매주 바뀝니다거나, 분류에 필요한 유용한 문맥이 수천 토큰의 처리 한계를 넘는 작업에는 대형 언어 모델을 대체하기 어려울 수 있습니다. 1, 2
AI에게 복잡한 추론과 긴 텍스트 작성을 지시할 필요 없이 정해진 목록에서 하나를 고르기만 하면 되는 폐쇄형 작업이면서, 처리량이 방대하고 기존 경로의 지연 시간이 중요한 환경이라면, 긴 문장 생성의 부담을 덜어내는 것이 비용과 속도 모두에서 큰 이점을 만듭니다. 1, 2
참고자료
- ↩
- Amazon saves millions by replacing Sonnet 4.6 with Strands Decider · strandsagents.com↩
- Introducing Strands Decider 2B: a small, open source, decision model · strandsagents.com↩
- Strands Decider adds four Gemma 4 models · strandsagents.com↩