Aunque dos modelos tengan una tasa de éxito promedio similar, los resultados al repetir las mismas tareas pueden ser diferentes. Que un modelo haya resuelto muchas tareas al menos una vez y que haya superado cinco veces consecutivas una misma tarea son cosas distintas. Al leer los benchmarks de los LLM que usan herramientas, si se pasa por alto esta diferencia, resulta difícil comprender cómo se distribuyen los éxitos y los fracasos incluso mirando las cifras en la tabla.
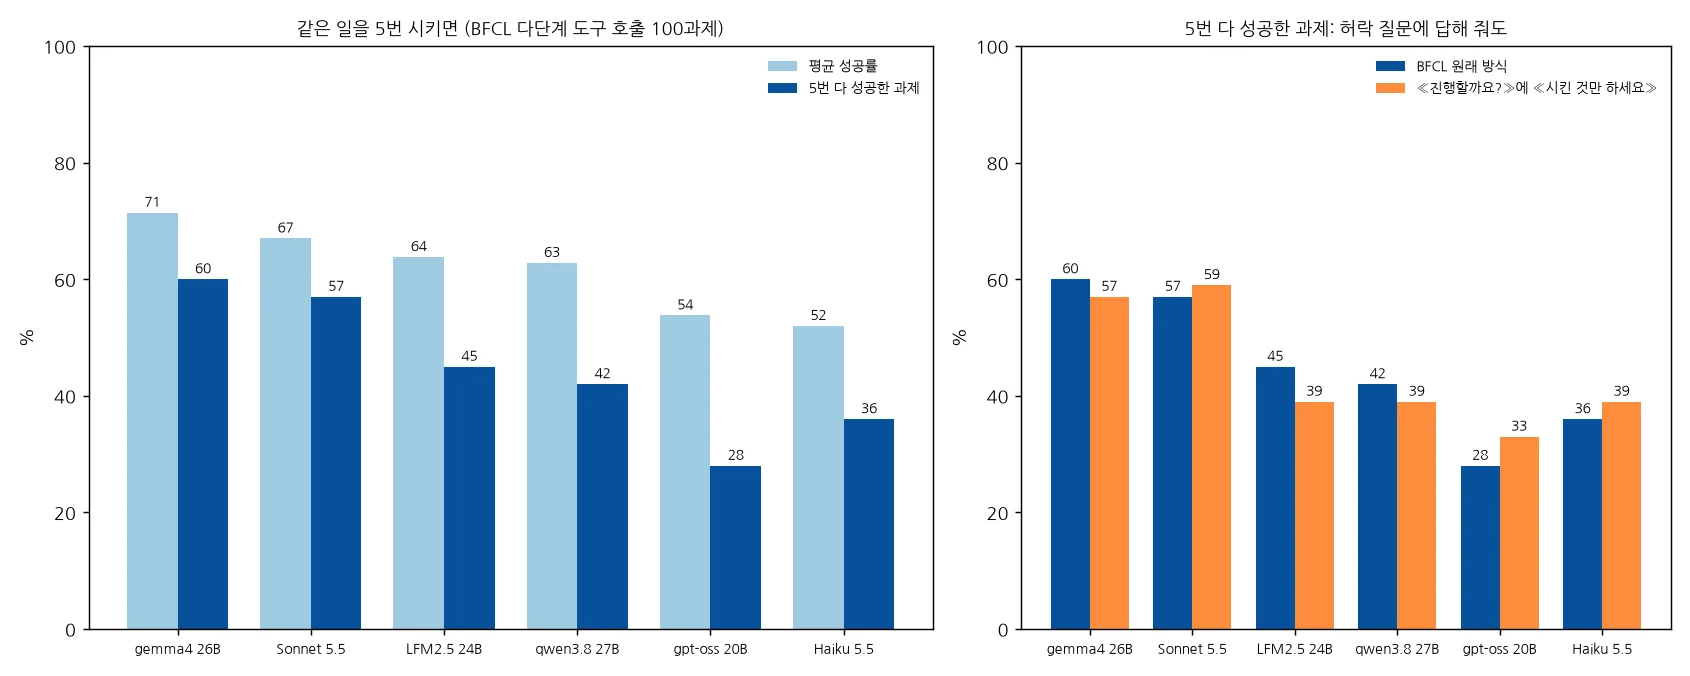
El autor del blog Bric (bric.pe.kr) evaluó cuatro modelos locales, ejecutados en una sola RTX 3090, y dos modelos a través de la API de Claude, realizando cada uno diez pruebas de cinco repeticiones sobre cien tareas de invocación de funciones BFCL1. Los resultados mostraron que la 'tasa de éxito promedio' y el 'número de tareas superadas en las cinco ocasiones' presentaban patrones diferentes. Aunque la tasa de éxito promedio de qwen3.8 27B fue del 62,8%, con una diferencia de aproximadamente 4 puntos porcentuales respecto a Claude Sonnet 5.5 (67,0%), el número de tareas superadas en las cinco ocasiones fue de 42 frente a 57, una brecha de 15 tareas1. Este artículo explica mediante cálculos y datos reales qué mide cada indicador y por qué es necesario analizarlos conjuntamente.
Los dos indicadores agregan las mismas 500 ejecuciones con unidades distintas
El experimento consistió en seleccionar 100 tareas, específicamente las numeradas con números pares, de las 200 tareas de nivelación multi_turn_base de BFCL (Berkeley Function Calling Leaderboard) v4, y ejecutar cada una cinco veces por modelo. En cada tarea, la solicitud del usuario se extiende entre una y seis iteraciones. El evaluador oficial de BFCL vuelve a ejecutar las funciones que llamó el modelo y compara el estado del sistema y los resultados de la ejecución con la solución correcta cada vez que finaliza una solicitud del usuario. Si existe discrepancia en alguna iteración, la tarea se considera fallida. Aunque el modelo indique verbalmente la finalización, la prueba se suspende si el estado no es el correcto. Por lo tanto, no debe interpretarse como un examen que evalúa únicamente el resultado final de toda la tarea1.
En este experimento, el número total de ejecuciones por cada modelo es de 100 tareas × 5 repeticiones = 500 ejecuciones. Los dos indicadores agregan los registros de estas 500 ejecuciones según criterios diferentes.
La tasa de éxito promedio se calcula dividiendo el número de ejecuciones exitosas por el total de 500. Por ejemplo, si 314 ejecuciones fueron exitosas, 314 ÷ 500 × 100 = 62.8%. Aquí, el número 314 representa la cantidad de ejecuciones, no que se hayan resuelto 314 tareas distintas. Pueden incluirse múltiples éxitos en la misma tarea. Con este único agregado, no es posible distinguir si los éxitos se concentran en ciertas tareas o se distribuyen entre varias.
El número de tareas superadas en las cinco ocasiones utiliza como denominador el número de tareas (100), no el de ejecuciones (500). Se cuentan las tareas que superaron las cinco ejecuciones sucesivas, y una tarea falla en el conteo si tiene algún fracaso. Es decir, indica la cantidad de tareas que mostraron estabilidad incluso bajo repeticiones. Adicionalmente, el autor agregaron también el 'número de tareas superadas al menos una vez' y el 'número de tareas con éxitos y fracasos alternados', subdividiendo así la estabilidad de las tareas1.
En resumen, la tasa de éxito promedio utiliza como denominador el 'número de ejecuciones', mientras que el número de tareas superadas en las cinco ocasiones utiliza como denominador el 'número de tareas'. Aunque ambos provienen de los mismos registros, al emplear unidades de agregado distintas, representan señales diferentes.
Incluso con promedios similares, el éxito consistente puede variar notablemente
Para entender por qué divergen estos indicadores, analicemos un ejemplo hipotético más simple que los datos reales. Los siguientes cálculos no son resultados medidos del blog Bric, sino supuestos creados para explicar la diferencia entre los indicadores.
Supongamos que se ejecutan cinco veces cada una de tres tareas, realizando un total de 15 ejecuciones. El número de éxitos por tarea para el modelo hipotético A es 5, 5 y 0, mientras que para el modelo hipotético B es 4, 3 y 3.
| Tarea | Éxitos del modelo A | Éxitos del modelo B |
|---|---|---|
| Tarea 1 | 5 / 5 | 4 / 5 |
| Tarea 2 | 5 / 5 | 3 / 5 |
| Tarea 3 | 0 / 5 | 3 / 5 |
| Total | 10 / 15 | 10 / 15 |
Dado que ambos modelos tuvieron 10 éxitos de 15 ejecuciones, la tasa de éxito promedio es la misma, aproximadamente 66,7%. Sin embargo, el número de tareas superadas en las cinco ocasiones es de 2 para A y de 0 para B. En este registro hipotético, A aprobó consistentemente dos tareas y falló consistentemente en otra. B aprobó al menos una vez todas las tareas, pero fracasó en varias ocasiones en cada una. Detrás de los mismos totales se encuentran distribuciones diferentes. Este ejemplo describe los 15 registros dados y no garantiza éxitos en ejecuciones futuras.
Inversamente, si A hubiera presentado el patrón de 5/5, 4/5 y 1/5, la tasa de éxito promedio seguiría siendo del 66,7%, pero el número de tareas superadas en las cinco ocasiones se reduciría a 1. Es decir, el número de éxitos consecutivos responde con sensibilidad a la distribución de los éxitos, pero la tasa de éxito promedio no refleja dicha distribución. Si el promedio muestra 'cuántas ejecuciones pasaron', el número de éxitos consecutivos muestra 'cuántas tareas pasan las repeticiones'.
Lectura conjunta de los valores medidos para Sonnet y qwen
Antes de leer los valores medidos reales, también debemos distinguir las condiciones de ejecución. Los modelos locales se ejecutaron en una sola RTX 3090 con Ollama 0.40.13, una longitud de contexto de 32k y cambiando la semilla aleatoria en cada repetición. Los modelos de Claude se ejecutaron a través de la API de Anthropic con temperatura 1,0 y sin pensamiento extendido. No se debe interpretar que la modificación de la semilla aleatoria del lado local se aplicó igualmente a la API de Claude. Además, los valores de LFM2.5 en el texto original corresponden a nuevas mediciones con temperatura 1,0 en lugar de la temperatura básica de 0,1. No todas las filas utilizaron la configuración por defecto de cada modelo1.
| Modelo | Entorno de ejecución | Tasa de éxito promedio | Éxito al menos una vez | Éxito en las 5 ocasiones | Éxito y fracaso alternados |
|---|---|---|---|---|---|
| Claude Sonnet 5.5 | API | 67,0% | 76 | 57 | 19 |
| qwen3.8 27B | Local RTX 3090 | 62,8% | 83 | 42 | 41 |
La diferencia en la tasa de éxito promedio entre Sonnet y qwen es de 4,2 puntos porcentuales, y la diferencia en el número de tareas superadas en las cinco ocasiones es de 15. En cuanto a las tareas superadas al menos una vez, qwen lidera con 83 frente a los 76 de Sonnet. De los seis modelos del texto original, el máximo valor en esta columna también corresponde a los 83 de qwen1. Por lo tanto, en una columna, qwen resolvió más tareas, mientras que en otra columna, Sonnet superó en las cinco ocasiones más tareas. Dependiendo de qué columna se lea, cambia la pregunta misma.
Si restamos los dos números de tareas, podemos obtener también el número de tareas con resultados mixtos de éxito y fracaso. Para Sonnet es 76 - 57 = 19개 y para qwen 83 - 42 = 41개. Inversamente, restando el número de éxitos al menos una vez de 100, podemos ver que las tareas que nunca superaron los cinco intentos fueron 24 y 17, respectivamente. Todos estos valores clasficaron las mismas 100 tareas. Aquí, 83 representa el rango de éxito observado y no el límite superior de todas las tareas que el modelo puede resolver.
No se puede afirmar que la confiabilidad en servicios reales sea un número específico de veces superior por el mero ratio entre 57 y 42, ya que estamos midiendo el número de tareas superadas en las cinco ocasiones en un conjunto específico de 100 tareas. El texto original también declara las limitaciones de usar solo tareas en inglés y limitar las repeticiones a cinco. Si se aumentan las repeticiones, el número de tareas superadas en todas las ocasiones podría reducirse1. Esta tabla muestra los resultados en el ámbito medido, y no garantiza resultados similares para otros trabajos o instrucciones en español.
También es necesario distinguir las condiciones experimentales al leer los registros de fracaso
Debemos distinguir entre confirmar las diferencias numéricas y explicar sus causas. No se puede juzgar que un resultado es fallido solo porque el orden de invocación de funciones fue distinto. Los criterios de evaluación en este examen son el estado del sistema y los resultados de ejecución verificados por cada solicitud. Si se alcanza el mismo estado y resultado, la ruta de llamada no tiene que ser idéntica. Por el contrario, aunque la respuesta final parezca natural, se considera fracaso si el estado se desvió en alguna de las solicitudes intermedias1.
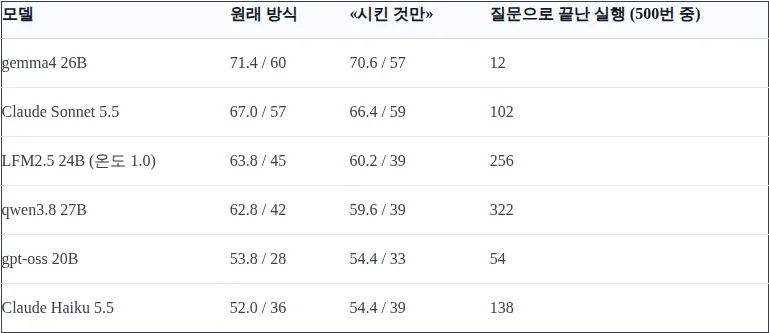
El autor del texto original, al observar casos en los que el modelos solicitaban confirmación al usuario en lugar de continuar la ejecución, también realizó un experimento adicional respondiendo a las preguntas. Inicialmente, la respuesta era simplemente una aceptación, pero se descubrió que este método también conllevaba el efecto de aceptar trabajos adicionales no solicitados originalmente. Luego, se volvió a medir con respuestas del usuario que indicaban ejecutar solo lo solicitado. Esto no implicaba cambiar el prompt del sistema del modelo, sino que era una condición con respuestas posteriores del usuario gestionadas por el lado de ejecución1.
Los 322 registros de cierre por pregunta de qwen mencionados en el texto original se refieren a la agregación de 500 ejecuciones bajo esta condición de respuesta posterior. No debe leerse junto con la tasa inicial promedio de 62,8% y los 42 éxitos en las cinco ocasiones como si fueran columnas de la misma condición. La detección de preguntas se basa en reglas de coincidencia de patrones fijos, incluyendo oraciones que proponen otras tareas. El autor explica que la suposición de que los modelos que preguntan se perjudican en la puntuación no es respaldada por estos datos1. Esta es la razón por la que no se puede atribuir la totalidad de la diferencia en la tasa de éxito solo a la cantidad de preguntas.
Por otro lado, el autor también presenta casos donde Sonnet incluyó títulos y formatos no solicitados al crear documentos, provocando que los archivos resultantes diferiran de los archivos vacíos esperados. Se especificó que, aunque esto ocurrió en las cinco repeticiones de esa tarea específica, no se contó cuántas veces se repetía este fracaso en el conjunto total1. Los registros individuales ayudan a comprender por qué una evaluación se consideró fallida. Sin embargo, no es posible generalizar un único ejemplo para explicar las diferencias de rendimiento en todas las tareas.
Al leer los tres valores conjuntamente, el significado de la evaluación se vuelve claro
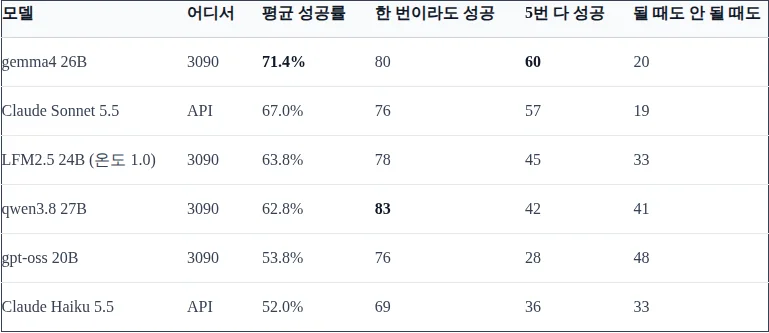
De esta comparación, lo más útil a extraer es el orden de lectura de la tabla, más que un eslogan para elegir un modelo. Primero, confirme que la tasa de éxito promedio representa la proporción de aprobaciones sobre el total de ejecuciones; luego, observe en paralelo las tareas superadas al menos una vez y las superadas en todas las ocasiones. Incluyendo el número de tareas con resultados mixtos, es posible leer la distribución que un solo promedio ocultaba. Es incorrecto escribir que los 41 casos de qwen son el máximo entre todos los modelos. En el texto original existe gpt-oss 20B con 48 casos de este tipo1.
Finalmente, se debe verificar qué tipo de ejecuciones incluyen dichos valores. El texto original cuenta como fracaso tanto los errores de la herramienta de ejecución local al procesar respuestas como los errores de conexión con la API de Claude1. Por lo tanto, no se pueden atribuir todos los fracasos agregados a la falta de comprensión del problema por parte del modelo. Para delimitar claramente el alcance de los números, es necesario leer no solo los nombres de los modelos y sus puntuaciones, sino también el entorno de ejecución, la presencia de respuestas posteriores y el método de contabilización de errores.
La tasa de éxito promedio muestra el total de las ejecuciones agregadas, mientras que el número de tareas superadas en las cinco ocasiones agrupa los registros de repeticiones en las mismas tareas. Ninguno de los dos sustituye al otro. Si se han leído los 67,0% de Sonnet y los 62,8% de qwen, la forma de comprender mejor este benchmark es mirar también los 57 frente a 42 casos de éxito consecutivo y los 76 frente a 83 casos de éxito parcial. Basta con distinguir los denominadores, verificar la distribución de los éxitos e interpretar los resultados dentro de las condiciones medidas.



