평균 성공률이 비슷한 두 모델이라도 같은 과제를 반복했을 때의 결과는 다를 수 있습니다. 한 번이라도 풀어 본 과제가 많다는 것과, 같은 과제를 다섯 번 연속 통과했다는 것도 서로 다른 이야기입니다. 도구를 사용하는 LLM의 벤치마크를 읽을 때 이 차이를 놓치면, 표 안에 있는 숫자를 보고도 성공과 실패가 어떻게 분포하는지 알기 어렵습니다.
브릭 블로그(bric.pe.kr) 저자는 RTX 3090 한 장에서 구동되는 로컬 모델 4종과 Claude API 2종을 BFCL 도구 호출 과제 100개에 대해 5회씩 실행해 채점했습니다1. 그 결과 '평균 성공률'과 '5번 모두 성공한 과제 수'는 서로 다른 양상을 보였습니다. qwen3.8 27B의 평균 성공률은 62.8%로 Claude Sonnet 5.5(67.0%)와 약 4%p 차이였지만, 5번 모두 성공한 과제 수는 42개 대 57개로 15개 차이가 났습니다1. 두 지표가 각각 무엇을 측정하는지, 그리고 왜 이 둘을 함께 봐야 하는지 계산 과정과 실제 데이터를 통해 설명합니다.
두 지표는 같은 500회 실행을 서로 다른 단위로 집계합니다
실험은 BFCL(Berkeley Function Calling Leaderboard) v4의 다단계 과제 multi_turn_base 200개 중 짝수 번호 100개를 골라 모델마다 5번씩 수행한 것입니다. 각 과제에서는 사용자 요청이 1~6번 이어집니다. BFCL 공식 채점기는 모델이 호출한 함수를 다시 실행하고, 사용자 요청 하나가 끝날 때마다 시스템 상태와 실행 결과를 정답과 비교합니다. 한 번이라도 다르면 그 과제는 실패입니다. 모델이 말로 완료했다고 해도 상태가 틀리면 통과하지 못합니다. 따라서 과제 전체의 마지막 결과만 맞추는 시험으로 읽어서는 안 됩니다1.
이 실험에서 모델 하나의 총 실행 횟수는 100개 과제 × 5회 = 500회입니다. 두 지표는 이 500회의 로그를 서로 다른 기준으로 집계합니다.
평균 성공률은 500회 실행 중 성공한 횟수를 500으로 나눈 값입니다. 가령 314회가 성공했다면 314 ÷ 500 × 100 = 62.8%입니다. 여기서 314는 실행 횟수이고, 서로 다른 과제 314개를 풀었다는 뜻이 아닙니다. 같은 과제의 성공이 여러 번 포함될 수 있습니다. 이 집계만으로는 성공이 특정 과제에 몰렸는지, 여러 과제에 흩어졌는지 구별할 수 없습니다.
5번 모두 성공한 과제 수는 분모가 실행 횟수(500)가 아니라 과제 수(100)입니다. 같은 과제를 5번 실행해 5번 모두 통과한 과제를 세고, 한 번이라도 실패하면 그 과제는 카운트되지 않습니다. 즉, '반복 실행에서도 흔들리지 않은 과제'의 개수를 나타냅니다. 저자는 이에 더해 '한 번이라도 성공한 과제 수'와 '성공과 실패가 섞인 과제 수'를 함께 집계해 과제의 안정성을 세분화했습니다1.
요약하면 평균 성공률은 '실행 횟수'를 분모로 하고, 5번 모두 성공 과제 수는 '과제 수'를 분모로 합니다. 같은 로그에서 나오더라도 집계 단위가 다르므로 두 값은 서로 다른 신호를 나타냅니다.
평균이 같아도 반복 성공은 크게 다를 수 있습니다
두 지표가 왜 갈라지는지 이해하기 위해 실제 데이터보다 단순한 가상 예시를 들여다보겠습니다. 아래 계산은 브릭 블로그의 실측 결과가 아니라, 지표의 차이를 설명하기 위해 만든 가정입니다.
과제 3개를 각각 5번씩 실행해 총 15회를 수행했다고 가정해 봅니다. 가상 모델 A의 과제별 성공 횟수는 5, 5, 0이고, 가상 모델 B는 4, 3, 3입니다.
| 과제 | 모델 A 성공 횟수 | 모델 B 성공 횟수 |
|---|---|---|
| 과제 1 | 5 / 5 | 4 / 5 |
| 과제 2 | 5 / 5 | 3 / 5 |
| 과제 3 | 0 / 5 | 3 / 5 |
| 합계 | 10 / 15 | 10 / 15 |
두 모델 모두 15회 중 10회가 성공했으므로 평균 성공률은 약 66.7%로 동일합니다. 그러나 5번 모두 성공한 과제는 A가 2개, B는 0개입니다. 이 가상 기록에서 A는 두 과제를 매번 통과하고 다른 한 과제는 매번 실패했습니다. B는 모든 과제를 한 번 이상 통과했지만 각 과제에서 실패도 나왔습니다. 같은 합계 뒤에 서로 다른 분포가 있는 셈입니다. 이 예시는 주어진 15회 기록을 설명하며, 다음 실행의 성공을 보장하지 않습니다.
반대로 A가 5/5·4/5·1/5의 패턴을 보였다면 평균 성공률은 여전히 66.7%지만 5번 모두 성공한 과제는 1개로 줄어듭니다. 즉, 5번 모두 성공 수치는 성공의 배분에 민감하게 반응하지만, 평균 성공률은 그 분포를 반영하지 못합니다. 평균이 '얼마나 많은 실행이 통과했는가'를 보여준다면, 5번 모두 성공은 '얼마나 많은 과제가 반복을 통과하는가'를 보여줍니다.
Sonnet과 qwen의 측정값을 함께 읽기
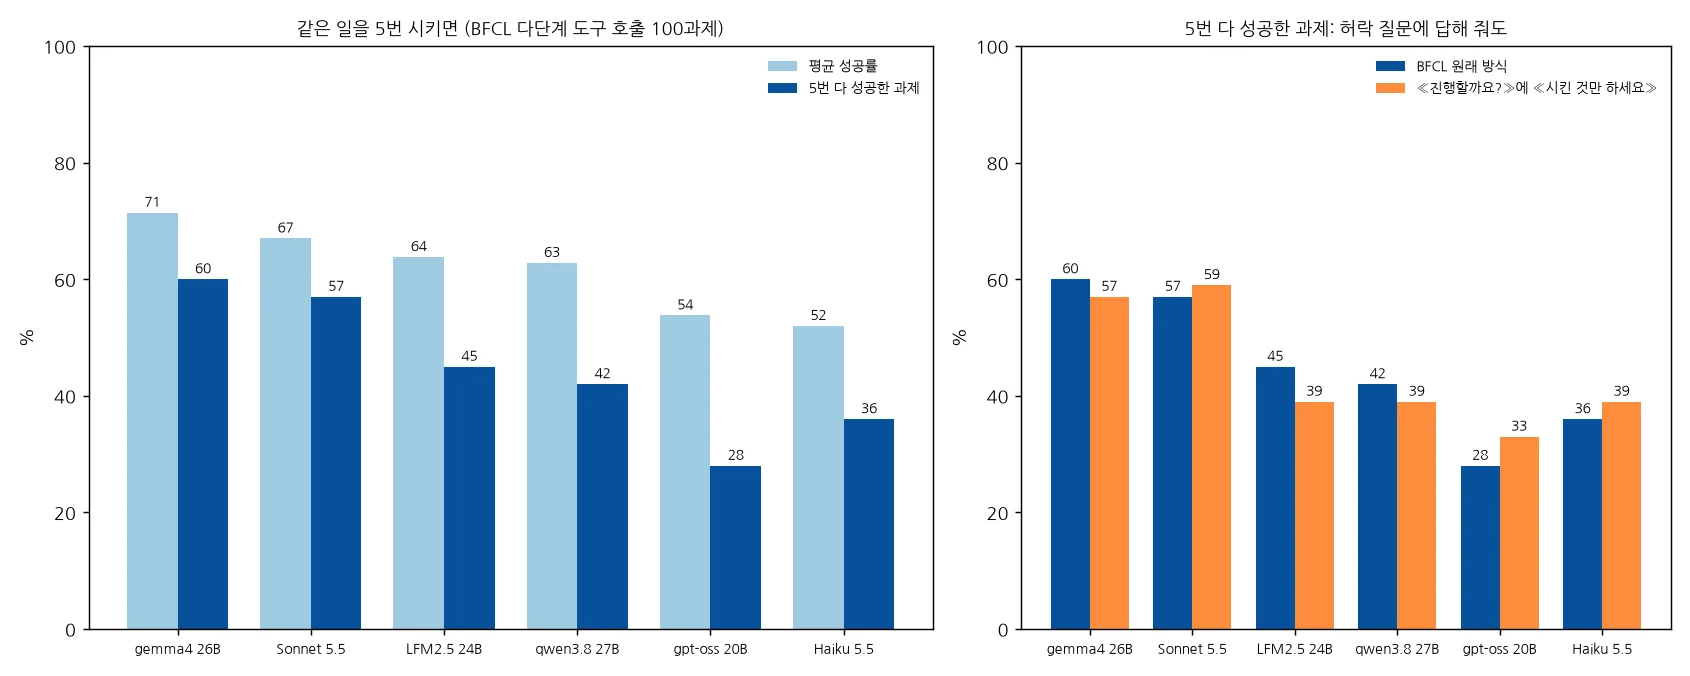
실제 측정값을 읽기 전에는 실행 조건도 구분해야 합니다. 로컬 모델은 RTX 3090 한 장과 Ollama 0.40.13, 문맥 길이 32k에서 실행했고 반복마다 seed를 바꿨습니다. Claude 모델은 Anthropic API에서 온도 1.0, 확장 사고 없이 실행했습니다. 로컬 쪽 seed 변경을 Claude API에도 적용한 것으로 읽으면 안 됩니다. 또 원문의 LFM2.5 표 값은 기본 온도 0.1 대신 1.0으로 다시 잰 결과입니다. 모든 행이 각 모델의 기본 설정을 그대로 쓴 것은 아닙니다1.
| 모델 | 실행 환경 | 평균 성공률 | 한 번이라도 성공 | 5번 다 성공 | 성공·실패 혼재 |
|---|---|---|---|---|---|
| Claude Sonnet 5.5 | API | 67.0% | 76 | 57 | 19 |
| qwen3.8 27B | RTX 3090 로컬 | 62.8% | 83 | 42 | 41 |
Sonnet과 qwen의 평균 성공률 차이는 4.2%p이고, 5번 모두 성공한 과제 수는 15개 차이입니다. 한 번이라도 성공한 과제는 반대로 qwen이 83개로 Sonnet의 76개보다 많습니다. 원문의 여섯 모델 가운데 이 열의 최댓값도 qwen의 83개입니다1. 따라서 한 열에서는 qwen이 더 많은 과제를 풀었고, 다른 열에서는 Sonnet이 더 많은 과제를 다섯 번 모두 통과했습니다. 어느 열을 읽느냐에 따라 질문 자체가 달라집니다.
두 과제 수를 빼면 성공과 실패가 섞였던 과제 수도 구할 수 있습니다. Sonnet은 76 - 57 = 19개, qwen은 83 - 42 = 41개입니다. 반대로 100에서 한 번이라도 성공한 수를 빼면, 이번 다섯 번의 실행에서 한 번도 통과하지 못한 과제가 각각 24개와 17개였음을 알 수 있습니다. 모두 같은 100개 과제를 분류한 값입니다. 여기서 83개는 관측된 성공 범위이며 모델이 풀 수 있는 모든 과제의 상한선이 아닙니다.
57개와 42개를 나눠 실제 서비스의 신뢰성이 몇 배라고 말할 수도 없습니다. 지금 센 것은 특정 100개 과제에서 다섯 번 모두 성공한 과제의 수이기 때문입니다. 원문도 한 종류의 영어 과제를 사용했고 반복은 다섯 번뿐이라는 한계를 밝힙니다. 더 많이 반복하면 모두 성공하는 과제 수는 줄어들 수 있습니다1. 이 표는 측정한 범위의 결과를 보여주며, 다른 업무나 한국어 지시까지 같은 결과가 나온다는 보장은 하지 않습니다.
실패 기록을 읽을 때도 실험 조건을 구분해야 합니다
숫자의 차이를 확인하는 일과 그 원인을 설명하는 일은 구분해야 합니다. 함수 호출 순서가 달랐다는 사실만으로 실패라고 판단할 수는 없습니다. 이 시험의 판정 대상은 요청마다 확인하는 시스템 상태와 실행 결과입니다. 같은 상태와 결과에 도달한다면 호출 경로가 반드시 같을 필요는 없습니다. 반대로 마지막 답변이 자연스러워도 중간 요청에서 상태가 어긋났다면 실패에 포함됩니다1.
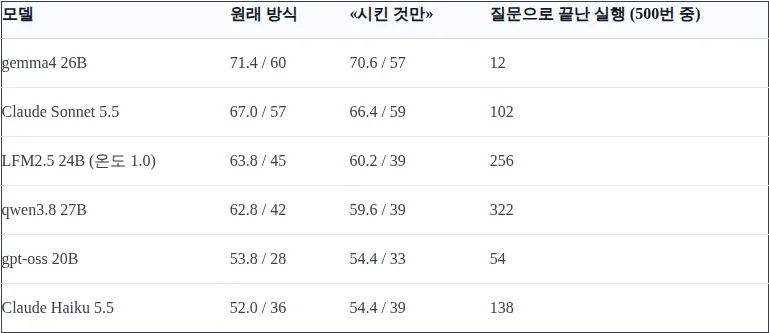
원문 저자는 모델이 실행을 이어 가지 않고 사용자에게 확인을 요청하는 경우를 보고, 질문에 한 번 답해 주는 별도 실험도 했습니다. 처음에는 단순히 동의하는 답을 보냈지만, 이 방식이 원래 요청하지 않은 추가 작업에 동의하는 효과도 낸다는 것을 발견했습니다. 이후 요청한 일만 하라는 사용자 답변으로 다시 측정했습니다. 이는 모델의 시스템 프롬프트를 바꾼 것이 아니라, 실행을 관리하는 쪽에서 후속 사용자 답변을 넣은 조건입니다1.
원문에 나온 qwen의 질문 종료 322회는 이 후속 답변 조건에서의 500회 실행에 대한 집계입니다. 처음의 평균 62.8%·5번 모두 42개와 같은 조건의 추가 열처럼 붙여 읽으면 안 됩니다. 질문 감지도 정해진 표현을 찾는 규칙이며, 다른 일을 제안하는 문장까지 포함합니다. 저자는 질문하는 모델이 점수에서 손해를 본다는 전제 자체가 이 데이터로 지지되지 않는다고 설명합니다1. 질문이 많다는 이유만으로 전체 성공률 차이의 원인을 단정할 수 없는 이유입니다.
한편 저자는 Sonnet이 문서를 만들면서 요청하지 않은 제목과 양식을 넣어, 기대한 빈 파일과 달라진 사례도 소개합니다. 해당 과제에서는 다섯 번 모두 그랬지만, 이런 실패가 전체에서 얼마나 되는지는 세지 않았다고 명시했습니다1. 개별 기록은 채점이 왜 실패가 되었는지 이해하는 데 도움이 됩니다. 다만 그 사례 하나를 모든 과제의 성능 차이에 대한 설명으로 넓힐 수는 없습니다.
세 수치를 함께 읽을 때 평가의 의미가 명확해집니다
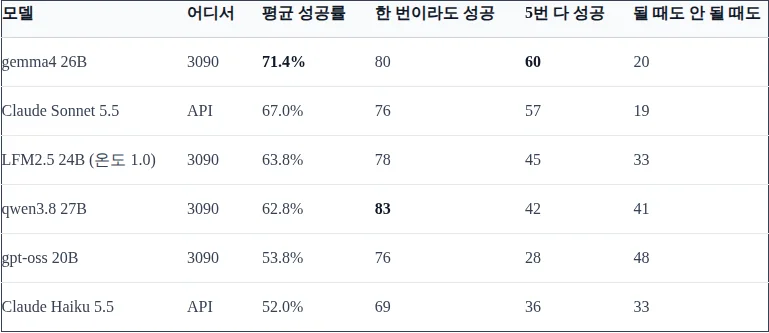
이 비교에서 가져갈 것은 한 모델을 고르는 구호보다 표를 읽는 순서입니다. 먼저 평균 성공률이 전체 실행 가운데 통과한 비율이라는 것을 확인하고, 그다음 한 번이라도 성공한 과제와 매번 성공한 과제를 나란히 봅니다. 성공과 실패가 섞인 과제 수를 함께 두면 평균 하나로 가려졌던 분포를 읽을 수 있습니다. qwen의 41개를 전체 모델 가운데 가장 많다고 쓰는 것도 잘못입니다. 원문에는 이 값이 48개인 gpt-oss 20B도 있기 때문입니다1.
마지막으로 그 수치가 어떤 실행을 포함하는지 확인해야 합니다. 원문은 로컬 실행 도구가 응답을 처리하지 못한 오류와 Claude API 연결 오류도 실패로 셌습니다1. 따라서 집계된 실패를 전부 모델이 문제를 이해하지 못한 경우로 설명할 수 없습니다. 모델 이름과 점수뿐 아니라 실행 환경, 후속 답변 유무, 오류를 세는 방식까지 같이 읽어야 숫자의 범위가 분명해집니다.
평균 성공률은 전체 실행을 합쳐 보여주고, 5번 모두 성공한 과제 수는 같은 과제의 반복 기록을 묶어 보여줍니다. 둘 중 하나가 다른 하나를 대체하지는 않습니다. Sonnet의 67.0%와 qwen의 62.8%를 읽었다면, 57개와 42개, 그리고 76개와 83개도 함께 보는 것이 이 벤치마크를 더 정확하게 이해하는 방법입니다. 먼저 분모를 구분하고, 성공의 분포를 확인한 뒤, 측정한 조건 안에서 결과를 해석하면 됩니다.