平均的な成功率が似通っている2つのモデルであっても、同じ課題を繰り返した際の結果は異なる可能性があります。「一度でも解いたことのある課題が多い」ということと、「同じ課題を5回連続で通過した」ということは、全く別の話です。ツールを使用するLLMのベンチマークを読む際にこの違いを見逃すと、表の中の数値を見ても、成功と失敗がどのように分布しているのかを把握することが困難になります。
ブログ「Bric Blog」(bric.pe.kr) の筆者は、RTX 3090 1枚で稼働するローカルモデル4種類とClaude API 2種類に対し、BFCLツール呼び出し課題100件について5回ずつ実行し、採点を行いました1。その結果、「平均成功率」と「5回すべてに成功した課題数」は、異なる様相を示しました。qwen3.8 27Bの平均成功率は62.8%でClaude Sonnet 5.5(67.0%)とは約4%pの差でしたが、5回すべてに成功した課題数は42対57で15の差がつきました1。これら2つの指標がそれぞれ何を測定するのか、そしてなぜ両方を併せて見る必要があるのかについて、計算過程と実データを用いて説明します。
2つの指標は同じ500回の試行を異なる単位で集計します
実験は、BFCL(Berkeley Function Calling Leaderboard)v4の多段階課題 multi_turn_base 200件のうち、偶数番号の100件を選び、モデルごとに5回ずつ実行するというものでした。各課題では、ユーザーからのリクエストが1〜6回続きます。BFCL公式の採点機は、モデルが呼び出した関数を再実行し、ユーザーのリクエストが1回終わるたびに システムの状態と実行結果を正解と比較します。一度でも異なれば、その課題は失敗となります。モデルが言葉で完了したと述べても、状態が誤っていれば通過できません。したがって、課題全体における最後の結果のみを正答とする試験として読み取ってはいけません1。
この実験において、モデル1つの総実行回数は、100件の課題 × 5回 = 500回です。2つの指標は、この500回のログを異なる基準で集計します。
平均成功率 は、500回の試行のうち成功した回数を500で割った値です。例えば314回成功した場合、 314 ÷ 500 × 100 = 62.8% となります。ここでいう314は試行回数であり、異なる314件の課題を解いたという意味ではありません。同じ課題の成功が複数回含まれている可能性があります。この集計だけでは、成功が特定の課題に集中していたのか、複数の課題に分散していたのかを区別できません。
5回すべてに成功した課題数 は、分母が試行回数(500)ではなく、課題数(100)です。同じ課題を5回実行し、5回とも通過した課題を数え、一度でも失敗した場合はその課題はカウントされません。つまり、「繰り返しの試行でも揺るがなかった課題」の個数を示します。筆者はこれに加えて、「一度でも成功した課題数」と「成功と失敗が混在した課題数」も併せて集計し、課題の安定性を細分化しました1。
要約すると、平均成功率は「試行回数」を分母とし、5回すべてに成功した課題数は「課題数」を分母とします。同じログから算出されたものであっても、集計単位が異なるため、両者の値は異なるシグナルを示します。
平均が同じでも、反復成功率は大きく異なり得ます
なぜ2つの指標が乖離するのかを理解するために、実データよりも簡素な仮想の例を見てみましょう。以下の計算は、Bric Blogの測定結果ではなく、指標の違いを説明するために作成した仮定です。
3つの課題をそれぞれ5回ずつ実行し、合計15回を試行したと仮定します。仮想モデルAの課題別成功回数は5, 5, 0であり、仮想モデルBは4, 3, 3です。
| 課題 | モデルA 成功回数 | モデルB 成功回数 |
|---|---|---|
| 課題 1 | 5 / 5 | 4 / 5 |
| 課題 2 | 5 / 5 | 3 / 5 |
| 課題 3 | 0 / 5 | 3 / 5 |
| 合計 | 10 / 15 | 10 / 15 |
どちらのモデルも15回中10回が成功したため、平均成功率は約66.7%で同一 です。しかし、5回すべてに成功した課題はAが2個、Bは0個です。この仮想の記録において、Aは2つの課題を毎回通過し、もう一つの課題は毎回失敗しました。Bはすべての課題を一度以上通過しましたが、各課題で失敗も生じました。同じ合計数の背後には、異なる分布が存在するということです。この例は、与えられた15回の記録を説明するものであり、次回試行での成功を保証するものではありません。
逆に、Aが5/5・4/5・1/5というパターンを示した場合、平均成功率は依然として66.7%ですが、5回すべてに成功した課題数は1個に減少します。つまり、5回すべてに成功した数値は、成功の配分に敏感に反応する一方で、平均成功率はその分布を反映しません。平均が「いかに多くの試行が通過したか」を示すならば、5回すべてに成功した数値は「いかに多くの課題が繰り返しの試行を通過したか」を示します。
Sonnetとqwenの測定値を併せて読む
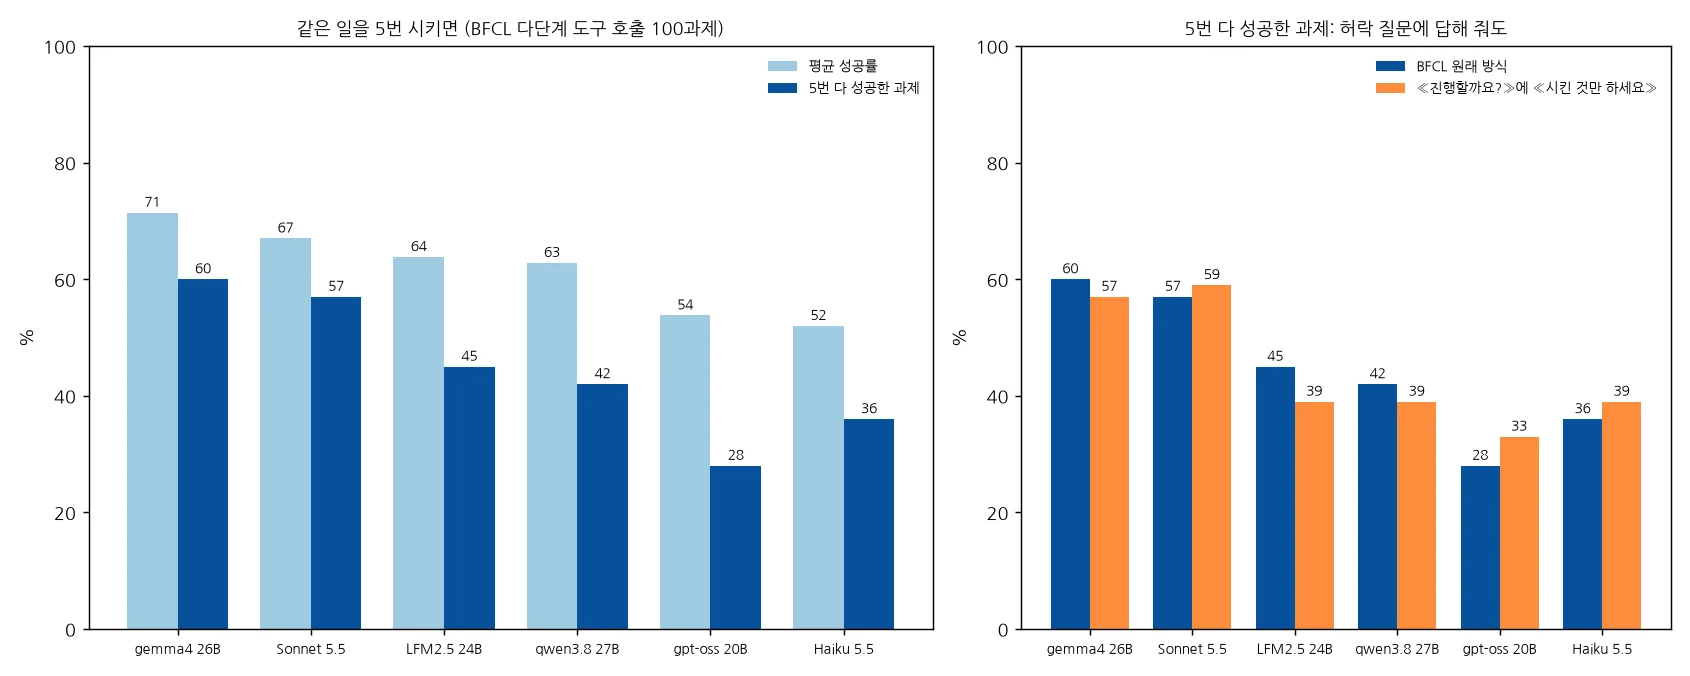
実測値を読む前には、実行条件についても区別する必要があります。ローカルモデルは、RTX 3090 1枚とOllama 0.40.13、コンテキスト長32kの下で実行し、繰り返しごとにseedを変更しました。Claudeモデルは、Anthropic APIで温度1.0、拡張思考なしで実行しました。ローカル側でのseed変更を、Claude APIにも適用されたものと読み取ってはいけません。また、原文のLFM2.5の表の値は、デフォルト温度0.1ではなく1.0で再測定した結果です。すべての行が各モデルのデフォルト設定をそのまま用いたわけではありません1。
| モデル | 実行環境 | 平均成功率 | 一度でも成功 | 5回とも成功 | 成功・失敗混在 |
|---|---|---|---|---|---|
| Claude Sonnet 5.5 | API | 67.0% | 76 | 57 | 19 |
| qwen3.8 27B | RTX 3090 ローカル | 62.8% | 83 | 42 | 41 |
Sonnetとqwenの平均成功率の差は4.2%pであり、5回すべてに成功した課題数の差は15件です。一方で、一度でも成功した課題数は、逆にqwenの83件のほうがSonnetの76件よりも多くなっています。原文の6モデルの中でこの列の最大値もqwenの83件です1。したがって、ある列ではqwenがより多くの課題を解き、別の列ではSonnetがより多くの課題を5回すべて通過したことになります。どの列を読むかによって、問いそのものが変わります。
2つの課題数を差し引くことで、成功と失敗が混在した課題数を算出することも可能です。Sonnetは 76 - 57 = 19개 、qwenは 83 - 42 = 41개 です。逆に、100から一度でも成功した数を引くと、今回の5回の試行において一度も通過できなかった課題はそれぞれ24件と17件であったことが分かります。これらはすべて同じ100件の課題を分類した値です。ここでいう83件は観測された成功の範囲であり、モデルが解くことができるすべての課題の上限ではありません。
57件と42件を除算して、実サービスの信頼性が何倍であると断定することはできません。現在測定しているのは、特定の100件の課題において5回すべてに成功した課題数に過ぎないためです。原文でも、ある種の英語課題のみを使用し、反復回数は5回のみであるという限界を明記しています。より多く反復した場合、すべてに成功する課題数は減少する可能性があります1。この表は測定した範囲の結果を示しており、他の業務や日本語の指示でも同じ結果が出るという保証はしていません。
失敗の記録を読む際にも、実験条件を区別する必要があります
数値の差を確認する作業と、その原因を説明する作業は区別すべきです。関数呼び出しの順序が異なっていたという事実のみをもって、失敗と判断することはできません。この試験における判定対象は、リクエストごとに確認するシステムの状態と実行結果です。同じ状態と結果に到達した場合、呼び出し経路が必ずしも同一である必要はありません。逆に、最終的な回答が自然であっても、途中のリクエストで状態がずれていれば失敗に含まれます1。
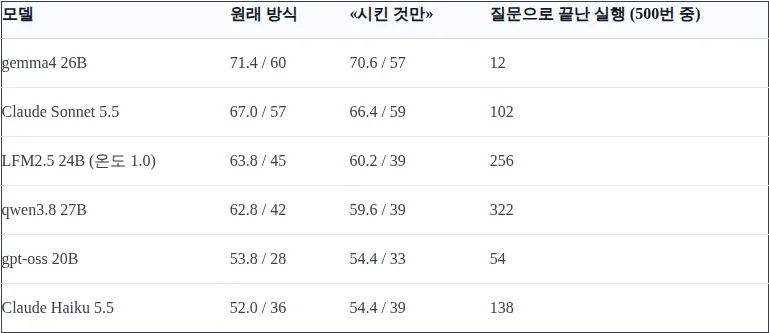
原文の筆者は、モデルが実行を継続せず、ユーザーに確認を求める場合を報告し、質問に一度答える別の実験も実施しました。当初は単純に同意する回答を送っていましたが、この方法がもともと依頼していなかった追加作業への同意として作用する場合があることが分かりました。その後の測定では、依頼した事柄のみを行うよう指示するユーザー回答を使用しました。これはモデルのシステムプロンプトを変更したのではなく、実行を管理する側が 後続のユーザー回答を入力した条件 です1。
原文に記載されているqwenの質問終了322回は、この後続回答条件下の500回の試行に対する集計です。当初の平均62.8%・5回すべて成功42件と、同じ条件の追加列であるかのように続けて読み取ってはいけません。質問検知も、決められた表現を探すルールであり、他の事柄を提案する文まで含まれます。筆者は、質問するモデルはスコアで損をするという前提自体が、このデータによって支持されないことを説明しています1。質問が多いという理由だけで、全体の成功率の差の原因を断定できない理由です。
一方で、筆者はSonnetがドキュメント作成時に、依頼されていないタイトルとフォーマットを加え、期待されていた空のファイルと異なってしまった事例も紹介しています。当該課題では5回すべてそのようになりましたが、このような失敗が全体の中でどの程度を占めるかはカウントしていないと明記されています1。個別の記録は、採点においてなぜ失敗となったのかを理解する助けになります。ただし、その事例一つを、すべての課題における性能差の説明へと拡張することはできません。
3つの数値を併せて読むことで、評価の意味が明確になります
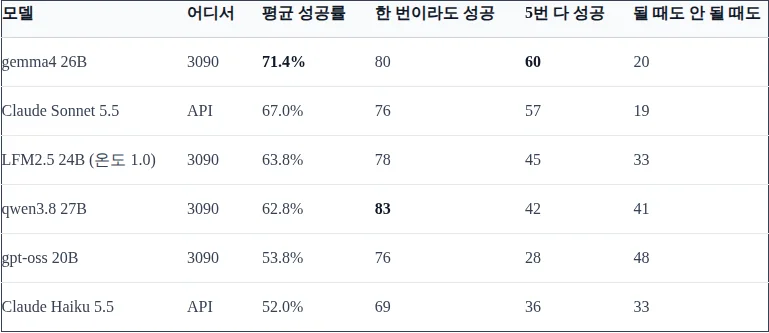
この比較から得られるのは、一つのモデルを選ぶスローガンよりも、表を読む順序です。まず、平均成功率が全体の試行の中で通過した割合であることを確認し、次に「一度でも成功した課題」と「毎回成功した課題」を並べて見ます。成功と失敗が混在した課題数を併せて置けば、平均という一つの指標では隠れていた分布を読み取ることができます。qwenの41件が全モデルの中で最多であると記述するのも誤りです。原文には、この値が48件であるgpt-oss 20Bも存在するためです1。
最後に、その数値がどのような実行を含んでいるのかを確認する必要があります。原文では、ローカル実行ツールが応答を処理できなかったエラーや、Claude APIの接続エラーも失敗としてカウントしました1。したがって、集計された失敗のすべてを、モデルが問題を理解できなかった場合として説明することはできません。モデル名とスコアだけでなく、実行環境、後続回答の有無、エラーの計数方法まで併せて読むことで、数値の範囲が明確になります。
平均成功率は全体の試行を統合して示し、5回すべてに成功した課題数は同じ課題の反復記録をまとめて示します。どちらか一方がもう一方を代用するものではありません。Sonnetの67.0%とqwenの62.8%を読んだのであれば、57件と42件、そして76件と83件も併せて見ることが、このベンチマークをより正確に理解する方法です。まず分母を区別し、成功の分布を確認した上で、測定した条件の中で結果を解釈すればよいのです。



