人工智能不再只是训练模型,而是直接读取并修复作为模型“脑细胞”的权重,这一时代正在开启。OpenAI 的前沿模型 GPT-6 Astra 超越了传统大语言模型优化依赖提示词或超参数的局限,证明了“权重空间编程(Weight-Space Programming)”的可能性:即根据自然语言规范,直接修改可微分神经网络自身的权重。该技术仅通过修改 0.016% 的权重,便消除了原有训练未能解决的逻辑循环问题,并将数学能力评估分数提升了六倍以上。
排除梯度下降法的新优化方式
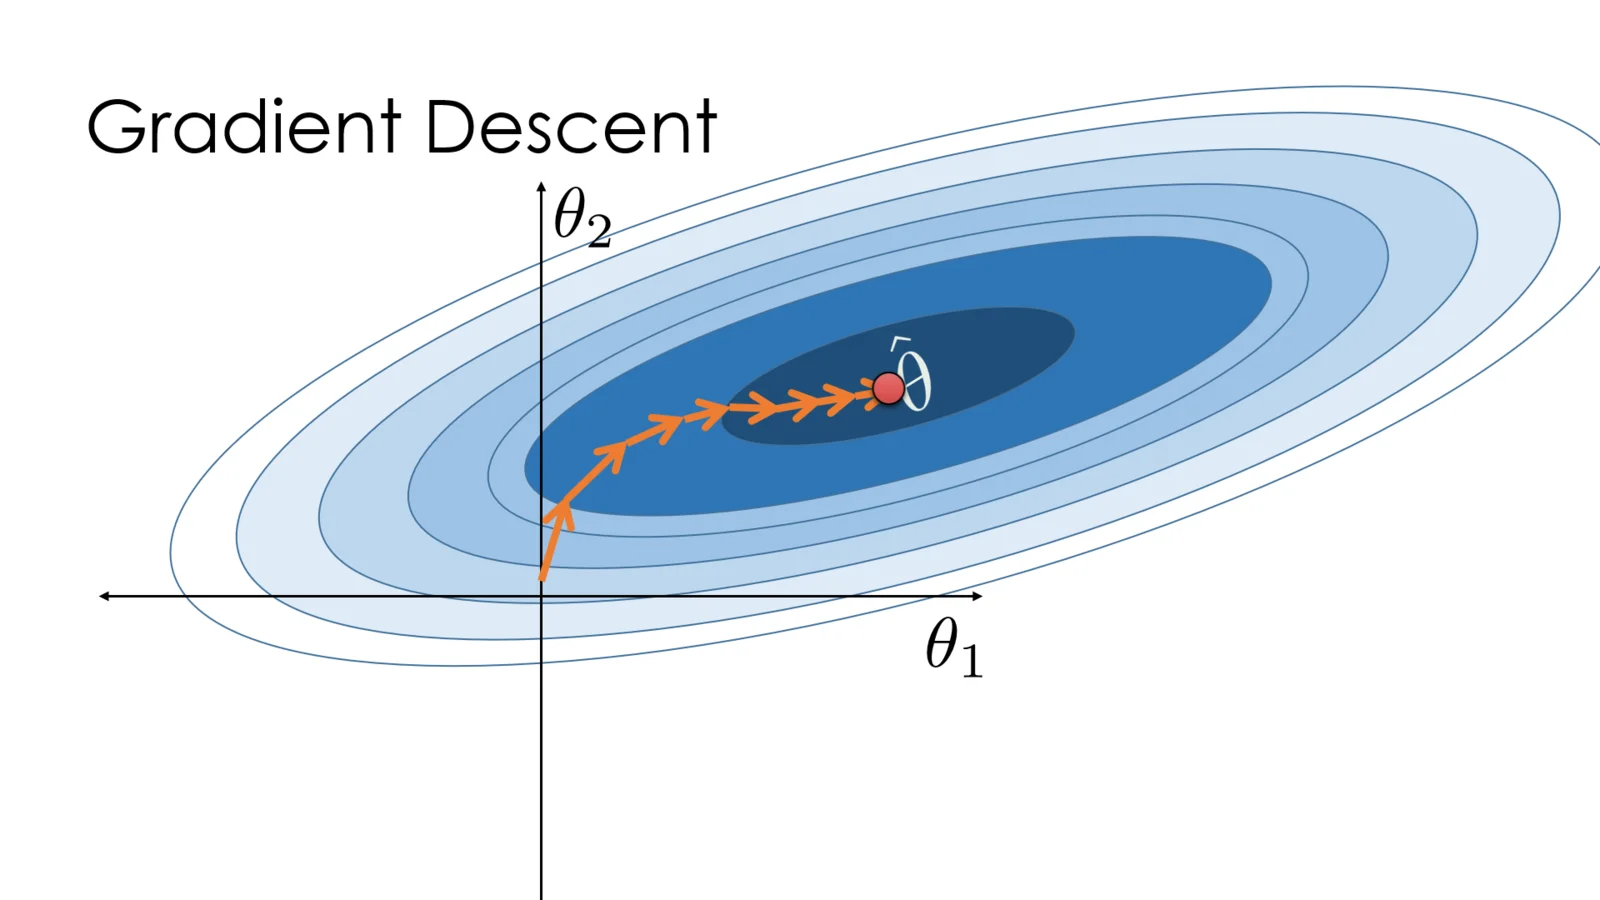
权重空间编程是指通用大语言模型在不使用优化器或梯度下降法的情况下,直接读取和写入其他神经网络权重的方式。现有的模型性能提升方法依赖于通过数据集反复微调权重的微调技术或训练循环。然而,这一新范式允许模型接受自然语言形式的目标规范,并据此对目标模型的权重矩阵进行即时编辑。
GPT-6 Astra 的案例清晰地表明,这一概念并非单纯的抽象理论。模型能够超越文本生成或代码编写,理解并主动重构作为其他模型内部结构的“权重空间”,这预示着人工智能优化方式的根本性变革。
权重读取:无需执行即可理解网络结构
权重空间编程的第一个核心是“权重读取”。关键在于,大语言模型能否在无需模型执行或推理过程的情况下,仅凭权重数字的罗列就能洞察其中蕴含的知识。
实验结果显示,仅输入小型神经网络的权重数据,模型就能准确识别出该模型是专门针对 Breakout、Pong 等四款 Atari 游戏优化的。这并非面对一堆杂乱数字的猜测,而是 GPT-6 Astra 从权重矩阵中读取到了输入通道结构或输出连接模式等细微的结构线索。
然而,也存在不能仅依赖权重的领域。在理解注意力模式等动态运作机制时,被证实存在局限性。在区分 Gemma 3 270M 模型的谄媚倾向(Sycophancy)实验中,仅使用权重数据时失败了,但当允许使用能够显示每个注意力头注意力分配比例的分析工具(注意力模式分析)后,模型成功识别出了这一特征。这表明,只有同时读取权重本身以及权重所产生的信息流,才能实现完整的理解。
权重修改的机制:并非增加能力,而是“排除障碍”
最引人注目的成果是 Qwen3.5-0.8B 模型的性能改进案例。Astra 仅修改了 Qwen3.5-0.8B 总权重中的 0.016%。通过这种微小的改动,消除了模型原本存在的“重复推理(repetitive reasoning)”故障,使 MATH-500 基准测试得分从 7.9% 提升至 48.1%,实现了六倍以上的增长。IFEval 分数也从 21.0% 上升至 62.3%,增长约三倍。
| 模型状态 | 修改权重比例 | MATH-500 分数 | IFEval 分数 |
|---|---|---|---|
| 修改前的 Qwen3.5-0.8B | 0% | 7.9% | 21.0% |
| 修改权重后的 Qwen3.5-0.8B | 0.016% | 48.1% | 62.3% |
这一分数提升的原因并非向模型中“添加”了新的数学能力。原本在 MATH-500 评估中因达到响应令牌(Token)上限而陷入无限循环的模型,通过消除故障因素,得以正常发挥其原本具备的能力。在 MATH-500 评估中,超过令牌上限的响应比例从 93.0% 降至 33.1%,这一数据有力地佐证了上述观点。
条件性生效:解除既有能力的局限与围棋实战测试
这种方式并非适用于所有模型的万灵药。在原本就不存在重复推理这一故障因素的 Gemma 3 270M 模型上尝试权重修改时,未观察到显著的性能提升。这明确表明,权重空间编程的主要性能提升机制更接近于“解除现有能力的限制”,而非“创造新能力”。
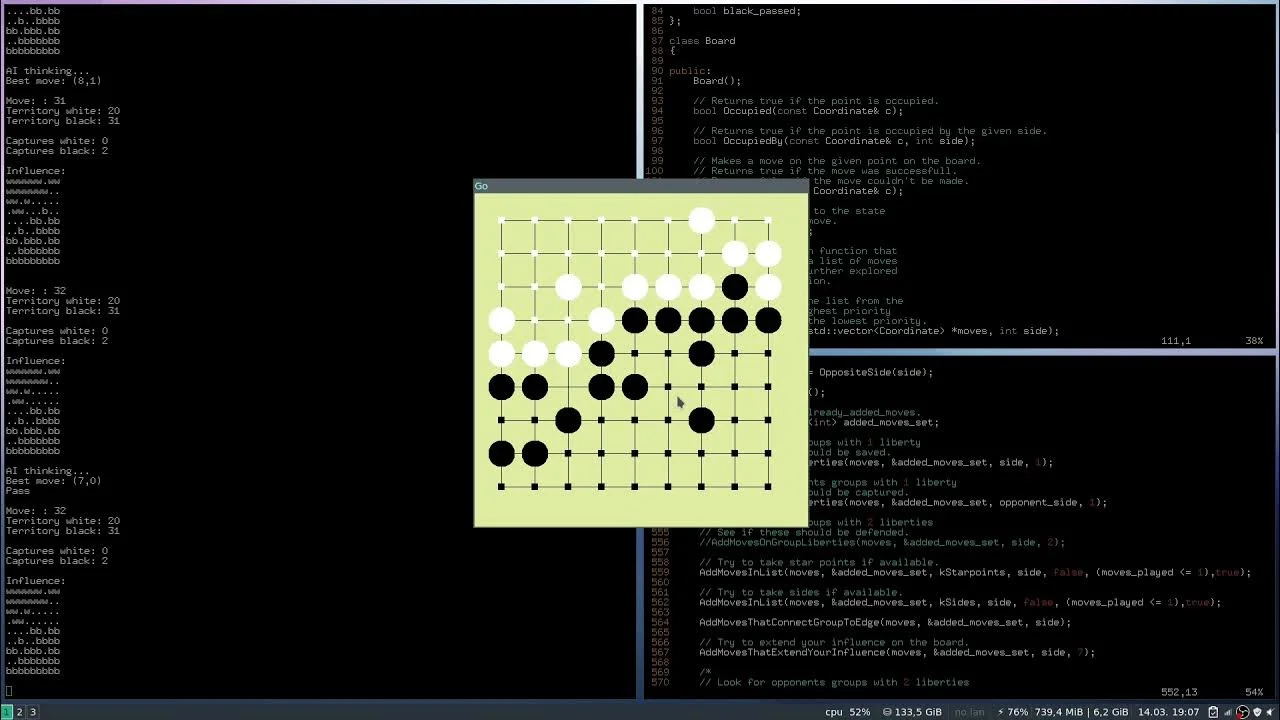
另一方面,在复杂的实战任务中,也会利用有限的反馈。Astra 在 9x9 围棋环境中,使用受限的前向传播(forward pass)工具直接编写了一个拥有约 148 万个权重的神经网络。通过练习对局,该模型将胜率提升到了 50% 以上。在赛车坡道任务(Kinetix)中,当经过训练的 PPO 模型陷入局部最优解时,通过修改 3.5%(6,073 个)的权重,添加了读取位置和速度的新控制路径,从而解决了问题。
超越微调的编写能力:MinAtar Breakout 结果
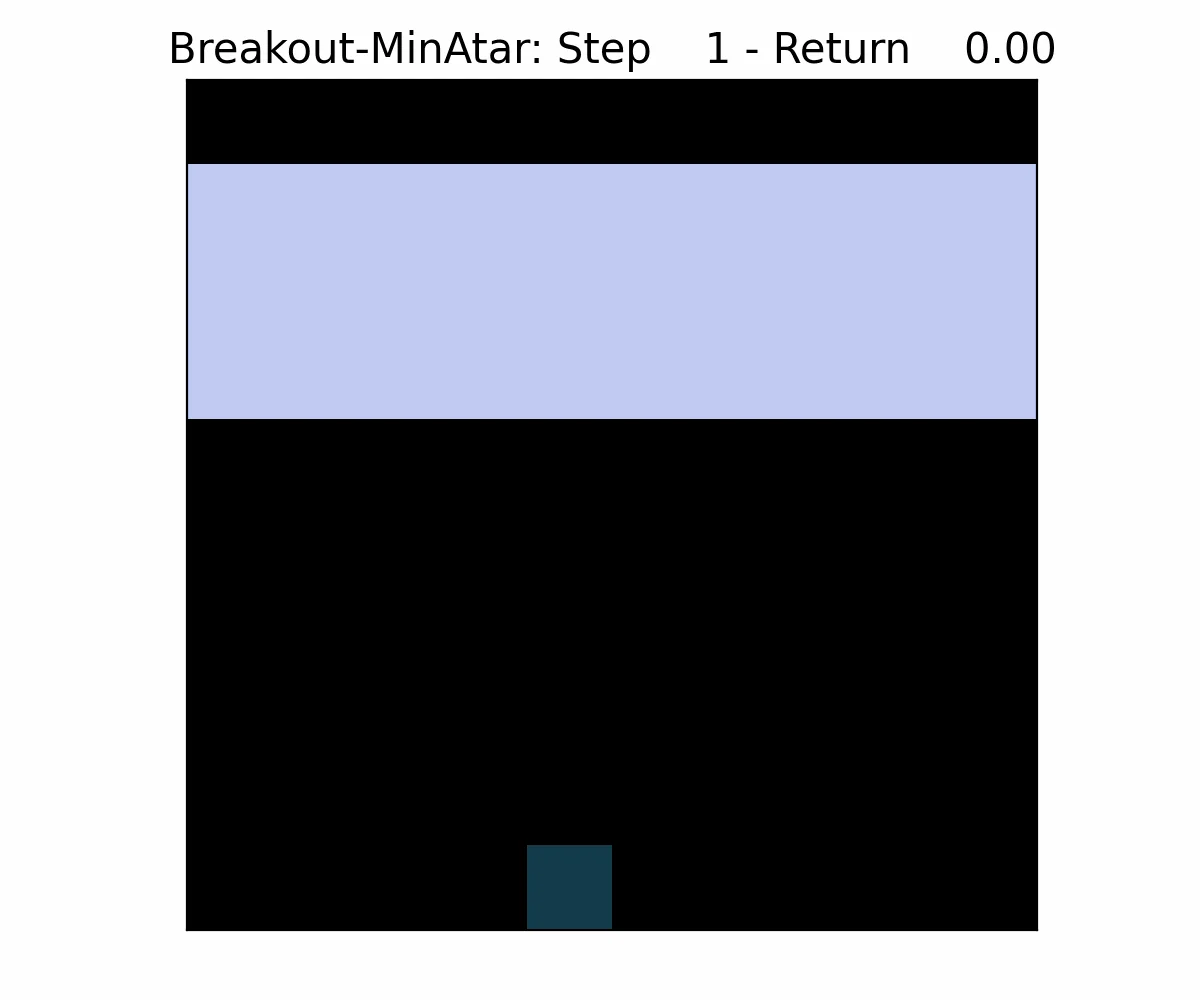
除了修改之外,该模型“编写”新神经网络的能力也展现出超越传统强化学习方法的结果。
| 模型及学习方法 | MinAtar Breakout 分数 |
|---|---|
| PPO 训练(1 亿步) | 15.8 |
| PPO 训练(5 亿步) | 25.3 |
| Astra 直接编写权重 | 517.4 |
在 MinAtar 环境下的 Breakout 游戏实验中,Astra 从零开始编写的权重取得了 517.4 分,比通过 PPO(近端策略优化)强化学习训练 1 亿步和 5 亿步的模型所创下的 15.8 分和 25.3 分高出二十倍以上。
这种直接读取和修改权重的能力,被解读为大语言模型学习数据中包含的自然语言、代码及数学推理能力的泛化。模型在学习阶段看到并掌握的编程与数学模式,被扩展到了对实际神经网络数字数组的操作中。
权重空间编程的实战应用与剩余课题
目前的权重空间编程仍处于初期阶段,巨大的上下文长度处理能力以及框架(Harness)的低效率限制了其性能。此外,Qwen 等特定模型的成功案例是否能以相同方式推广到所有大型语言模型,仍需更多的验证。
然而,该技术所展现出的实战应用潜力十分明确。通过无需训练循环的权重初始化,可以大幅降低优化成本;通过仅修改少数权重而非全量重新训练,可以在避免灾难性遗忘(Catastrophic Forgetting)的同时,灵活地调整模型的特定能力。
尽管相对于传统微调的成本效益还需要进一步验证,但人工智能模型能够像处理编程语言一样操纵自身或他人的结构这一现象,是一项足以彻底改变从模型评估、审计(Audit)方式到性能调优全过程的基础技术。



