AI가 모델을 더 훈련하는 대신 모델의 뇌세포인 가중치를 직접 읽고 고치는 시대가 열리고 있습니다. OpenAI의 프런티어 모델 GPT-6 Astra는 기존 LLM 최적화가 프로프트나 하이퍼파라미터에 의존하던 한계를 넘어, 미분 가능한 신경망 자체의 가중치를 자연어 명세에 맞춰 직접 수정하는 '가중치 공간 프로그래밍(Weight-Space Programming)'의 가능성을 증명했습니다. 이 기술은 단 0.016%의 가중치 변경만으로 기존 학습으로 해결하지 못한 논리적 루프를 제거하고 수학 능력 평가 점수를 6배 이상 끌어올리는 기염을 토했습니다.
경사하강법을 배제한 새로운 최적화 방식
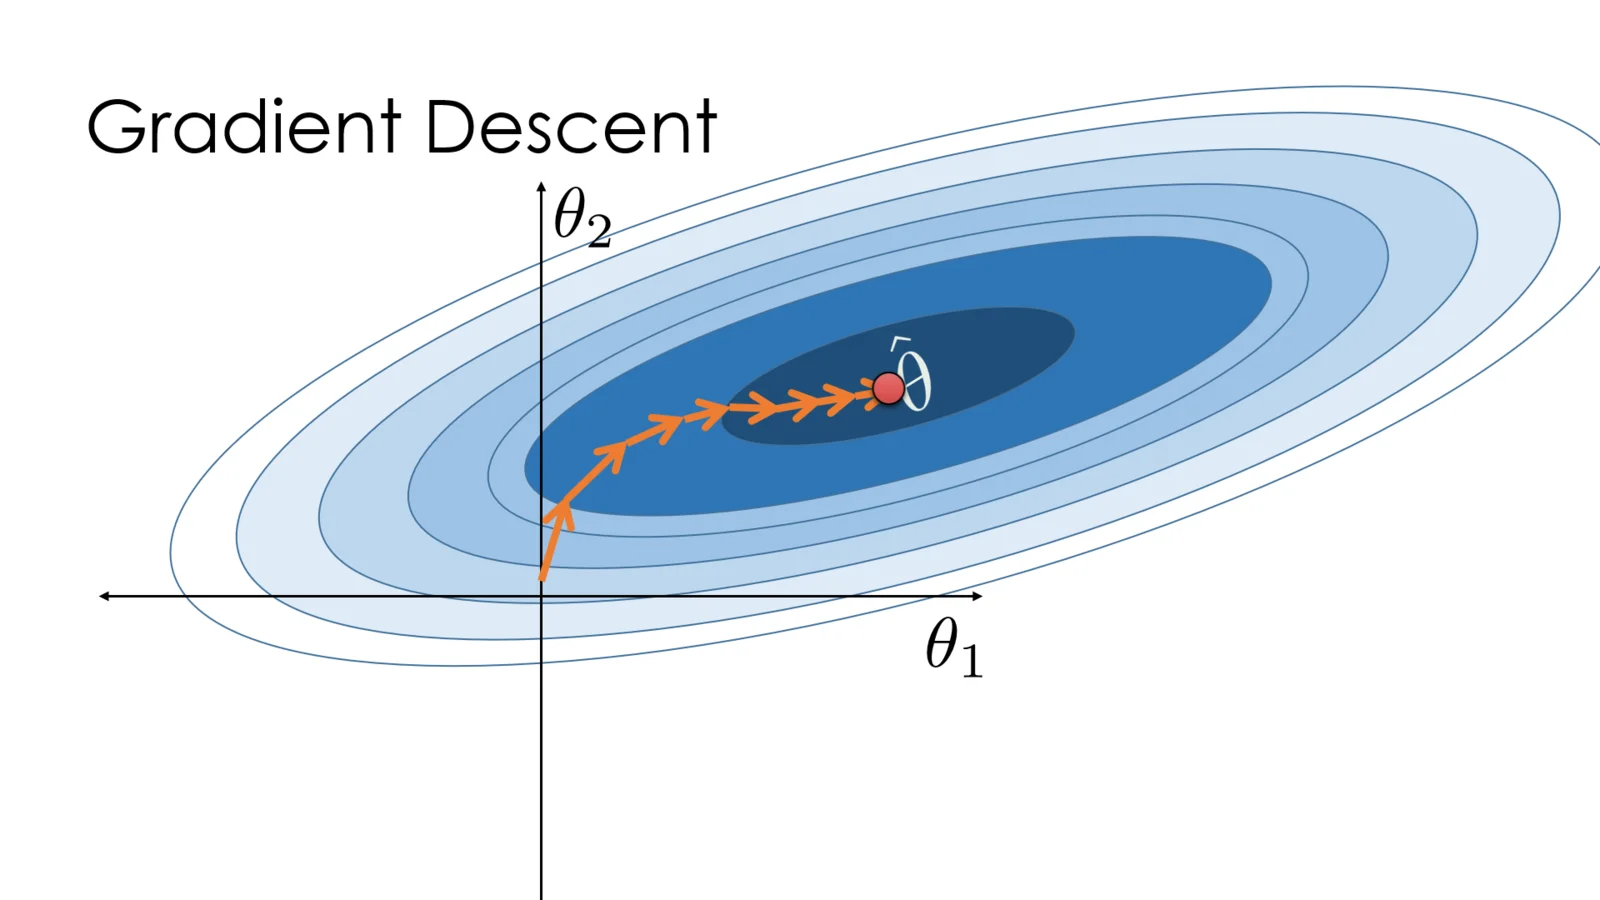
가중치 공간 프로그래밍은 옵티마이저나 경사하강법 없이 범용 LLM이 다른 신경망의 가중치를 직접 읽고 쓰는 방식을 말합니다. 기존의 모델 성능 향상 방식은 데이터셋을 통해 반복적으로 가중치를 미세 조정하는 파인튜닝이나 학습 루프에 의존했습니다. 하지만 이 새로운 패러다임은 모델이 자연어로 된 목표 명세를 받아들이고, 이를 바탕으로 타겟이 되는 모델의 가중치 행렬에 즉각적인 편집을 가합니다.
GPT-6 Astra의 사례는 이러한 개념이 단순한 추상적 이론이 아님을 명확히 보여줍니다. 모델이 텍스트 생성이나 코드 작성을 넘어 다른 모델의 내부 구조인 '가중치 공간'을 이해하고 능동적으로 재구성할 수 있다는 사실은 AI 최적화 방식의 근본적인 변화를 예고합니다.
가중치 읽기: 실행 없이 네트워크 구조를 파악하다
가중치 공간 프로그래밍의 첫 번째 핵심은 '가중치 읽기'입니다. LLM이 모델 실행이나 추론 과정 없이 순수하게 가중치 숫자 나열만 보고 어떤 지식을 담고 있는지 파악할 수 있는지가 관건입니다.
실험 결과, 작은 신경망의 가중치 데이터만 입력하면 Breakout, Pong 등 Atari 4가지 게임에 특화된 모델임을 정확히 식별했습니다. 이는 단순한 숫자의 무더기가 아니라 가중치 행렬 내에 존재하는 입력 채널의 구조나 출력 연결 패턴 등 미세한 구조적 단서를 GPT-6 Astra가 읽어낸 결과입니다.
하지만 가중치에만 의존할 수 없는 영역도 있습니다. 어텐션 패턴과 같은 동적 작동 방식의 파악에는 한계가 확인되었습니다. Gemma 3 270M 모델의 아첨 성향(Sycophancy)을 구분하는 실험에서 가중치 데이터만으로는 실패했으나, 헤드별 주의 분배 비율을 보여주는 어텐션 패턴 분석 도구를 허용하자 이를 성공적으로 식별했습니다. 이는 가중치 그 자체와 가중치가 만들어내는 정보 흐름을 함께 읽어야 완전한 파악이 가능함을 시사합니다.
가중치 수정의 메커니즘: 능력 추가 아닌 '장애 제거'
가장 주목할 만한 성과는 Qwen3.5-0.8B 모델의 성능 개선 사례입니다. Astra는 Qwen3.5-0.8B의 전체 가중치 중 단 0.016%만 수정했습니다. 이 미세한 변경을 통해 모델이 겪던 '반복 추론(repetitive reasoning)' 장애를 제거하여 MATH-500 벤치마크 점수를 7.9%에서 48.1%로 6배 이상 끌어올렸습니다. IFEval 점수 역시 21.0%에서 62.3%로 3배가량 상승했습니다.
| 모델 상태 | 수정 가중치 비중 | MATH-500 점수 | IFEval 점수 |
|---|---|---|---|
| 수정 전 Qwen3.5-0.8B | 0% | 7.9% | 21.0% |
| 가중치 수정 후 Qwen3.5-0.8B | 0.016% | 48.1% | 62.3% |
이 점수 상승의 원인은 모델에 새로운 수학 능력을 '추가'한 것이 아닙니다. 원래는 MATH-500 평가에서 응답 토큰 한도에 도달하며 무한 루프를 돌던 모델이 그 장애 요소를 제거함으로서 원래 갖고 있던 능력을 정상적으로 발휘하게 된 것입니다. MATH-500 평가에서 토큰 한도 초과 응답 비율이 93.0%에서 33.1%로 감소한 수치가 이를 뒷받침합니다.
조건부 작동: 기존 능력 해제의 한계와 바둑 실전 테스트
이러한 방식은 모든 모델에서 만능이 아닙니다. 반복 추론이라는 장애 요소 자체가 없던 Gemma 3 270M 모델에 가중치 수정을 시도했을 때는 유의미한 성능 개선이 관찰되지 않았습니다. 이는 가중치 공간 프로그래밍의 주된 성능 향상 메커니즘이 '새로운 능력 창출'보다 '기존 능력의 제약 해제'에 가깝다는 점을 명확히 합니다.
한편, 복잡한 실전 과제에서는 제한적인 피드백이 활용되기도 했습니다. Astra는 9x9 바둑 환경에서 제한된 순전파(forward pass) 도구를 사용해 약 148만 개의 가중치를 가진 신경망을 직접 작성했습니다. 이 모델은 연습 대국을 통해 승률을 50% 이상으로 높였습니다. 자동차 경사로 과제(Kinetix)에서는 학습된 PPO 모델이 국소 최적점에 갇혔을 때 가중치의 3.5%(6,073개)를 수정하여 위치와 속도를 읽는 새로운 제어 경로를 추가해 문제를 해결했습니다.
파인튜닝을 압도하는 작성 능력: MinAtar Breakout 결과
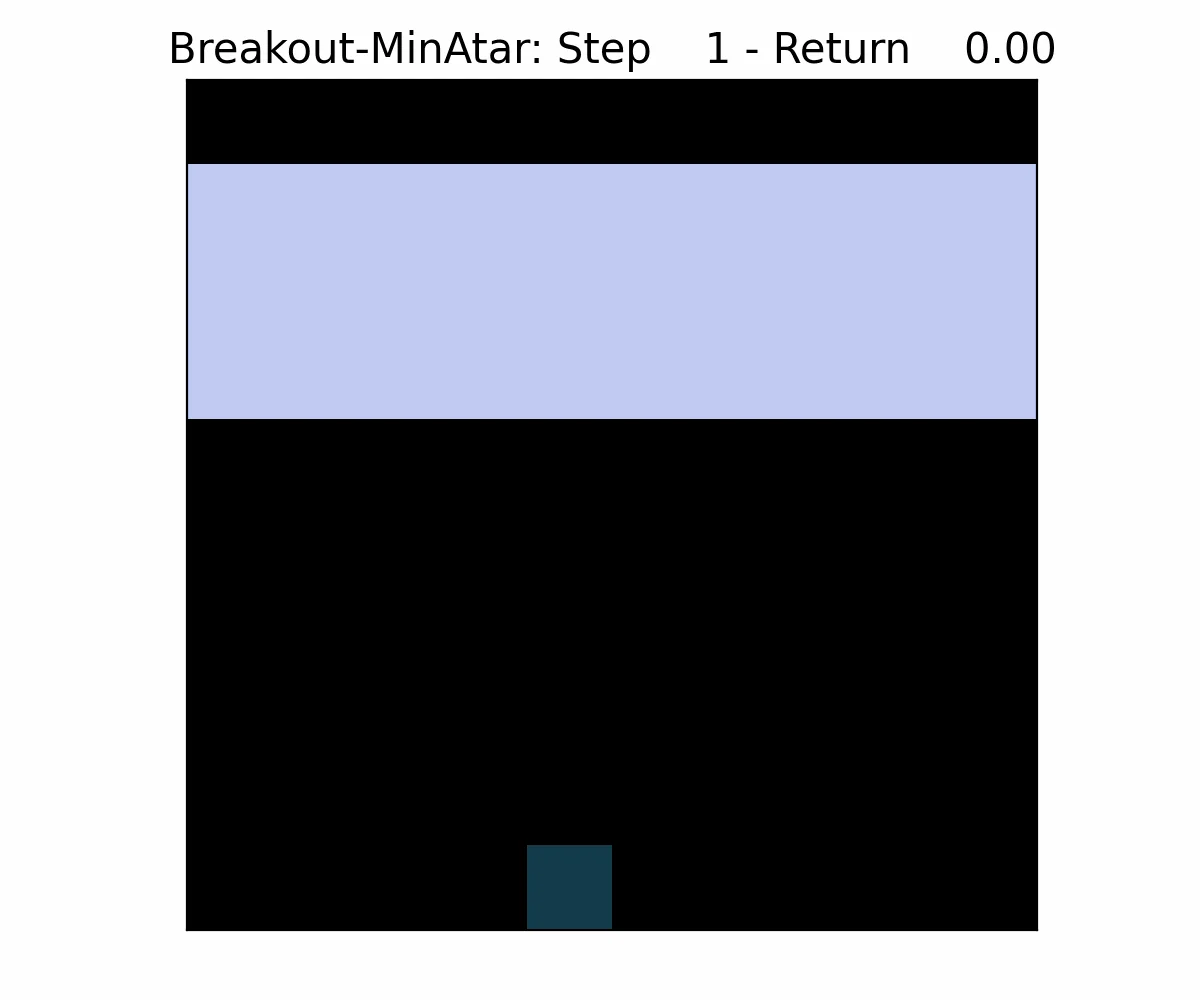
수정 뿐만 아니라 새로운 신경망을 '작성'하는 능력 역시 기존의 강화학습 방식을 압도하는 결과를 보여주었습니다.
| 모델 및 학습 방법 | MinAtar Breakout 점수 |
|---|---|
| PPO 학습 (1억 스텝) | 15.8 |
| PPO 학습 (5억 스텝) | 25.3 |
| Astra 가중치 직접 작성 | 517.4 |
MinAtar 환경의 Breakout 게임 실험에서 Astra가 처음부터 작성한 가중치는 PPO(Proximal Policy Optimization) 강화학습으로 1억 스텝과 5억 스텝을 학습한 모델들이 기록한 15.8점과 25.3점을 모두 20배 이상 압도하는 517.4점을 기록했습니다.
이러한 가중치 직접 읽기와 수정 능력은 LLM의 학습 데이터에 포함된 자연어, 코드, 수학적 추론 능력의 일반화로 해석됩니다. 모델이 학습 단계에서 보고 익힌 프로그래밍적, 수학적 패턴이 실제 신경망 숫자 배열 조작으로 확장된 것입니다.
가중치 공간 프로그래밍의 실전 적용과 남은 과제
현재의 가중치 공간 프로그래밍은 초기 단계로, 거대한 문맥 길이 처리와 하네스(Harness)의 비효율성이 성능에 제한을 두고 있습니다. 또한 Qwen과 같은 특정 모델의 성공 사례가 모든 대형 언어 모델에 동일한 방식으로 확대 해석될 수 있는지 여부는 더 많은 검증이 필요합니다.
그러나 이 기술이 제시하는 실전 적용의 잠재력은 매우 명확합니다. 학습 루프 없이 가중치 초기화를 통해 최적화 비용을 대폭 절감할 수 있으며, 전체 재학습 대신 소수의 가중치 수정만을 통해 파국적 망각(Catastrophic Forgetting) 없이 모델의 특정 능력을 유연하게 조정할 수 있습니다.
기존 파인튜닝 대비 비용 효율성 측면에서 추가 검증이 요구되긴 하지만, AI 모델이 자기 자신의 구조나 타인의 구조를 프로그래밍 언어 다루듯 조작할 수 있게 된 현상은 모델 평가, 감사(Audit) 방식부터 성능 튜닝의 전 과정을 송두리째 바꿀 기반 기술입니다.