Se abre una era en la que la IA no solo entrena más a los modelos, sino que lee y corrige directamente los pesos, que son las células cerebrales de estos. GPT-6 Astra, el modelo fronterizo de OpenAI, ha demostrado las posibilidades de la 'Programación en el Espacio de Pesos (Weight-Space Programming)', una técnica que supera los límites de la optimización tradicional de los LLM, la cual dependía de prompts o hiperparámetros, para modificar directamente los pesos de la red neuronal diferenciable según especificaciones en lenguaje natural. Esta tecnología logró eliminar bucles lógicos que el aprendizaje previo no resolvió y elevó la puntuación en evaluaciones de capacidad matemática más de seis veces, mediante un cambio mínimo en el 0,016 % de los pesos.
Un nuevo modo de optimización que excluye el descenso por gradiente
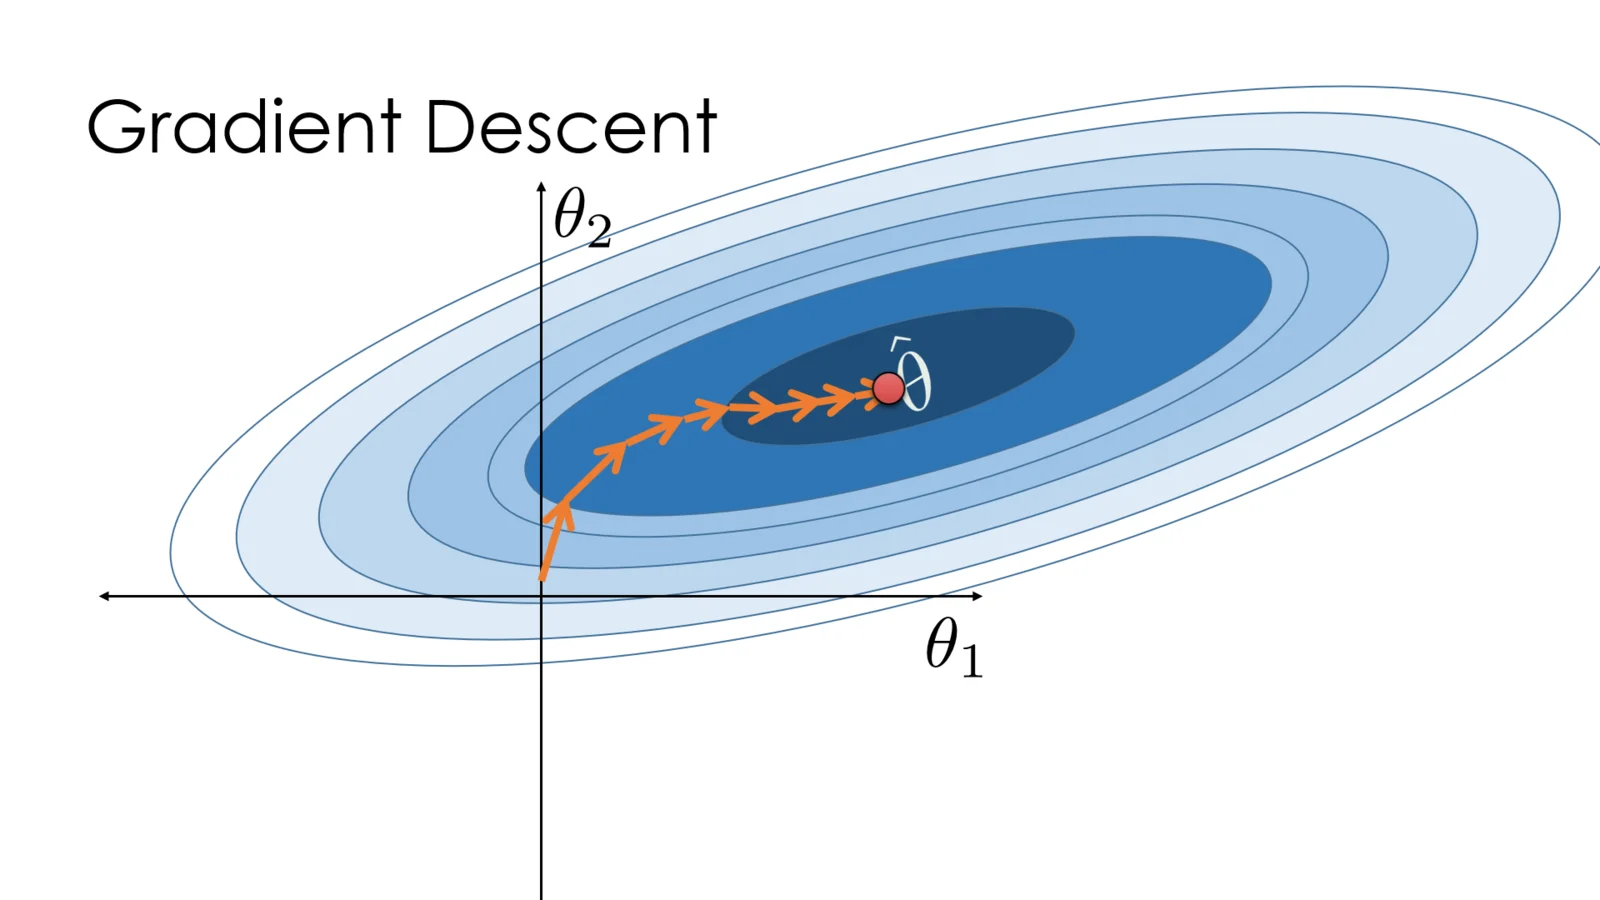
La programación en el espacio de pesos consiste en que un LLM de propósito general lea y escriba directamente los pesos de otras redes neuronales sin necesidad de optimizadores ni del método de descenso por gradiente. Los métodos tradicionales de mejora del rendimiento de los modelos dependían del fine-tuning, un ajuste fino iterativo de los pesos mediante conjuntos de datos, o de bucles de aprendizaje. Sin embargo, este nuevo paradigma permite que el modelo acepte especificaciones de objetivos en lenguaje natural y, basándose en ellas, realice ediciones inmediatas en las matrices de pesos del modelo objetivo.
El caso de GPT-6 Astra demuestra claramente que este concepto no es solo una teoría abstracta. El hecho de que el modelo pueda ir más allá de la generación de texto o la escritura de código para entender y reconfigurar activamente el 'espacio de pesos' —la estructura interna de otros modelos— anuncia un cambio fundamental en los métodos de optimización de la IA.
Lectura de pesos: comprender la estructura de la red sin ejecutarla
La primera clave de la programación en el espacio de pesos es la 'lectura de pesos'. Lo crucial es determinar si un LLM puede entender qué conocimiento contiene un modelo basándose únicamente en la enumeración numérica de los pesos, sin ejecutar el modelo ni realizar procesos de inferencia.
Los resultados experimentales mostraron que, al proporcionar solo los datos de pesos de redes neuronales pequeñas, el sistema identificó con precisión que se trataba de modelos especializados en cuatro juegos de Atari, como Breakout y Pong. Esto fue posible porque GPT-6 Astra captó pistas estructurales sutiles, como la estructura de los canales de entrada o los patrones de conexión de salida presentes en las matrices de pesos, en lugar de verlos como simples montones de números.
No obstante, existen áreas en las que no se puede depender únicamente de los pesos. Se observaron limitaciones para captar modos de operación dinámicos, como los patrones de atención. En un experimento destinado a distinguir la tendencia a la adulación (Sycophancy) del modelo Gemma 3 270M, los datos de pesos por sí solos fracasaron en la tarea; sin embargo, al permitir el uso de una herramienta de análisis de patrones de atención que muestra la proporción de distribución de atención por cabezal (head), el sistema logró identificarlo con éxito. Esto sugiere que es necesario leer tanto los pesos mismos como el flujo de información que generan para lograr una comprensión completa.
Mecanismo de corrección de pesos: no añadir capacidades, sino 'eliminar deficiencias'
El logro más destacado es el caso de mejora del rendimiento del modelo Qwen3.5-0.8B. Astra modificó apenas el 0,016 % del total de los pesos de Qwen3.5-0.8B. A través de este cambio mínimo, eliminó la deficiencia de 'razonamiento repetitivo' que padecía el modelo, elevando la puntuación en el benchmark MATH-500 de 7,9 % a 48,1 %, un aumento de más de seis veces. Asimismo, la puntuación en IFEval ascendió de 21,0 % a 62,3 %, casi triplicándose.
| Estado del modelo | Proporción de pesos modificados | Puntuación MATH-500 | Puntuación IFEval |
|---|---|---|---|
| Qwen3.5-0.8B antes de la modificación | 0% | 7.9% | 21.0% |
| Qwen3.5-0.8B después de la modificación de pesos | 0.016% | 48.1% | 62.3% |
La causa de este aumento de puntuaciones no radica en la 'adición' de nuevas capacidades matemáticas al modelo. Originalmente, el modelo entraba en un bucle infinito al alcanzar el límite de tokens de respuesta durante la evaluación de MATH-500; al eliminar ese elemento obstructivo, el modelo pudo ejercer normalmente las capacidades que ya poseía. La disminución de la tasa de respuestas que excedieron el límite de tokens en la evaluación de MATH-500, pasando del 93,0 % al 33,1 %, respalda esta afirmación.
Funcionamiento condicional: límites en la liberación de capacidades existentes y pruebas prácticas de Go
Este enfoque no es una solución universal para todos los modelos. Cuando se intentó modificar los pesos del modelo Gemma 3 270M, que carecía de la deficiencia de razonamiento repetitivo, no se observaron mejoras significativas en el rendimiento. Esto deja claro que el principal mecanismo de mejora del rendimiento de la programación en el espacio de pesos se acerca más a la 'liberación de capacidades existentes' que a la 'creación de nuevas capacidades'.
Por otro lado, en tareas prácticas complejas se ha recurrido a veces a retroalimentación limitada. En un entorno de Go de 9x9, Astra creó directamente una red neuronal con aproximadamente 1,48 millones de pesos utilizando una herramienta de propagación hacia adelante (forward pass) limitada. Este modelo aumentó su tasa de victorias a más del 50 % mediante partidas de práctica. En la tarea de pista de coche (Kinetix), cuando el modelo PPO entrenado quedó atrapado en un óptimo local, se modificó el 3,5 % de los pesos (6.073 elementos) para añadir una nueva ruta de control que lee la posición y la velocidad, resolviendo así el problema.
Capacidad de escritura que supera al fine-tuning: resultados en MinAtar Breakout
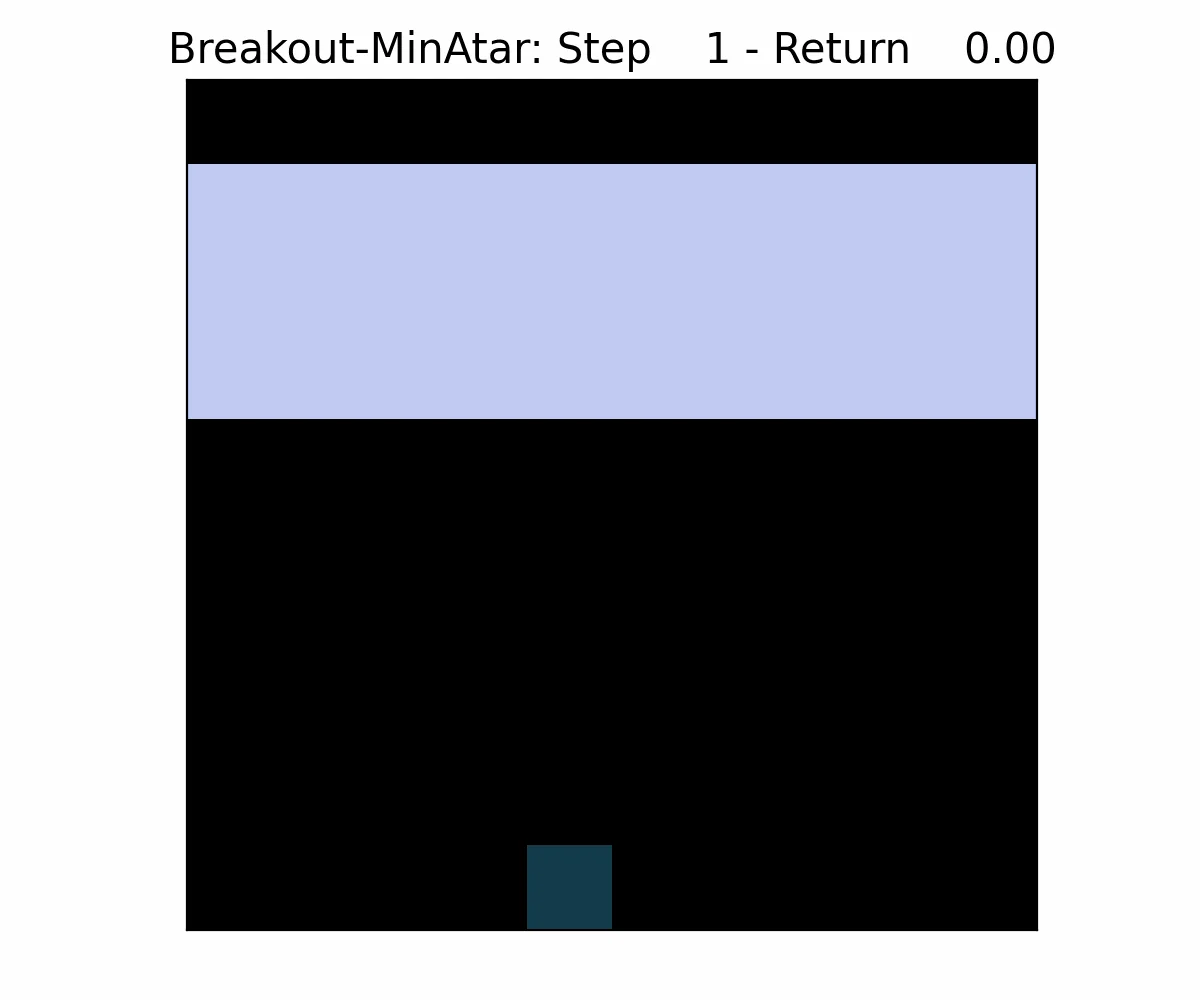
Además de la modificación, la capacidad de 'escribir' nuevas redes neuronales también ha mostrado resultados que superan abrumadoramente los métodos de aprendizaje por refuerzo tradicionales.
| Modelo y método de aprendizaje | Puntuación en MinAtar Breakout |
|---|---|
| Aprendizaje PPO (100 millones de pasos) | 15.8 |
| Aprendizaje PPO (500 millones de pasos) | 25.3 |
| Escritura directa de pesos por Astra | 517.4 |
En el experimento con el juego Breakout en el entorno MinAtar, los pesos escritos desde cero por Astra alcanzaron una puntuación de 517,4, superando por más de 20 veces los 15,8 y 25,3 puntos obtenidos por modelos entrenados mediante aprendizaje por refuerzo con PPO (Proximal Policy Optimization) durante 100 millones y 500 millones de pasos, respectivamente.
Estas capacidades de lectura y modificación directa de pesos se interpretan como una generalización de las habilidades de lenguaje natural, código y razonamiento matemático incluidas en los datos de entrenamiento de los LLM. Los patrones de programación y matemáticos que el modelo vio y aprendió durante la fase de entrenamiento se han extendido a la manipulación real de los arreglos numéricos de las redes neuronales.
Aplicación práctica de la programación en el espacio de pesos y desafíos pendientes
La programación en el espacio de pesos se encuentra actualmente en sus primeras etapas, y el manejo de longitudes de contexto enormes y la ineficiencia del arnés (Harness) limitan su rendimiento. Además, es necesario verificar aún más si los casos de éxito con modelos específicos como Qwen pueden extrapolarse de la misma manera a todos los grandes modelos de lenguaje.
No obstante, el potencial de aplicación práctica que presenta esta tecnología es muy claro. Permite reducir significativamente los costos de optimización mediante la inicialización de pesos sin necesidad de bucles de aprendizaje, y ajustar灵活mente capacidades específicas del modelo sin provocar un olvido catastrófico (Catastrophic Forgetting), mediante la modificación de solo una pequeña fracción de los pesos en lugar de un reentrenamiento completo.
Aunque se requiere una validación adicional respecto a la eficiencia de costos en comparación con el fine-tuning tradicional, el hecho de que los modelos de IA puedan manipular su propia estructura o la de otros como si manejaran un lenguaje de programación representa una tecnología fundamental que transformará por completo el proceso desde la evaluación y auditoría de modelos hasta el ajuste completo de rendimiento.



