AIがモデルの追加学習を行う代わりに、モデルの脳細胞である重みを直接読み取って修正する時代が到来しています。OpenAIのフロンティアモデルGPT-6 Astraは、従来のLLM最適化がプロンプトやハイパーパラメータに依存していた限界を乗り越え、微分可能なニューラルネットワーク自体の重みを自然言語仕様に基づいて直接修正する「重み空間プログラミング(Weight-Space Programming)」の可能性を実証しました。この技術は、わずか0.016%の重み変更のみで、従来の学習では解決できなかった論理ループを排除し、数学能力評価のスコアを6倍以上に引き上げるという快挙を成し遂げました。
勾配降下法を排除した新たな最適化手法
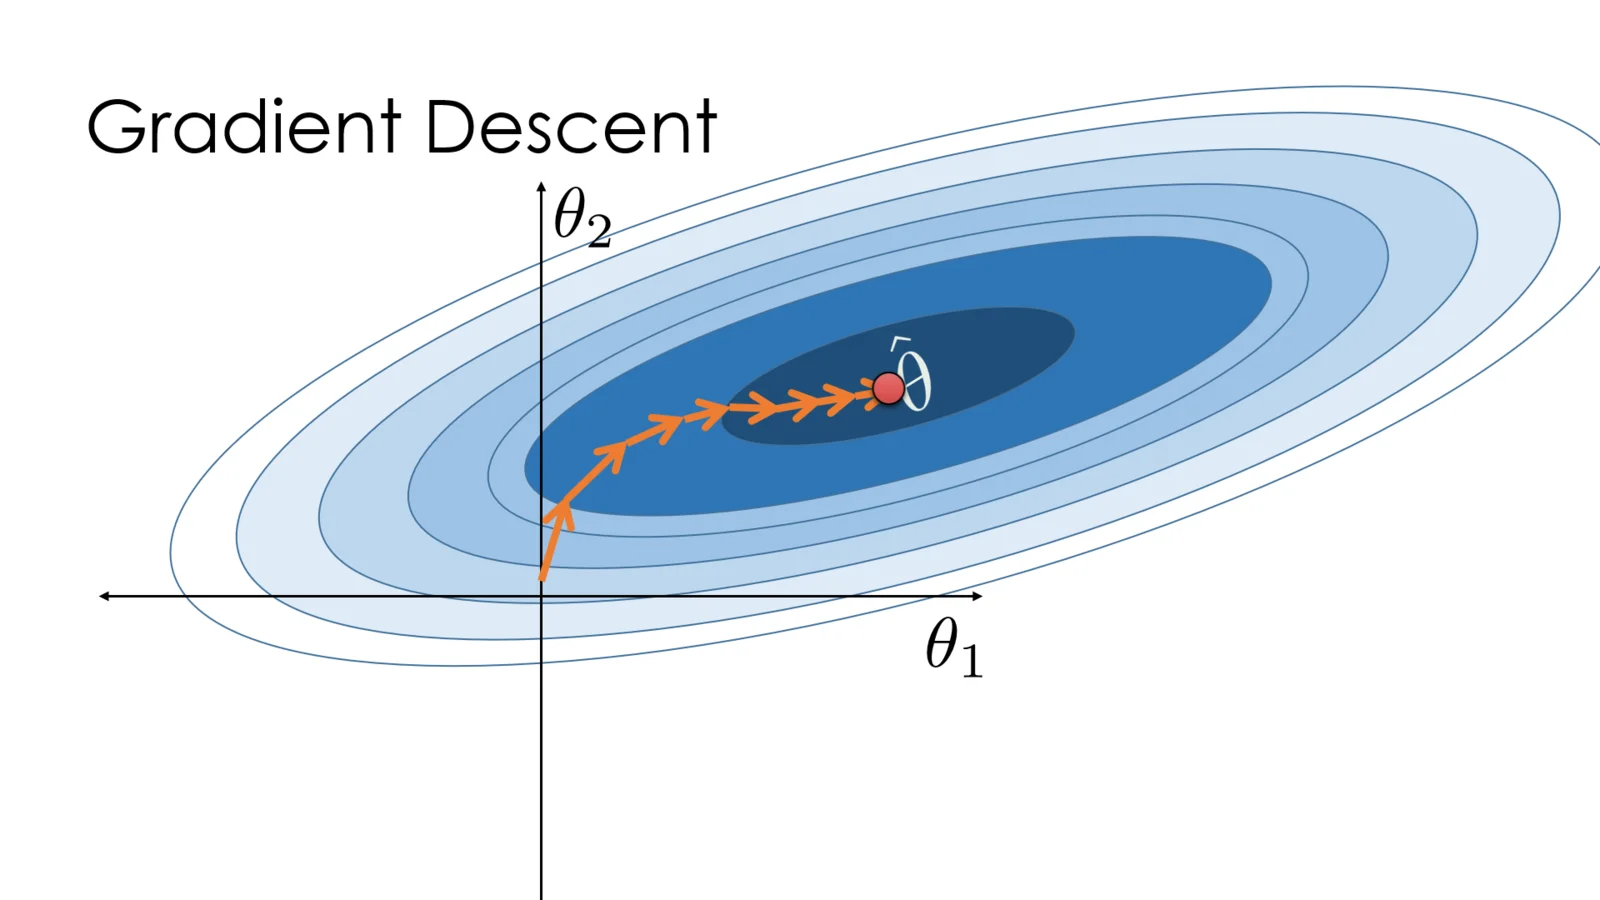
重み空間プログラミングとは、オプティマイザや勾配降下法を用いずに、汎用LLMが他のニューラルネットワークの重みを直接読み書きする手法を指します。従来のモデル性能向上手法は、データセットを通じて重みを反復的に微調整するファインチューニングや学習ループに依存していました。しかし、この新しいパラダイムでは、モデルが自然言語で記述された目標仕様を受け入れ、それを基に対象モデルの重み行列に対して即座に編集を加えます。
GPT-6 Astraの事例は、こうした概念が単なる抽象的な理論ではないことを明確に示しています。モデルがテキスト生成やコード作成を超えて、他のモデルの内部構造である「重み空間」を理解し、能動的に再構築できるという事実は、AIの最適化手法における根本的な変革を予告しています。
重みの読み取り:実行なしでネットワーク構造を把握する
重み空間プログラミングの第1の核心は「重みの読み取り」です。LLMがモデルの実行や推論プロセスを経ることなく、純粋に重みの数値の羅列だけを見て、どのような知識を含んでいるかを把握できるかどうかが鍵となります。
実験結果によると、小さなニューラルネットワークの重みデータのみを入力すると、そのモデルがBreakoutやPongなどAtariの4種類のゲームに特化していることを正確に識別しました。これは単なる数字の羅列ではなく、重み行列内に存在する入力チャネルの構造や出力接続パターンといった微細な構造的手がかりを、GPT-6 Astraが読み取った結果です。
しかし、重みにのみ依存できない領域も存在します。アテンションパターンなどの動的な動作方式の把握には限界があることが確認されました。Gemma 3 270Mモデルのアダプト性(Sycophancy)を区別する実験では、重みデータだけでは失敗しましたが、ヘッドごとの注意配分比率を示すアテンションパターン分析ツールを許可すると、これを正常に識別できました。これは、重みそのものと、重みが生成する情報フローを併せて読み取らなければ、完全な把握が可能にならないことを示唆しています。
重み修正のメカニズム:能力の追加ではなく「障害の除去」
最も注目に値する成果は、Qwen3.5-0.8Bモデルの性能改善事例です。Astraは、Qwen3.5-0.8Bの全重みのうちわずか0.016%のみを修正しました。この微細な変更により、モデルが抱えていた「反復推論(repetitive reasoning)」障害を除去し、MATH-500ベンチマークスコアを7.9%から48.1%へと6倍以上に引き上げました。IFEvalスコアも21.0%から62.3%へと約3倍上昇しました。
| モデル状態 | 修正重み比率 | MATH-500 スコア | IFEval スコア |
|---|---|---|---|
| 修正前 Qwen3.5-0.8B | 0% | 7.9% | 21.0% |
| 重み修正後 Qwen3.5-0.8B | 0.016% | 48.1% | 62.3% |
このスコア上昇の原因は、モデルに新たな数学能力を「追加」したことではありません。元々、MATH-500評価において応答トークン上限に達して無限ループに陥っていたモデルが、その障害要因を除去することで、本来持っていた能力を正常に発揮できるようになったためです。MATH-500評価におけるトークン上限超過の応答割合が93.0%から33.1%へ減少した数値がこれを裏付けています。
条件付き作動:既存能力の解放の限界と囲碁の実践テスト
この手法はすべてのモデルにおいて万能ではありません。反復推論という障害要因そのものがないGemma 3 270Mモデルに重み修正を試みた場合、有意な性能改善は観察されませんでした。これは、重み空間プログラミングの主たる性能向上メカニズムが、「新たな能力の創出」よりも「既存能力の制約解除」に近いことを明確に示しています。
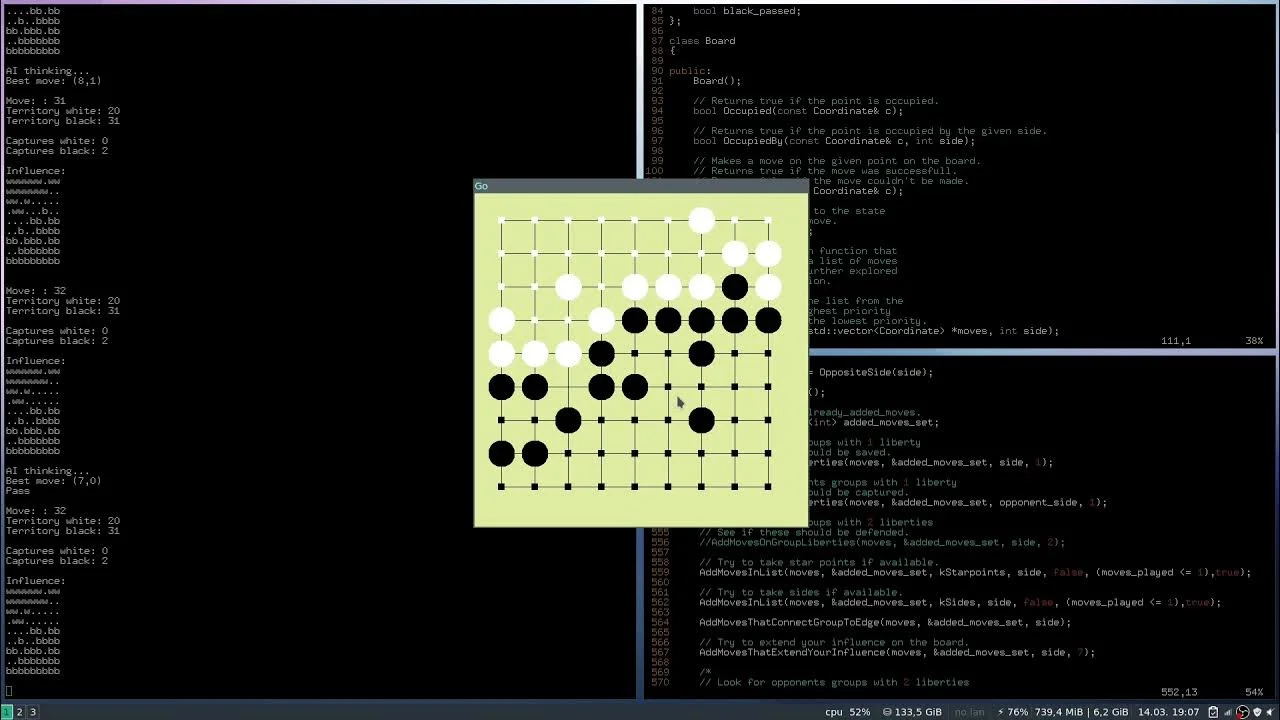
一方で、複雑な実務課題では限定的なフィードバックが活用されることもあります。Astraは、9x9の囲碁環境において、限定的な順伝播(forward pass)ツールを使用して、約148万個の重みを持つニューラルネットワークを直接作成しました。このモデルは、練習対局を通じて勝率を50%以上まで向上させました。自動車坂道課題(Kinetix)では、学習されたPPOモデルが局所最適点に陥った際、重みの3.5%(6,073個)を修正することで、位置と速度を読み取る新たな制御パスを追加し、問題を解決しました。
ファインチューニングを圧倒する記述能力:MinAtar Breakoutの結果
修正だけでなく、新たなニューラルネットワークを「記述」する能力も、従来の強化学習手法を圧倒する結果を示しました。
| モデルおよび学習方法 | MinAtar Breakout スコア |
|---|---|
| PPO学習(1億ステップ) | 15.8 |
| PPO学習(5億ステップ) | 25.3 |
| Astraによる重み直接記述 | 517.4 |
MinAtar環境のBreakoutゲーム実験において、Astraが一から記述した重みは、PPO(Proximal Policy Optimization)強化学習で1億ステップと5億ステップを学習したモデルが記録した15.8点および25.3点をいずれも20倍以上引き離す517.4点を記録しました。
こうした重みの直接読み取りと修正能力は、LLMの学習データに含まれる自然言語、コード、数学的推論能力の一般化として解釈されます。モデルが学習段階で見て習得したプログラム的・数学的パターンが、実際のニューラルネットワークの数値配列の操作へと拡張されたのです。
重み空間プログラミングの実務適用と残された課題
現在の重み空間プログラミングは初期段階であり、巨大なコンテキスト長の処理やハーネス(Harness)の非効率性が性能上の制約となっています。また、Qwenなど特定のモデルにおける成功例が、すべての大規模言語モデルに対して同じ方式で拡大解釈できるかどうかについては、さらなる検証が必要です。
しかし、この技術が提示する実務適用の可能性は非常に明確です。学習ループなしでの重み初期化により最適化コストを大幅に削減できるほか、全体再学習の代わりに少数の重み修正のみを通じて、破滅的忘却(Catastrophic Forgetting)なしでモデルの特定能力を柔軟に調整できます。
既存のファインチューニングと比較したコスト効率性の観点からはさらなる検証が求められますが、AIモデルが自分の構造や他者の構造をプログラミング言語を扱うように操作できるようになった現象は、モデル評価、監査(Audit)方式から性能チューニングの全プロセスを根本から変える基盤技術です。



