用不同数据训练的 AI 模型,是否可能以相似的方式表征世界?2024 年发布的**柏拉图表征假说(PRH)**基于这一观察:随着视觉模型和语言模型规模的扩大,衡量数据之间关联的方式趋于相似。该假说并未断言所有模型必然拥有相同的表征,原论文也同时讨论了其局限性与反例。1
2026 年 10 月 29 日发布的 Randall Balestriero 和 Yann LeCun 的后续论文,从使用何种观测对进行训练的视角分析了这一问题。作者提出了关于 JEPA 的条件定理,并报告了实验结果:在达到相同表征对齐水平时,所需训练样本数显著减少。以下数据来源于论文及作者代码仓库的公布值,并非本博客独立复现的结果。2 3
JEPA 预测的内容
JEPA 的结构是从观测数据的表征中预测另一观测的表征。本研究中的关键区分在于优质视图(good views)与劣质视图(bad views)。优质视图是指观察同一场景所得的两份数据。作者举例说明:同一图像的不同描述,或同一场景的两张照片。3
另一方面,通过将某一观测部分掩码或裁剪而构成的数据对,在论文中被归类为劣质视图。作者指出,从这一视角也可以解释下一词元预测。此处所称的“劣质”针对的是跨模态表征对齐的效率,并不意味着语言模型在写作或编程等方面的整体性能不佳。2
从假说到定理:必须结合条件阅读
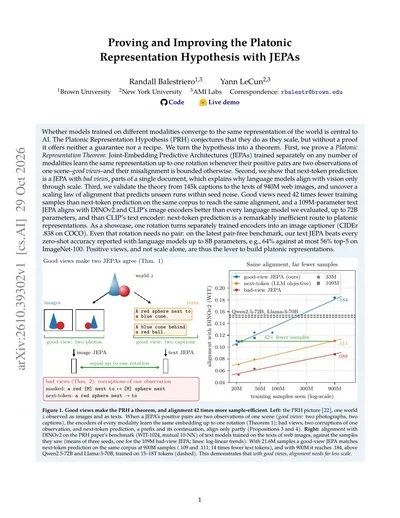
后续论文中的定理探讨了在优质视图条件下,各模态独立训练的 JEPA 表征在相差一个旋转变换的情况下趋于一致。当条件不满足时,则分析表征失配的上界。因此,不应将这一结论泛读为“任何模型最终都具备相同的内部表征”这一无条件命题。2
作者代码仓库公开了定理的数值验证、训练代码、评估代码及实验复现流程。其价值在于有助于区分理论假设与实际实验设置。3
关于“样本数减少 42 倍”结果的比较条件
作者报告的42 倍是在使用相同的 109M 编码器和相同语料库的情况下,达到与 DINOv2 相同对齐水平所需的样本数比较。优质视图方式使用了 21.6M 样本,而下一词元预测使用了 900M 样本。这并不意味着在所有条件下总体训练成本都减少了 42 倍。3
在独立的 WIT-1024 评估中,109M 文本 JEPA 的 DINOv2-B 对齐分数高于对比的语言模型。3
| 对比模型 | 参数规模 | 与 DINOv2-B 的对齐分数 |
|---|---|---|
| 文本 JEPA | 109M | 0.184 |
| Qwen2.5-72B | 72B | 0.154 |
| Llama-3-70B | 70B | 0.151 |
表中的指标是表征对齐,而非小型 JEPA 在所有功能上替代大型 LLM 的比较。代码仓库不仅公布了基准结果,还明确列出了不同归一化权重下其他随机种子的较低分数;因此,在复现时需同时确认实验设置与随机种子。3
应区分图像描述与无对偶对齐
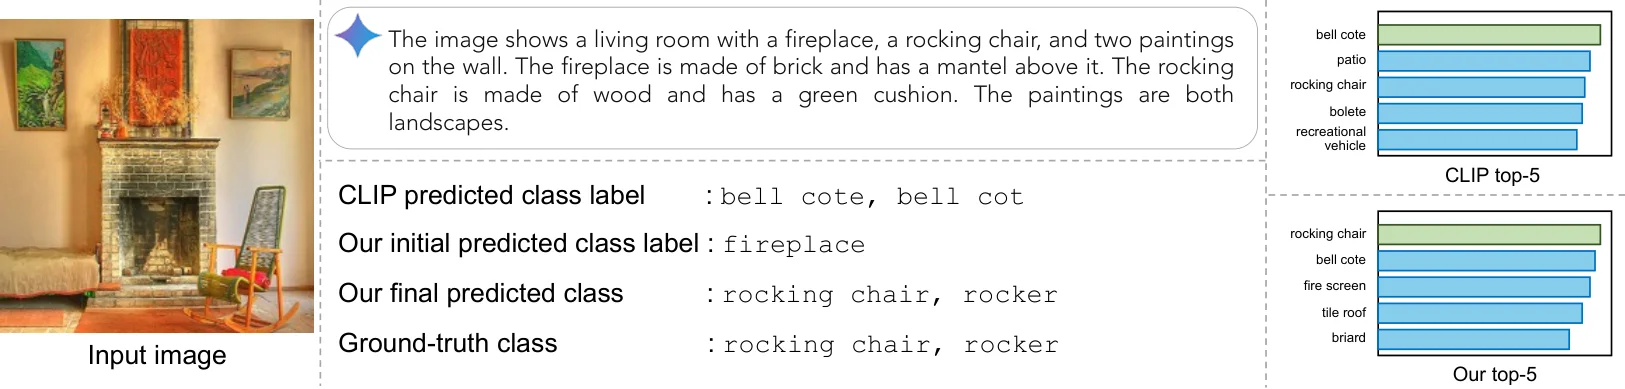
作为应用实例,图像描述器将独立训练的图像编码器与文本表征空间通过旋转同构映射关联起来,并使用经过文本微调的语言模型生成描述。作者报告了 COCO 数据集上 0.838 的 CIDEr 分数。该描述器并未以图像-描述对的方式联合训练神经网络,但在对齐旋转同构映射的步骤中使用了成对数据。3
论文中另有无对偶对齐基准测试实验。在 ImageNet-100 上报告了约 64% 的 top-5 准确率,与对比论文中报告的至多 56% 形成对照。如果将描述器架构与该评估混为一谈,并声称“所有步骤完全不需要成对数据”,就会改变实验条件。2
除模型规模外还应关注的设计变量
本研究引发的思考其实很简单:在扩大模型规模之前,我们能否考察用于训练的两个观测在多大程度上共享同一世界状态?
公开代码将小数据实验与大规模实验的复现流程分开。若要亲自验证,最好将优质视图与对比方法的编码器、数据和评估指标对齐,然后再比较结果。关键在于:重点不在于宣称立即取代 LLM,而在于在表征对齐这一目标下,观测对的设计是一个多么重要的变量。3
参考资料
- The Platonic Representation Hypothesis (2024) · arxiv.org↩
- ↩
- 저자 코드·실험 결과·재현 절차: galilai-group/prh-proof · github.com↩



