¿Podrían los modelos de IA entrenados con datos distintos representar el mundo de manera similar? La Hipótesis Platónica de la Representación (PHR), publicada en 2024, parte de la observación de que, a medida que aumentan de tamaño los modelos visuales y de lenguaje, las formas de medir las relaciones entre los datos se parecen cada vez más. No se trata de una conclusión que asuma que todos los modelos posean ya la misma representación, y el artículo original también aborda limitaciones y contraejemplos. 1
El artículo posterior de Randall Balestriero y Yann LeCun, publicado el 29 de octubre de 2026, analiza este problema desde la perspectiva de con qué pares de observaciones se entrena. Los autores presentan un teorema condicional sobre JEPA y reportan experimentos que reducen el número de muestras de entrenamiento necesarias para alcanzar el mismo nivel de alineación de representaciones. Las cifras siguientes son los valores reportados en el artículo y en el repositorio de los autores, y no han sido reproducidos directamente en este blog. 2 3
Lo que predice JEPA
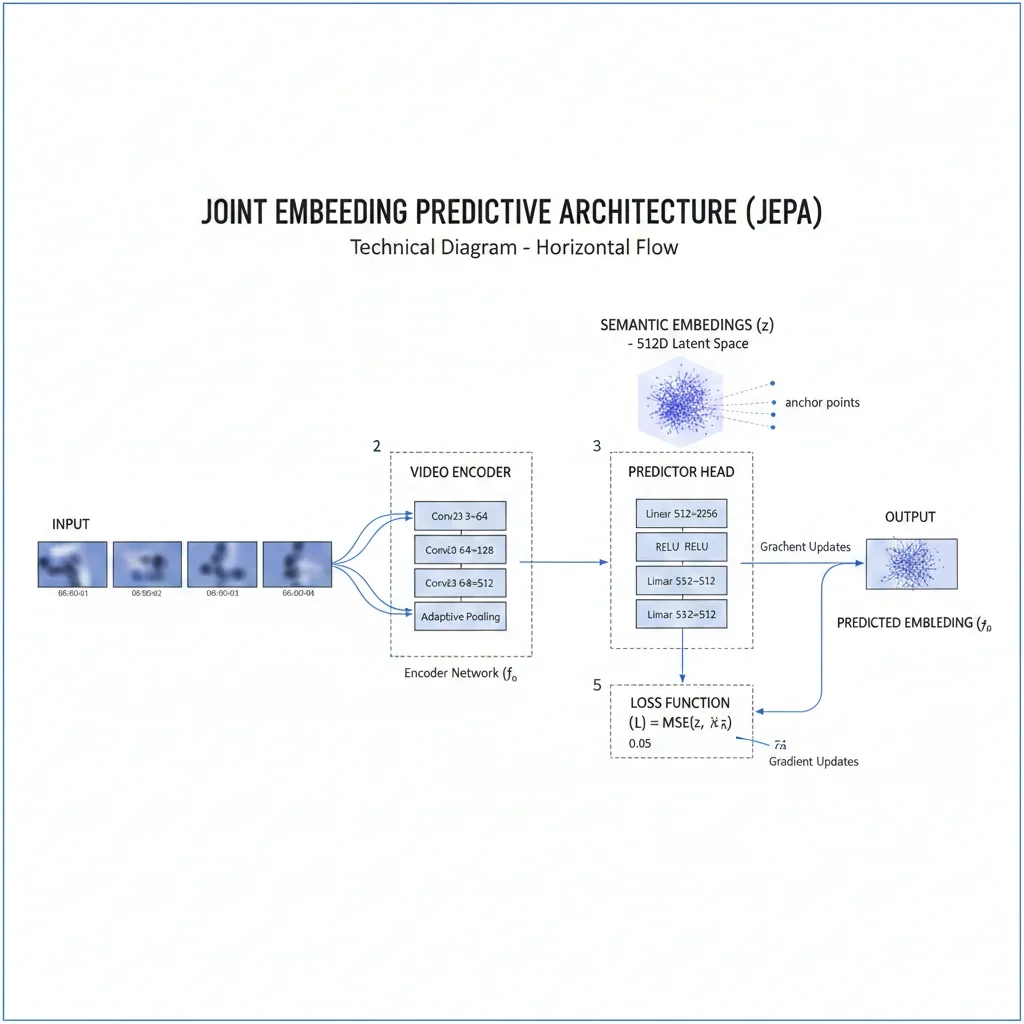
JEPA es una arquitectura que predice la representación de una observación a partir de la representación de otra observación de datos. En este estudio, la distinción clave es entre buenas vistas (good views) y malas vistas (bad views). Las buenas vistas son dos datos que observan la misma escena. Los autores citan como ejemplos dos descripciones distintas de una misma imagen o dos fotografías de una misma escena. 3
En cambio, los pares creados tapando o recortando parte de una observación se clasifican como malas vistas en el artículo. Los autores también interpretan la predicción del siguiente token bajo esta perspectiva. El término ‘malo’ se refiere aquí a la eficiencia de la alineación de representaciones entre modalidades, y no significa que el rendimiento general de los modelos de lenguaje en escritura o codificación sea deficiente. 2
De hipótesis a teorema: las condiciones deben leerse juntas
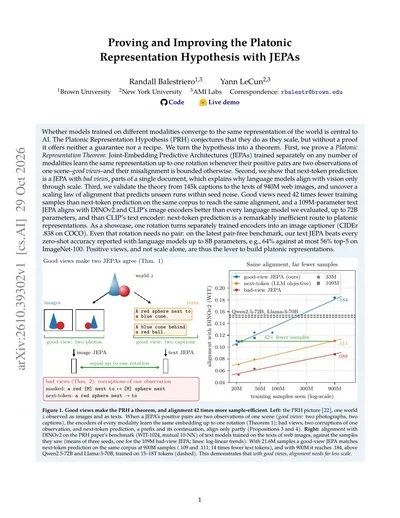
El teorema del artículo posterior trata el hecho de que, bajo la condición de buenas vistas, las representaciones de JEPA entrenado por separado para cada modalidad llegan a ser iguales, excepto por las diferencias debidas a transformaciones rotacionales. Cuando no se cumplen las condiciones, se analiza la frontera de la inconsistencia de representaciones. Por lo tanto, no debe interpretarse como una proposición incondicional del tipo ‘cualquier modelo terminará por tener la misma representación interna’. 2
El repositorio de los autores publica la validación numérica del teorema, el código de entrenamiento, el código de evaluación y los procedimientos para reproducir los experimentos. Es útil poder distinguir entre las suposiciones teóricas y la configuración de los experimentos reales. 3
Las condiciones de comparación del resultado de 42 veces menos muestras
El valor de 42 veces reportado por los autores es una comparación del número de muestras necesarias para alcanzar el mismo nivel de alineación con DINOv2, utilizando el mismo codificador de 109M parámetros y el mismo corpus. Las buenas vistas utilizaron 21.6M muestras, mientras que la predicción del siguiente token usó 900M muestras. No significa que el costo total de entrenamiento se redujera en 42 veces en todas las condiciones. 3
En una evaluación independiente con WIT-1024, la puntuación de alineación de JEPA de texto de 109M con DINOv2-B fue superior a la de los modelos de lenguaje de comparación. 3
| Modelo comparado | Escala de parámetros | Puntuación de alineación con DINOv2-B |
|---|---|---|
| JEPA de texto | 109M | 0.184 |
| Qwen2.5-72B | 72B | 0.154 |
| Llama-3-70B | 70B | 0.151 |
Los indicadores en esta tabla miden la alineación de representaciones. No es una comparación en la que un JEPA pequeño sustituya todas las funcionalidades de los grandes LLMs. El repositorio especifica tanto los resultados base como las puntuaciones más bajas de semillas adicionales con diferentes pesos de normalización, por lo que, al reproducirlos, deben comprobarse conjuntamente la configuración y las semillas. 3
La generación de descripciones y la alineación sin pares deben distinguirse
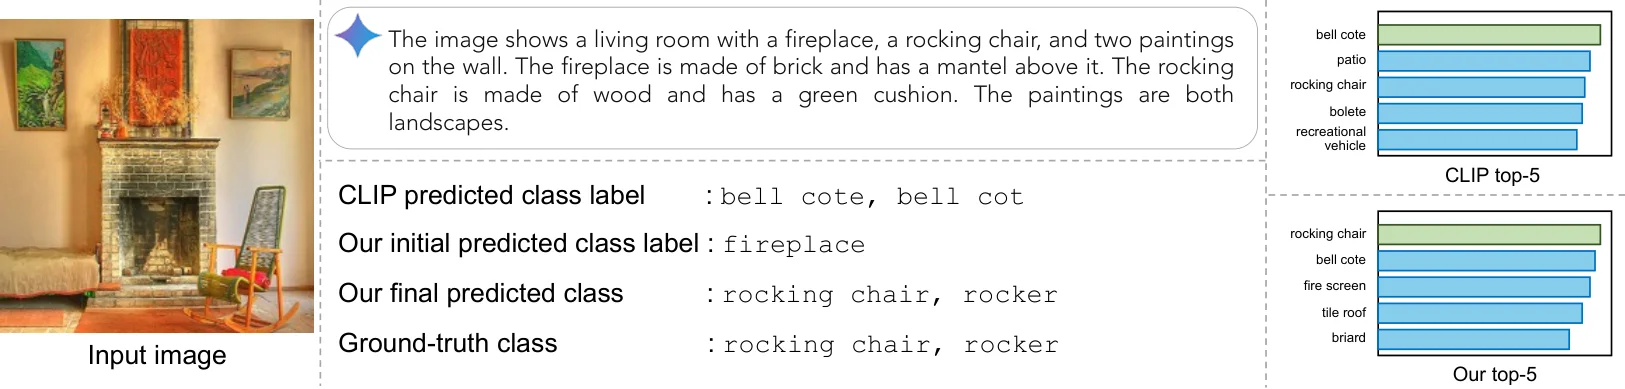
La generación de descripciones de imagen (imagen captioner), como caso de aplicación, conecta mediante una transformación rotacional un codificador de imágenes y un espacio de representaciones de texto entrenados por separado, y crea descripciones con un modelo de lenguaje ajustado con texto fino (fine-tuned). Los autores reportaron un CIDEr de 0.838 en COCO. Este generador de descripciones no entrena conjuntamente la red neuronal con pares imagen-descripción, pero utiliza pares en la etapa de ajuste de la transformación rotacional. 3
En el artículo hay, por separado, experimentos de un banco de pruebas de alineación sin pares. Reportan una precisión top-5 de aproximadamente el 64% en ImageNet-100, en contraste con el máximo del 56% reportado en artículos comparables. Si se mezclan la configuración del generador de descripciones y esta evaluación para explicar que ‘no se necesitan pares en ninguna etapa’, las condiciones experimentales quedan alteradas. 2
Variables de diseño a examinar además del tamaño del modelo
Las preguntas que merece la pena extraer de este estudio son simples. Antes de aumentar el tamaño del modelo, ¿podemos examinar en qué medida comparten las dos observaciones utilizadas para el entrenamiento el mismo estado del mundo?
El código público distingue entre los experimentos que comienzan con pocos datos y los procedimientos para reproducir los experimentos a gran escala. Para verificarlo directamente, es mejor comparar los resultados alineando los codificadores, los datos y las métricas de evaluación tanto de las buenas vistas como de los métodos de comparación. Lo esencial no es la afirmación de que sustituya ya los LLMs, sino cuán importante es la composición de los pares de observaciones como variable de diseño dentro del objetivo de la alineación de representaciones. 3
Referencias
- The Platonic Representation Hypothesis (2024) · arxiv.org↩
- ↩
- 저자 코드·실험 결과·재현 절차: galilai-group/prh-proof · github.com↩



