서로 다른 데이터로 학습한 AI 모델이 비슷한 방식으로 세상을 표현할 수 있을까요? 2024년 발표된 플라톤 표현 가설(PRH)은 시각 모델과 언어 모델의 규모가 커질수록 데이터 사이의 관계를 측정하는 방식이 닮아간다는 관찰에서 출발했습니다. 모든 모델이 이미 같은 표현을 갖는다고 단정한 결과는 아니며, 원논문도 한계와 반례를 함께 다룹니다. 1
2026년 10월 29일 공개된 Randall Balestriero와 Yann LeCun의 후속 논문은 이 문제를 어떤 관측쌍으로 학습하는가라는 관점에서 분석합니다. 저자들은 JEPA에 관한 조건부 정리를 제시하고, 같은 표현 정렬 수준에 도달하는 데 필요한 학습 샘플을 줄인 실험을 보고했습니다. 아래 수치는 논문과 저자 저장소의 보고값이며, 이 블로그에서 직접 재현한 결과는 아닙니다. 2 3
JEPA가 예측하는 것
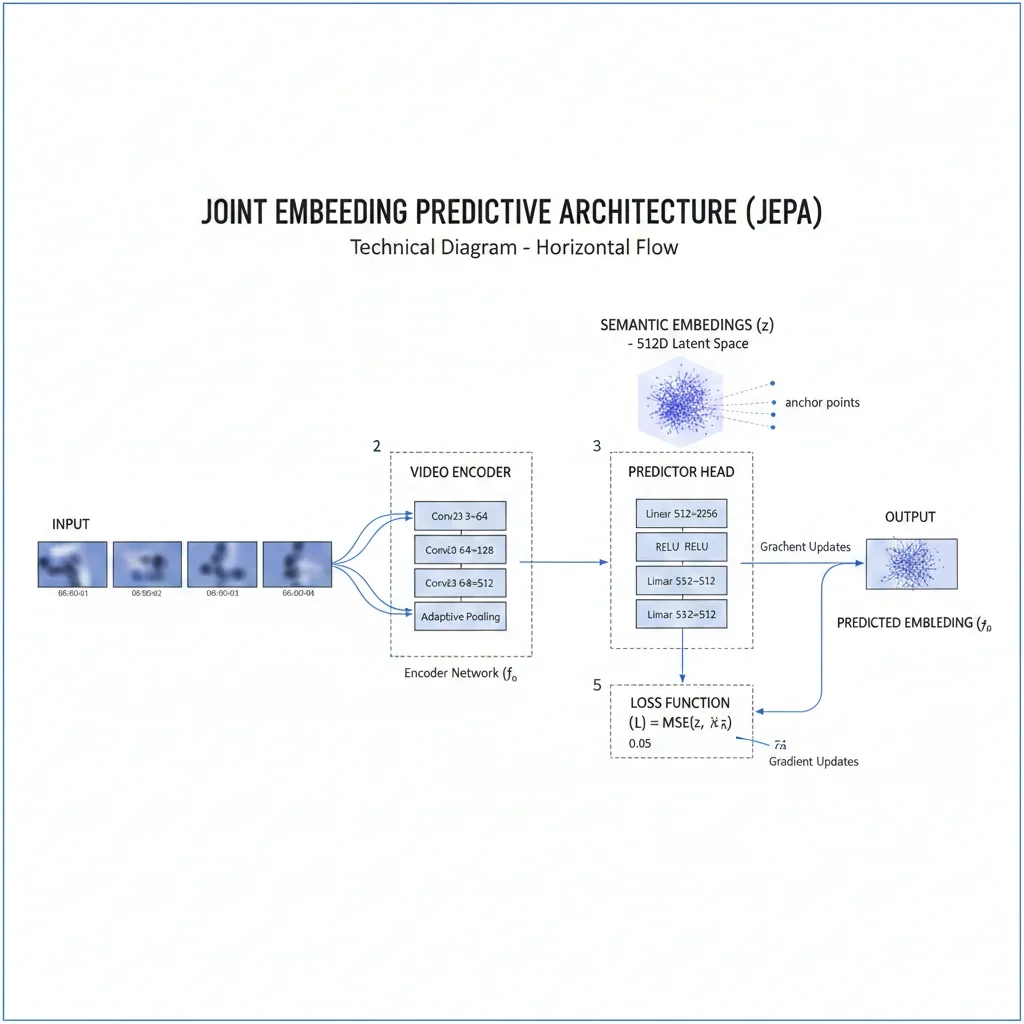
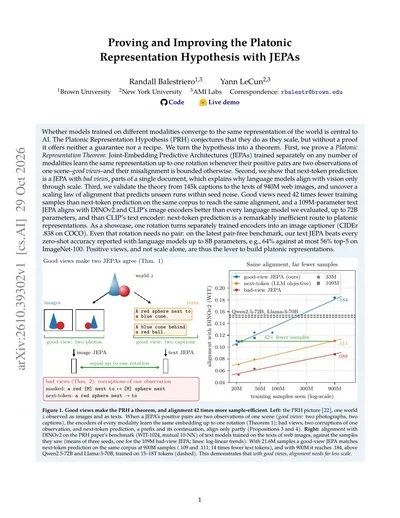
JEPA는 관측한 데이터의 표현에서 다른 관측의 표현을 예측하는 구조입니다. 이 연구에서 중요한 구분은 좋은 뷰(good views)와 나쁜 뷰(bad views)입니다. 좋은 뷰는 같은 장면을 관찰한 두 데이터입니다. 저자들은 한 이미지에 대한 서로 다른 캡션이나 한 장면의 두 사진을 예로 듭니다. 3
반면 한 관측의 일부를 가리거나 잘라 만든 쌍은 논문에서 나쁜 뷰로 분류합니다. 저자들은 다음 토큰 예측도 이 관점에서 해석합니다. 여기서 ‘나쁘다’는 표현은 모달리티 간 표현 정렬의 효율에 관한 것으로, 언어 모델의 글쓰기나 코딩 성능이 전반적으로 나쁘다는 뜻이 아닙니다. 2
가설에서 정리로: 조건을 함께 읽어야 한다
후속 논문의 정리는 좋은 뷰 조건에서 모달리티별로 따로 학습한 JEPA의 표현이 회전 변환의 차이를 제외하면 같아진다는 내용을 다룹니다. 조건이 어긋나는 경우에는 표현 불일치의 경계를 분석합니다. 따라서 이를 ‘어떤 모델이든 결국 동일한 내부 표현을 갖는다’는 무조건적인 명제로 넓혀 읽으면 안 됩니다. 2
저자 저장소에는 정리의 수치 검증, 학습 코드, 평가 코드와 실험 재현 절차가 공개돼 있습니다. 이론의 가정과 실제 실험의 설정을 구분해 확인할 수 있다는 점이 유용합니다. 3
42배 적은 샘플이라는 결과의 비교 조건
저자들이 보고한 42배는 같은 109M 인코더와 같은 코퍼스에서, DINOv2와의 동일한 정렬 수준에 도달하는 데 필요한 샘플 수의 비교입니다. 좋은 뷰 방식은 21.6M, 다음 토큰 예측은 900M 샘플을 사용했습니다. 학습 비용 전체가 모든 조건에서 42배 줄었다는 의미는 아닙니다. 3
별도의 WIT-1024 평가에서는 109M 텍스트 JEPA의 DINOv2-B 정렬 점수가 비교 대상 언어 모델보다 높게 나왔습니다. 3
| 비교 모델 | 파라미터 규모 | DINOv2-B와의 정렬 점수 |
|---|---|---|
| 텍스트 JEPA | 109M | 0.184 |
| Qwen2.5-72B | 72B | 0.154 |
| Llama-3-70B | 70B | 0.151 |
이 표의 지표는 표현 정렬입니다. 작은 JEPA가 대형 LLM의 모든 기능을 대체한다는 비교가 아닙니다. 저장소는 기본 결과뿐 아니라 정규화 가중치를 달리한 추가 시드의 낮은 점수도 명시하므로, 재현할 때는 설정과 시드를 함께 확인해야 합니다. 3
캡셔닝과 쌍 없는 정렬은 구분해야 한다
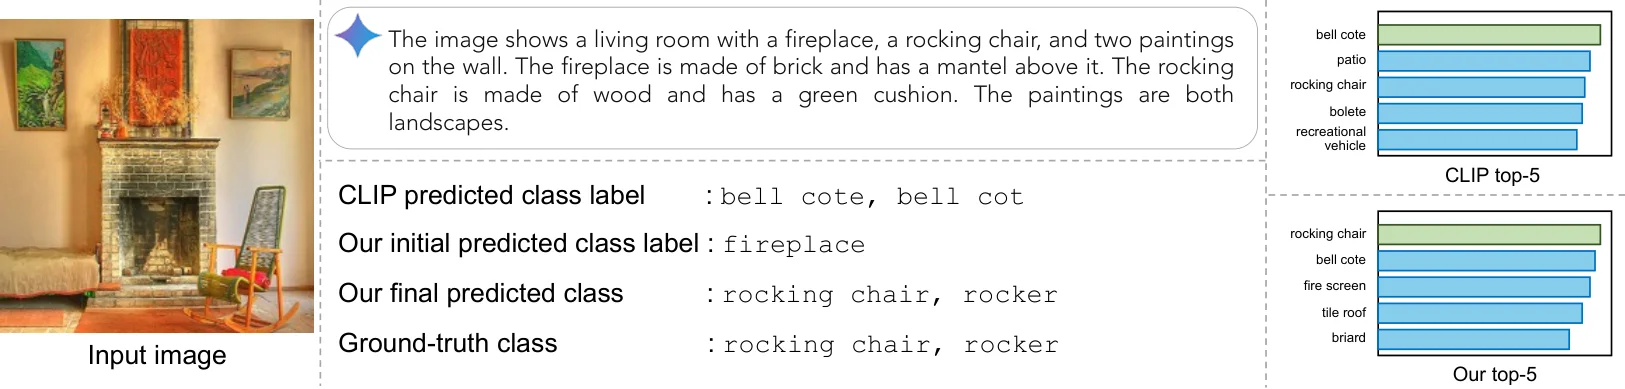
응용 사례인 이미지 캡셔너는 별도로 학습한 이미지 인코더와 텍스트 표현 공간을 회전 사상으로 연결하고, 텍스트로 파인튜닝한 언어 모델로 캡션을 만듭니다. 저자들은 COCO에서 CIDEr 0.838을 보고했습니다. 이 캡셔너는 신경망을 이미지·캡션 쌍으로 공동 학습하지 않지만, 회전 사상을 맞추는 단계에는 쌍을 사용합니다. 3
논문에는 이와 별도로 쌍 없이 정렬하는 벤치마크 실험도 있습니다. ImageNet-100에서 약 64%의 top-5 정확도를 보고하며, 비교 논문에 보고된 최대 56%와 대조합니다. 캡셔너 구성과 이 평가를 하나로 섞어 ‘모든 단계에 쌍이 전혀 필요 없다’고 설명하면 실험 조건이 달라집니다. 2
모델 크기 외에 살펴볼 설계 변수
이번 연구에서 가져갈 만한 질문은 단순합니다. 모델을 키우기 전에, 학습에 사용하는 두 관측이 같은 세계 상태를 얼마나 잘 공유하는지 살펴볼 수 있을까요?
공개 코드에는 작은 데이터로 시작하는 실험과 대규모 실험의 재현 절차가 나뉘어 있습니다. 직접 확인하려면 좋은 뷰와 비교 방식의 인코더·데이터·평가 지표를 맞춰 두고 결과를 비교하는 편이 좋습니다. 핵심은 LLM을 당장 대체한다는 선언보다, 표현 정렬이라는 목표에서 관측쌍의 구성이 얼마나 중요한 설계 변수인지에 있습니다. 3
참고자료
- The Platonic Representation Hypothesis (2024) · arxiv.org↩
- ↩
- 저자 코드·실험 결과·재현 절차: galilai-group/prh-proof · github.com↩