異なるデータで学習したAIモデルが、似たような方法で世界を表現できるだろうか?2024年に発表された**プラトン表現仮説(PRH)**は、視覚モデルと言語モデルのスケーリングが進むにつれて、データ間の関係を測る方法が類似していくという観察から出発した。すべてのモデルがすでに同じ表現を備えていると断じる結論ではなく、原著論文でも限界や反例が併せて議論されている。1
2026年10月29日に公開されたRandall Balestriero氏とYann LeCun氏による後続論文では、この問題をどの観測ペアで学習するかという観点から分析している。著者らはJEPAに関する条件付き定理を提示し、同じレベルの表現アラインメントに到達するために必要な学習サンプル数を削減した実験を報告した。以下の数値は論文および著者リポジトリで報告された値であり、本ブログで独自に再現した結果ではない。2 3
JEPAが予測するもの
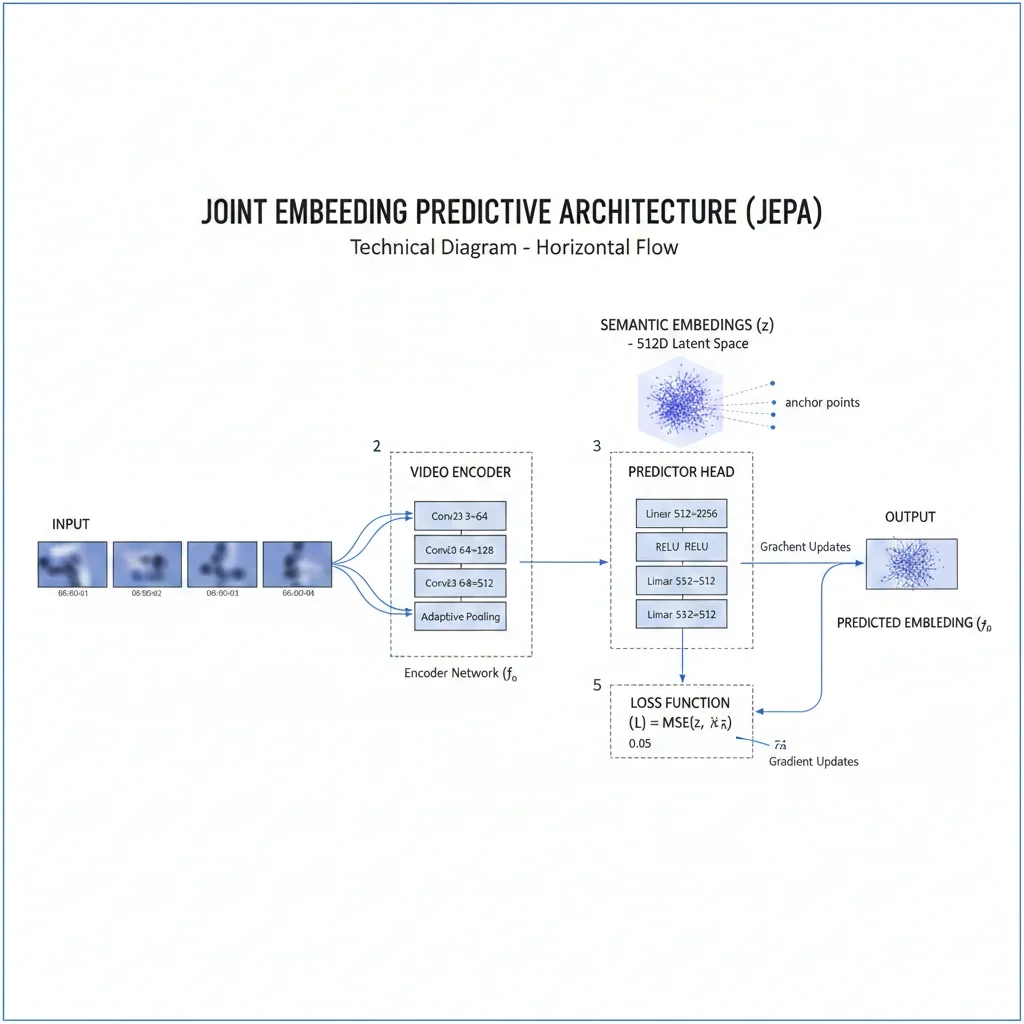
JEPAは、観測したデータの表現から他の観測の表現を予測する構造を持つ。本研究において重要な区別は、**良いビュー(good views)と悪いビュー(bad views)**である。良いビューとは、同じシーンを観察した2つのデータのことだ。著者らは、1枚の画像に対する異なるキャプションや、1つのシーンの2枚の写真を例として挙げている。3
一方、ある観測の一部をマスクしたり切り抜いたりして作成したペアは、論文では悪いビューに分類される。著者らは次のトークン予測についても、この観点から解釈している。ここでいう「悪い」という表現は、モダリティ間表現アラインメントの効率に関するものであり、言語モデルの文章生成やコーディング性能が全体的に劣っているという意味ではない。2
仮説から定理へ:条件を併せて読む必要がある
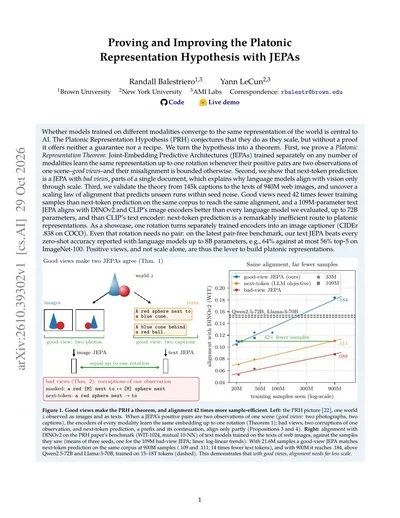
後続論文の定理は、良いビューの条件の下で、モダリティごとに個別に学習したJEPAの表現が、回転変換の差を除いて等しくなるという内容を扱う。条件が満たされない場合には、表現不一致の境界が分析される。したがって、これを「どのモデルも結局、同一の内部表現を備える」という無条件の命題として広く読み替えてはならない。2
著者リポジトリには、定理の検証データ、学習コード、評価コード、および実験再現手順が公開されている。理論の仮定と実際の実験設定を区別して確認できる点が有用だ。3
42分の1のサンプル数という結果の比較条件
著者らが報告した42分の1は、同じ109Mパラメータのエンコーダと同一のコーパスにおいて、DINOv2と同じレベルのアラインメントに到達するために必要なサンプル数の比較である。良いビュー方式では21.6Mサンプル、次のトークン予測では900Mサンプルが使用された。これは、学習コスト全体がすべての条件で42分の1になったという意味ではない。3
別のWIT-1024評価では、109MパラメータのテキストJEPAのDINOv2-Bアラインメントスコアが、比較対象の言語モデルより高かった。3
| 比較モデル | パラメータ規模 | DINOv2-Bとのアラインメントスコア |
|---|---|---|
| テキストJEPA | 109M | 0.184 |
| Qwen2.5-72B | 72B | 0.154 |
| Llama-3-70B | 70B | 0.151 |
この表の指標は表現アラインメントである。小さなJEPAが大規模LLMのすべての機能を置き換えるという比較ではない。リポジトリでは基本結果だけでなく、正規化重みを変更した追加シードでの低いスコアも明記されているため、再現する際は設定とシードを併せて確認する必要がある。3
キャプショニングとペアなしアラインメントは区別すべき
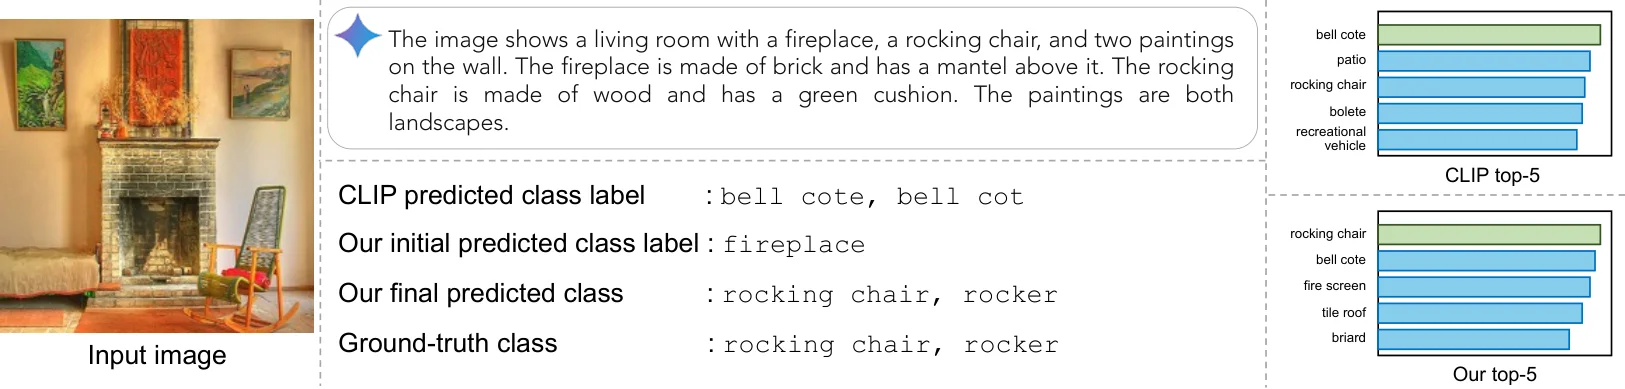
応用事例である画像キャプショナーは、個別に学習した画像エンコーダとテキスト表現空間を回転写像で接続し、テキストでファインチューニングした言語モデルでキャプションを作成する。著者らはCOCOデータセットでCIDErスコア0.838を報告した。このキャプショナーはニューラルネットワークを画像・キャプションのペアで共同学習しないが、回転写像を合わせる段階ではペアを使用する。3
論文にはこれとは別に、ペアなしでアラインメントするベンチマーク実験も含まれている。ImageNet-100において約64%のtop-5精度を報告し、比較論文で報告された最大56%と対比している。キャプショナーの構成とこの評価を混同して「すべての段階でペアが全く必要ない」と説明すると、実験条件が変わってしまう。2
モデルサイズ以外に検討すべき設計変数
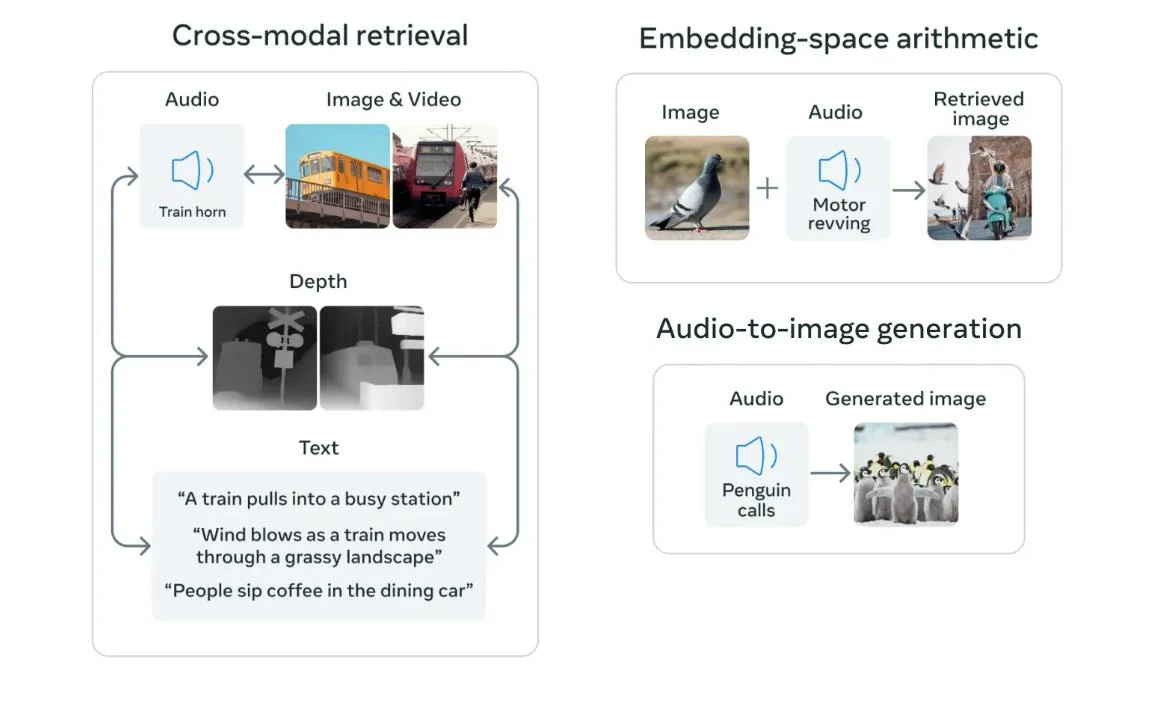
本研究から得られる問いは単純だ。モデルを大きくする前に、学習に使用する2つの観測が同じ世界状態をどれだけ共有しているかを確認できないだろうか?
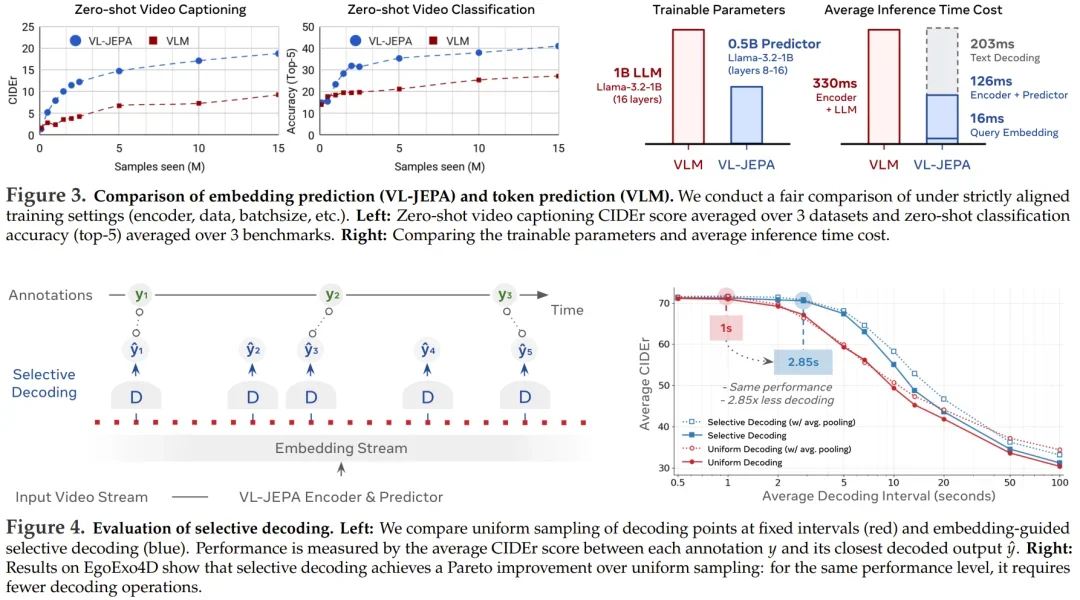
公開コードには、小規模データから始める実験と大規模実験の再現手順が分けて記載されている。自ら確認する場合は、良いビューと比較方式でエンコーダ・データ・評価指標を統一し、結果を比較するのが望ましい。重要なのは、LLMを今すぐ置き換えるという宣言よりも、表現アラインメントという目的において、観測ペアの構成がどれだけ重要な設計変数かという点にある。3
参考文献
- The Platonic Representation Hypothesis (2024) · arxiv.org↩
- ↩
- 저자 코드·실험 결과·재현 절차: galilai-group/prh-proof · github.com↩



