当你把 PDF 文件交给 AI Agent 时,有没有经历过它给出极其愚蠢回答的时刻?
明明肉眼看来布局完整、表格清晰,AI 却会把数字读错,或者完全丢失上下文。数据明明就在那里,提取出来的关键信息却像垃圾一样被揉碎了——作为开发者,这种感觉真的很令人抓狂。
今天,我们将深入探讨为了解决这一顽疾而诞生的创新开源工具:LiteParse。
为什么 AI 一读 PDF 就会变傻?
我们每天接触的 PDF,本质上并不是“易读文档”,而是“易打印文档”。
PDF 的结构并不是按照文本的逻辑流来存储的,而是将文本放置在纸张上的特定坐标上。所有的悲剧都由此开始。
1. 布局的背叛
PDF 的运作机制是基于字符的坐标值,而不是段落的连续顺序。如果解析器错误地解释了这些坐标,就会发生将左栏文字与右栏文字强行合并成一行的灾难性后果。
2. 表格(Table)这一巨大的障碍
最严重的问题在于表格。虽然表格单元格(Cell)中的数据具有逻辑关系,但简单的解析器只会将其识别为“数字的堆砌”。如果本该读作“第一季度营收 100 亿,第二季度营收 120 亿”的内容被读成“1 100 2 120”,AI 就会根据不存在的上下文来胡编乱造答案。
3. 看不见的数据:图像与图表
文档中包含的图表、图形或手写文字,在文本解析器眼中仅仅是“图片”。如果视觉信息无法转换为数据,AI Agent 就会完全错失文档的核心洞察。
最终,现有的许多解析工具面临着两难选择:为了速度必须牺牲准确度;而为了准确度,则必须付出高昂的云端费用和**延迟(Latency)**成本。
救星 LiteParse 登场:在本地实现高性能解析
为了解决这一渴求,LlamaIndex 团队给出了答案:LiteParse。
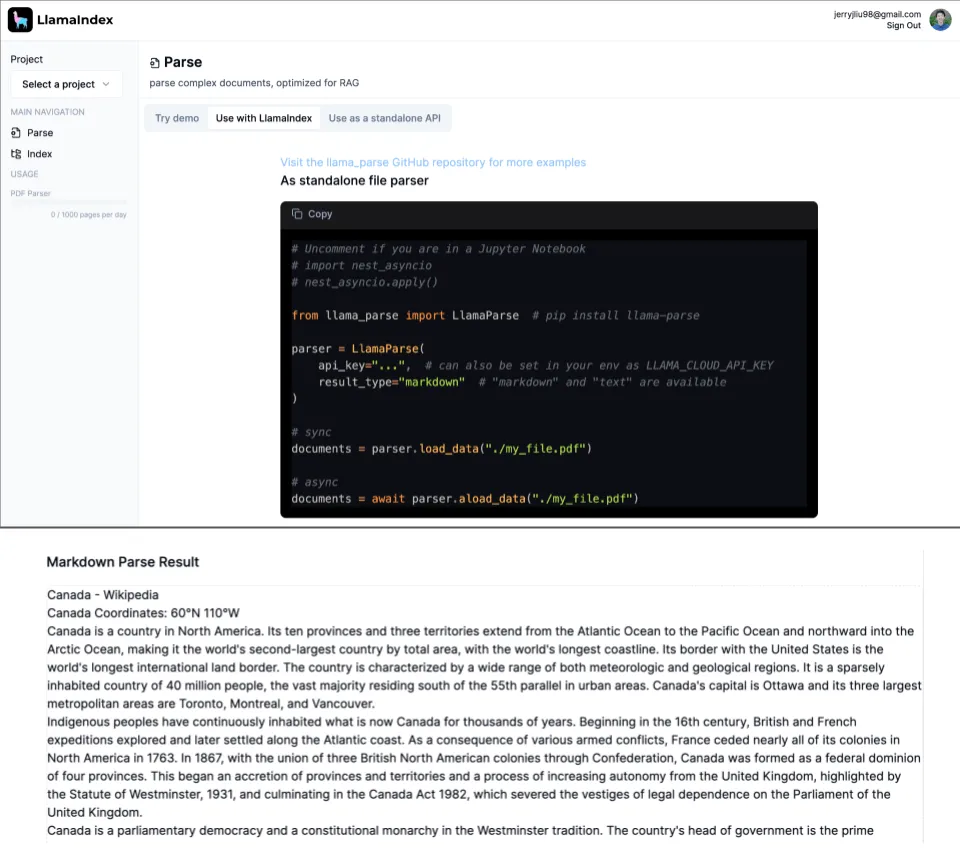
LiteParse 与现有的沉重型云端工具 LlamaParse 有着本质的区别。它的设计理念是:“Agent 应当能够即时且安全地理解文档”。
核心在于“空间网格(Spatial Grid)”方式
LiteParse 不仅仅是抓取文字,它采用了空间布局识别技术来判断文本在文档中的位置。
通过将文本映射到基于坐标的网格中,它最大限度地保留了原始文档的布局。得益于此,AI 可以像人类一样更准确地理解表格结构或段落流。特别是在保持现代 LLM 易于理解的 ASCII 表格形式或缩进结构方面,它表现卓越。
💡 LiteParse 的独到优势
- 压倒性的速度:截至 2026 年,LiteParse 在普通的 CPU 环境下,处理约 500 页的文档仅需约 2 秒。无需 GPU,即可直接投入实时 Agent 工作流。
- 完全本地运行:无需调用云端 API。对于数据隐私至关重要的企业环境,或是互联网连接受限的本地 AI 环境(Local LLM),这具有巨大的吸引力。
- 多格式支持:不仅支持 PDF,还支持 Word (DOCX)、Excel (XLSX)、PowerPoint (PPTX) 以及图像文件。(注:处理 Office 文件需要安装 LibreOffice。)
- 灵活的扩展性:除了内置的 Tesseract OCR,还可以通过 HTTP 服务器轻松联动 EasyOCR 或 PaddleOCR 等外部 OCR 引擎。
LiteParse vs LlamaParse:该如何选择?
这是很多人会产生疑问的问题:“那以前常用的 LlamaParse 就不需要了吗?”
结论是:“这两者不是竞争关系,而是互补关系”。根据用途,选择标准非常明确。
| 特征 | LiteParse (本地/轻量) | LlamaParse (云端/精密) |
|---|---|---|
| 主要目标 | 编程 Agent、实时流水线 | 文档智能 (Document Intelligence) 产品 |
| 核心价值 | 速度、低成本、本地安全 | 极致准确度、复杂的布局分析 |
| 运行环境 | 本地 PC、端侧设备 | 基于云端的服务 |
| 推荐场景 | Agent 需要快速读取文档并执行动作时 | 需要完美提取表格和 Markdown 结构时 |
LiteParse 针对 Agent 需要快速浏览文档并立即执行后续任务的“执行型”任务进行了优化。而 LlamaParse 则更适合需要完美分析文档细微结构并将其数据库化的“分析型”任务。
LiteParse 实战演练:从安装到运行
LiteParse 的一大魅力在于其对开发者友好的接口。无需复杂配置,只需几行命令即可开始。
1. 简便安装
可以通过你所使用的语言的包管理器进行安装。Python 用户使用 pip,Node.js 用户使用 npm。
# Python 环境
pip install liteparse

# Node.js 环境
npm i @llamaindex/liteparse
2. 通过 CLI 直接测试
安装完成后,你可以直接在终端尝试解析文档。
# 将 PDF 解析为文本
lite-parse document.pdf

# 以包含详细信息的 JSON 格式提取(包含边界框、字体信息等)
lite-parse document.pdf --format json
3. 高级应用:生成截图
如果你觉得仅靠提取的文本还不够,可以尝试 LiteParse 的强大功能——截图提取。你可以将特定页面转换为高质量的 PNG,并将其作为视觉输入传递给 LLM。这是让 Agent 通过“观察”文档布局来进行判断的“超调优 Agent 模式”的核心。
注意事项:在处理 Office 文档或图像时,系统需安装 LibreOffice 和 ImageMagick。如果是 macOS 用户,建议通过
brew install提前准备好;Ubuntu 用户则使用apt-get install。
结语:AI Agent 的新标准
LiteParse 不仅仅是一个库。它是试图解决 AI 理解世界的方式——即“数据读取”阶段瓶颈的一次尝试。
如果你担心数据安全、感到云端 API 成本沉重,或者希望将 Agent 的响应速度再缩短哪怕 1 秒,那么 LiteParse 就不是一个选项,而是必选项。
归根结底,AI 的智能取决于输入数据的质量。通过 LiteParse,为你的 AI Agent 赋予一双更清晰、更准确的“眼睛”,如何呢?
在构建 AI Agent 时,你认为“速度”和“准确度”哪一个更重要?欢迎在评论区分享你的看法!
参考资料
- What is LiteParse? | Developer Documentation - LlamaParse · developers.llamaindex.ai
- LiteParse: Local Document Parsing for AI Agents - LlamaIndex · llamaindex.ai
- LiteParse vs LlamaParse: Choosing the Right Document Parser · linkedin.com
- LiteParse by LlamaIndex: Fast Local PDF Parsing with OCR and ... · levelup.gitconnected.com



