PDFファイルをAIエージェントに投げたとき、エージェントが的外れな回答を返してきた経験はありませんか?
見た目には整った表やレイアウトなのに、AIは数値を読み間違えたり、文脈を完全に読み飛ばしたりすることがあります。データは大量にあるのに、肝心な情報がゴミのように崩れて出てくるこの状況は、開発者として非常にストレスが溜まるものです。
今日は、この慢性的な問題を解決するために登場した革新的なオープンソースツール、LiteParseについて深く掘り下げていきます。
なぜAIはPDFを読むとバカになってしまうのか?
私たちが日々接するPDFは、実は「読みやすい文書」ではなく「印刷しやすい文書」です。
PDFの構造は、テキストを論理的な流れではなく、紙の上の特定の座標に配置する方式で保存されます。ここですべての悲劇が始まります。
1. レイアウトの裏切り
PDFは段落が続く順序ではなく、文字が位置する座標値に基づいて動作します。パーサーがこの座標を誤って解釈すると、左カラムの文字と右カラムの文字を一行にまとめてしまうという大惨事が発生します。
2. 「表(Table)」という巨大な壁
最も深刻な問題は表です。表のセル(Cell)内にあるデータは論理的な関係を持っていますが、単純なパーサーはこれを単なる「数値の羅列」として認識してしまいます。「第1四半期売上100億、第2四半期売上120億」と読むべきところを「1 100 2 120」のように読んでしまうと、AIは存在しない文脈を想像して回答してしまいます。
3. 見えないデータ、画像とチャート
文書に含まれるチャートやグラフ、手書き文字は、テキストパーサーの目には単なる「絵」に過ぎません。視覚情報がデータに変換されなければ、AIエージェントは文書の核心的なインサイトを完全に見失ってしまいます。
結局、既存の多くのパーシングツールは、速度を取れば正確度を諦め、正確度を取ればクラウドコストと**遅延時間(Latency)**という巨大なコストを支払わなければなりませんでした。
救世主 LiteParse の登場:ローカルで実現する高性能パーシング
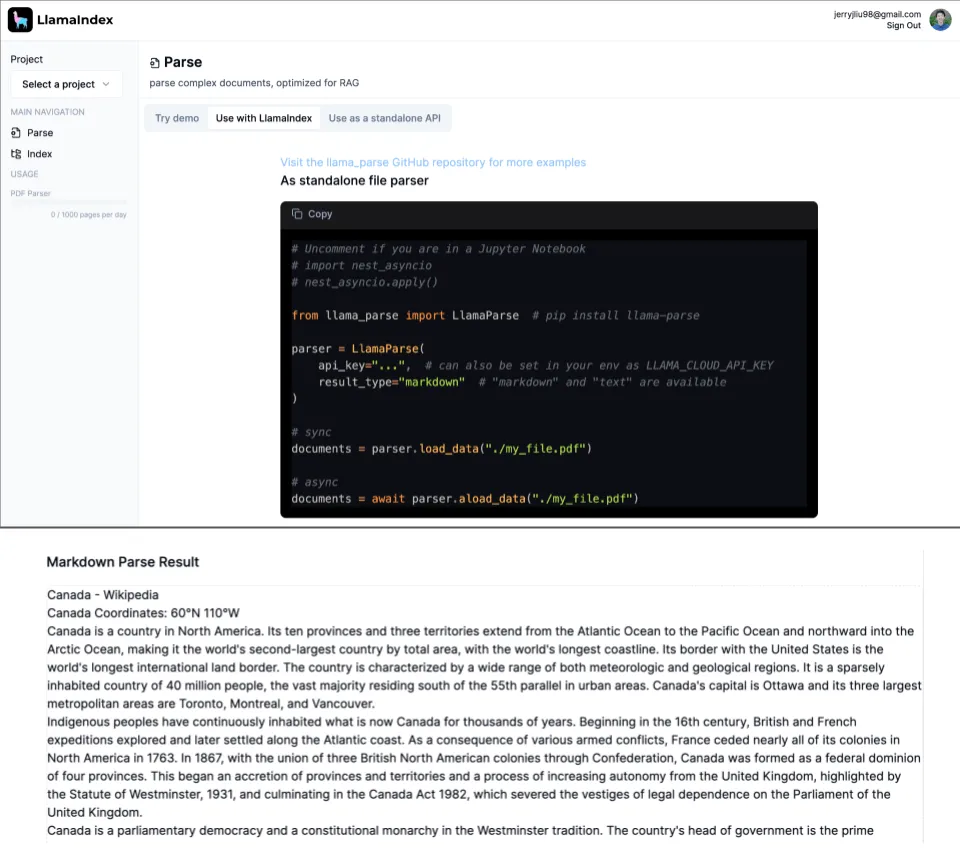
この渇望を解消するためにLlamaIndexチームが打ち出した答えが、LiteParseです。
LiteParseは、既存の重いクラウドベースのツールであるLlamaParseとは性質が異なります。このツールは「エージェントが即座に、そして安全に文書を理解できなければならない」という哲学の下で設計されています。
核となるのは「空間的グリッド(Spatial Grid)」方式
LiteParseは単に文字をかき集めるだけではありません。テキストが文書のどこに位置しているかを把握する空間的レイアウト認識技術を使用しています。
テキストを座標ベースのグリッドにマッピングすることで、元の文書の配置を最大限に保持します。これにより、AIは表の構造や段落の流れを、より人間に近い形で把握できるようになります。特に、現代のLLMが理解しやすいASCIIテーブル形式やインデント構造を維持することに優れています。
💡 LiteParseが持つ独自の強み
- 圧倒的な速度: 2026年現在、LiteParseは一般的なCPU環境でも約500ページ分の文書をわずか2秒で処理できるほど高速です。GPUなしでもリアルタイムのエージェントワークフローに即投入できます。
- 完全なローカル実行: クラウドAPIを呼び出す必要がありません。これはデータプライバシーが重要な企業環境や、インターネット接続が制限されたローカルAI環境(Local LLM)において大きなメリットとなります。
- マルチフォーマット対応: PDFはもちろん、Word(DOCX)、Excel(XLSX)、PowerPoint(PPTX)および画像ファイルまで処理可能です。(ただし、Officeファイルの処理にはLibreOfficeのインストールが必要です。)
- 柔軟な拡張性: 内蔵されたTesseract OCRだけでなく、HTTPサーバーを通じてEasyOCRやPaddleOCRのような外部OCRエンジンとも簡単に連携できます。
LiteParse vs LlamaParse:どちらを選択すべきか?
多くの方が疑問に思う質問です。「では、これまで使っていたLlamaParseはもう必要ないのですか?」
結論から申し上げますと、「二つのツールは競合関係ではなく、相互補完的な関係」です。用途によって選択基準は明確です。
| 特徴 | LiteParse (ローカル/軽量) | LlamaParse (クラウド/精密) |
|---|---|---|
| 主なターゲット | コーディングエージェント、リアルタイムパイプライン | ドキュメントインテリジェンス製品 |
| 核心的な価値 | 速度、低コスト、ローカルセキュリティ | 極限の正確度、複雑なレイアウト分析 |
| 実行環境 | ローカルPC、オンデバイス | クラウドベースのサービス |
| 推奨シナリオ | エージェントが文書を素早く読み、即座に行動すべきとき | 表やマークダウン構造を完璧に抽出する必要があるとき |
LiteParseは、エージェントが文書を素早くスキャンして即座に次のタスクを実行すべき「実行型」の作業に最適化されています。一方、LlamaParseは、文書の微細な構造まで完璧に分析してデータベース化しなければならない「分析型」の作業に適しています。
LiteParse 実践活用:インストールから実行まで
LiteParseの最大の魅力の一つは、開発者にフレンドリーなインターフェースです。複雑な設定なしに、数行のコマンドですぐに開始できます。
1. 簡単なインストール
使用している言語のパッケージマネージャーを通じてインストールできます。Pythonユーザーなら pip、Node.jsユーザーなら npm を使用してください。
# Python環境
pip install liteparse

# Node.js環境
npm i @llamaindex/liteparse
2. CLIですぐにテスト
インストールが完了したら、ターミナルから直接文書をパースできます。
# PDFをテキストにパース
lite-parse document.pdf

# 詳細情報を含むJSON形式で抽出 (バウンディングボックス、フォント情報などを含む)
lite-parse document.pdf --format json
3. 高度な活用:スクリーンショット生成
もし抽出されたテキストだけでは不十分な場合は、LiteParseの強力な機能であるスクリーンショット抽出を活用してみてください。特定のページを高品質なPNGとして作成し、LLMに視覚的入力を渡すことができます。これは、エージェントが文書のレイアウトを直接「見ながら」判断させる「ハイパーチューニングされたエージェントパターン」の核心です。
注意点: Office文書や画像を処理する際は、システムに LibreOffice と ImageMagick がインストールされている必要があります。macOSなら
brew install、Ubuntuならapt-get installを通じて事前に準備しておくことをお勧めします。
おわりに:AIエージェントの新しい標準
LiteParseは単なるライブラリではありません。これはAIが世界を理解する方法である「データの読み取り」段階におけるボトルネックを解決しようとする試みです。
データセキュリティが心配な方、クラウドAPIのコストが負担な方、あるいはエージェントの応答速度を1秒でも削りたい開発者にとって、LiteParseは選択肢ではなく必須となります。
結局のところ、AIの知能は入力されるデータの品質によって決まります。LiteParseを通じて、皆さんのAIエージェントに、より鮮明で正確な「目」をプレゼントしてみてはいかがでしょうか?
皆さんはAIエージェントを構築する際、「速度」と「正確度」のどちらをより重視しますか?ぜひコメントで皆さんの考えを共有してください!
参考文献
- What is LiteParse? | Developer Documentation - LlamaParse · developers.llamaindex.ai
- LiteParse: Local Document Parsing for AI Agents - LlamaIndex · llamaindex.ai
- LiteParse vs LlamaParse: Choosing the Right Document Parser · linkedin.com
- LiteParse by LlamaIndex: Fast Local PDF Parsing with OCR and ... · levelup.gitconnected.com



