PDF 파일을 AI 에이전트에게 던져줬을 때, 에이전트가 멍청한 대답을 내놓는 경험을 해보셨나요?
분명 눈으로 보기에는 멀쩡한 표와 레이아웃인데, AI는 숫자를 뒤섞어 읽거나 문맥을 완전히 놓치곤 합니다. 데이터는 가득한데 정작 필요한 정보는 쓰레기처럼 뭉개져 나오는 이 상황, 개발자로서 정말 답답한 일이죠.
오늘은 이 고질적인 문제를 해결하기 위해 등장한 혁신적인 오픈소스 도구, LiteParse에 대해 깊이 있게 파헤쳐 보겠습니다.
왜 AI는 PDF만 읽으면 바보가 될까?
우리가 매일 접하는 PDF는 사실 '읽기 좋은 문서'가 아니라 '인쇄하기 좋은 문서'입니다.
PDF의 구조는 텍스트를 논리적인 흐름이 아닌, 종이 위의 특정 좌표에 배치하는 방식으로 저장됩니다. 여기서 모든 비극이 시작됩니다.
1. 레이아웃의 배신
PDF는 문단이 이어지는 순서가 아니라, 글자가 위치한 좌표값을 기반으로 작동합니다. 파서가 이 좌표를 잘못 해석하면, 왼쪽 단의 글자와 오른쪽 단의 글자를 한 줄로 합쳐버리는 대참사가 발생합니다.
2. 표(Table)라는 거대한 벽
가장 심각한 문제는 표입니다. 표의 셀(Cell) 안에 들어있는 데이터들은 논리적인 관계를 맺고 있지만, 단순한 파서는 이를 그냥 "숫자들의 나열"로 인식합니다. "1분기 매출 100억, 2분기 매출 120억"이라고 읽어야 할 것을 "1 100 2 120"처럼 읽어버리면, AI는 존재하지 않는 문맥을 상상해서 답변하게 됩니다.
3. 보이지 않는 데이터, 이미지와 차트
문서에 포함된 차트나 그래프, 손글씨는 텍스트 파서의 눈에는 그저 '그림'일 뿐입니다. 시각적 정보가 데이터로 변환되지 않으면, AI 에이전트는 문서의 핵심적인 통찰력을 완전히 놓치게 됩니다.
결국, 기존의 많은 파싱 도구들은 속도를 택하면 정확도를 포기하고, 정확도를 택하면 클라우드 비용과 지연 시간(Latency)이라는 거대한 비용을 치러야 했습니다.
해결사 LiteParse의 등장: 로컬에서 구현하는 고성능 파싱
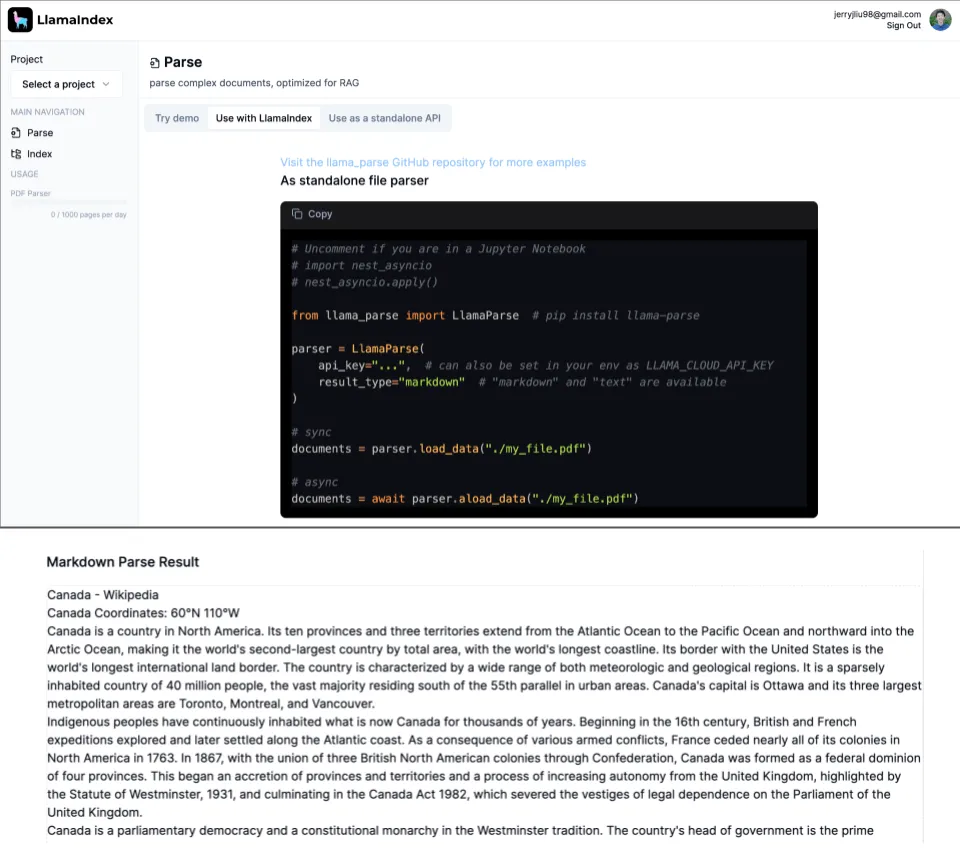
이런 갈증을 해소하기 위해 LlamaIndex 팀이 내놓은 해답이 바로 LiteParse입니다.
LiteParse는 기존의 무거운 클라우드 기반 도구인 LlamaParse와는 결이 다릅니다. 이 도구는 "에이전트가 즉각적으로, 그리고 안전하게 문서를 이해할 수 있어야 한다"는 철학 아래 설계되었습니다.
핵심은 '공간적 그리드(Spatial Grid)' 방식
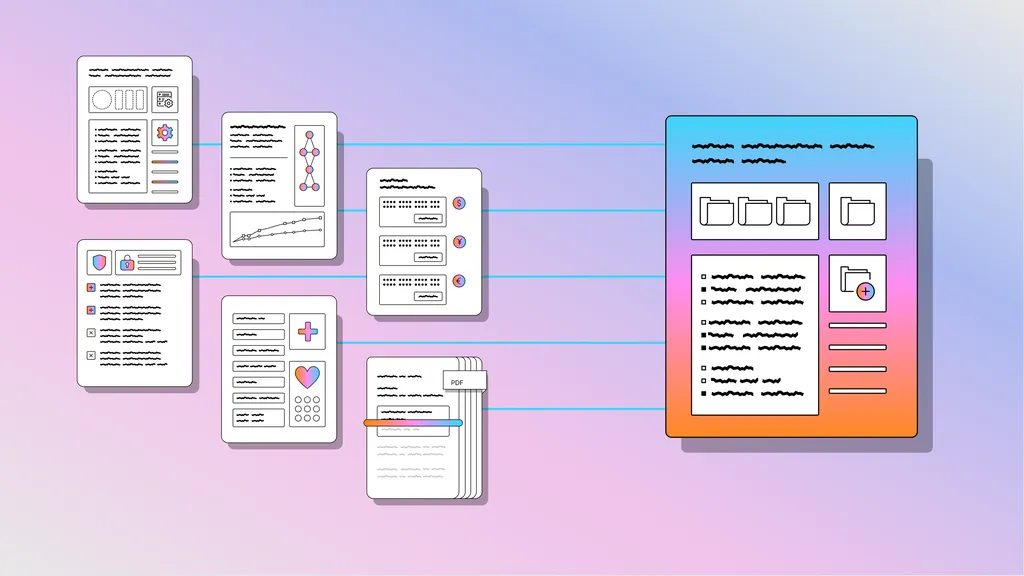
LiteParse는 단순히 글자를 긁어모으는 것에 그치지 않습니다. 텍스트가 문서의 어디에 위치하는지 파악하는 공간적 레이아웃 인식 기술을 사용합니다.
텍알 텍스트를 좌표 기반의 그리드에 매핑함으로써, 원본 문서의 배치를 최대한 보존합니다. 덕분에 AI는 표의 구조나 문단의 흐름을 훨씬 더 인간과 유사하게 파악할 수 있습니다. 특히 현대의 LLM들이 잘 이해하는 ASCII 테이블 형태나 들여쓰기 구조를 유지하는 데 탁월합니다.
💡 LiteParse가 가진 독보적인 강점들
- 압도적인 속도: 2026년 현재, LiteParse는 일반적인 CPU 환경에서도 약 500페이지 분량의 문서를 단 2초 만에 처리할 정도로 빠릅니다. GPU 없이도 실시간 에이전트 워크플로우에 바로 투입할 수 있습니다.
- 완전한 로컬 실행: 클라우드 API를 호출할 필요가 없습니다. 이는 데이터 프라이버시가 중요한 기업 환경이나, 인터넷 연결이 제한된 로컬 AI 환경(Local LLM)에서 엄청난 메리트가 됩니다.
- 멀티 포맷 지원: PDF는 기본이고, Word(DOCX), Excel(XLSX), PowerPoint(PPTX) 및 이미지 파일까지 처리할 수 있습니다. (단, 오피스 파일 처리를 위해 LibreOffice 설치가 필요합니다.)
- 유연한 확장성: 내장된 Tesseract OCR뿐만 아니라, HTTP 서버를 통해 EasyOCR이나 PaddleOCR 같은 외부 OCR 엔진과도 쉽게 연동할 수 있습니다.
LiteParse vs LlamaParse: 무엇을 선택해야 할까?
많은 분이 궁금해하실 질문입니다. "그럼 기존에 잘 쓰던 LlamaParse는 이제 필요 없는 건가요?"
결론부터 말씀드리면, "두 도구는 경쟁 관계가 아니라 상호 보완적 관계"입니다. 용도에 따라 선택의 기준이 명확합니다.
| 특징 | LiteParse (로컬/경량) | LlamaParse (클라우드/정밀) |
|---|---|---|
| 주요 타겟 | 코딩 에이전트, 실시간 파이프라인 | 문서 지능(Document Intelligence) 제품 |
| 핵심 가치 | 속도, 저비용, 로컬 보안 | 극강의 정확도, 복잡한 레이아웃 분석 |
| 실행 환경 | 로컬 PC, 온디바이스 | 클라우드 기반 서비스 |
| 추천 시나리오 | 에이전트가 문서를 빠르게 읽고 행동해야 할 때 | 표와 마크다운 구조를 완벽하게 추출해야 할 때 |
LiteParse는 에이전트가 문서를 훑고 즉시 다음 작업을 수행해야 하는 '실행형' 작업에 최적화되어 있습니다. 반면, LlamaParse는 문서의 아주 미세한 구조까지 완벽하게 분석하여 데이터베이스화해야 하는 '분석형' 작업에 적합합니다.
LiteParse 실전 활용하기: 설치부터 실행까지
LiteParse의 가장 큰 매력 중 하나는 개발자 친화적인 인터페이스입니다. 복잡한 설정 없이 몇 줄의 명령어로 바로 시작할 수 있습니다.
1. 간편한 설치
사용 중인 언어의 패키지 매니저를 통해 설치할 수 있습니다. Python 사용자라면 pip, Node.js 사용자라면 npm을 사용하면 됩니다.
# Python 환경
pip install liteparse

# Node.js 환경
npm i @llamaindex/liteparse
2. CLI로 바로 테스트하기
설치가 완료되었다면, 터미널에서 바로 문서를 파싱해 볼 수 있습니다.
# PDF를 텍스트로 파싱
lite-parse document.pdf

# 상세 정보를 포함한 JSON 형태로 추출 (바운딩 박스, 폰트 정보 등 포함)
lite-parse document.pdf --format json
3. 고급 활용: 스크린샷 생성
만약 텍ista 추출된 텍스트만으로 부족하다면, LiteParse의 강력한 기능인 스크린샷 추출을 활용해 보세요. 특정 페이지를 고품질 PNG로 만들어 LLM에게 시각적 입력을 전달할 수 있습니다. 이는 에이전트가 문서의 레이아웃을 직접 '보면서' 판단하게 만드는 '하이퍼 튜닝된 에이전트 패턴'의 핵심입니다.
주의할 점: 오피스 문서나 이미지를 처리할 때는 시스템에 LibreOffice와 ImageMagick이 설치되어 있어야 합니다. macOS라면
brew install, Ubuntu라면apt-get install을 통해 미리 준비해 두는 것이 좋습니다.
마치며: AI 에이전트의 새로운 표준
LiteParse는 단순한 라이브러리가 아닙니다. 이는 AI가 세상을 이해하는 방식인 '데이터 읽기' 단계에서의 병목 현상을 해결하려는 시도입니다.
데이터 보안이 걱정되거나, 클라우드 API 비용이 부담스럽거나, 혹은 에이전트의 응답 속도를 1초라도 더 줄여야 하는 개발자라면 LiteParse는 선택이 아닌 필수입니다.
결국 AI의 지능은 입력되는 데이터의 품질에 결정됩니다. LiteParse를 통해 여러분의 AI 에이전트에게 더 선명하고 정확한 '눈'을 선물해 보시는 건 어떨까요?
여러분은 AI 에이전트를 구축할 때 '속도'와 '정확도' 중 무엇을 더 중요하게 생각하시나요? 댓글로 여러분의 고민을 공유해 주세요!
참고자료
- What is LiteParse? | Developer Documentation - LlamaParse · developers.llamaindex.ai
- LiteParse: Local Document Parsing for AI Agents - LlamaIndex · llamaindex.ai
- LiteParse vs LlamaParse: Choosing the Right Document Parser · linkedin.com
- LiteParse by LlamaIndex: Fast Local PDF Parsing with OCR and ... · levelup.gitconnected.com