¿Alguna vez ha experimentado que un agente de IA dé respuestas absurdas cuando le entrega un archivo PDF?
Aunque a simple vista las tablas y el diseño parezcan estar en perfecto orden, la IA suele mezclar los números o perder completamente el contexto. Para un desarrollador, es una situación realmente frustrante: los datos están ahí, pero la información necesaria sale fragmentada como si fuera basura.
Hoy, para resolver este problema crónico, exploraremos en profundidad LiteParse, una innovadora herramienta de código abierto que ha surgido para este propósito.
¿Por qué la IA se vuelve "tonta" al leer PDFs?
El PDF que consultamos a diario no es en realidad un "documento diseñado para ser leído", sino un "documento diseñado para ser impreso".
La estructura de un PDF no guarda el texto en un flujo lógico, sino que lo posiciona en coordenadas específicas sobre el papel. Aquí es donde comienza toda la tragedia.
1. La traición del diseño (Layout)
El PDF funciona basándose en los valores de las coordenadas donde se ubican los caracteres, no en el orden en que los párrafos se suceden. Si el analizador (parser) interpreta mal estas coordenadas, puede ocurrir el desastre de fusionar el texto de la columna izquierda con el de la derecha en una sola línea.
2. El enorme muro de las tablas (Tables)
El problema más grave son las tablas. Los datos dentro de las celdas de una tabla mantienen una relación lógica, pero un parser simple solo los reconoce como una "secuencia de números". Si en lugar de leer "Ventas Q1: 10 mil, Ventas Q2: 12 mil", lee algo como "1 10 2 12", la IA terminará respondiendo basándose en un contexto inexistente.
3. Datos invisibles: Imágenes y gráficos
Los gráficos, diagramas o la escritura a mano incluidos en el documento son simplemente "imágenes" para un parser de texto. Si la información visual no se convierte en datos, el agente de IA perderá por completo los insights clave del documento.
En última instancia, muchas de las herramientas de parsing existentes se han visto obligadas a elegir: si eligen velocidad, sacrifican precisión; si eligen precisión, deben pagar un alto costo en servicios de nube y latencia.
La llegada de LiteParse: Parsing de alto rendimiento de forma local
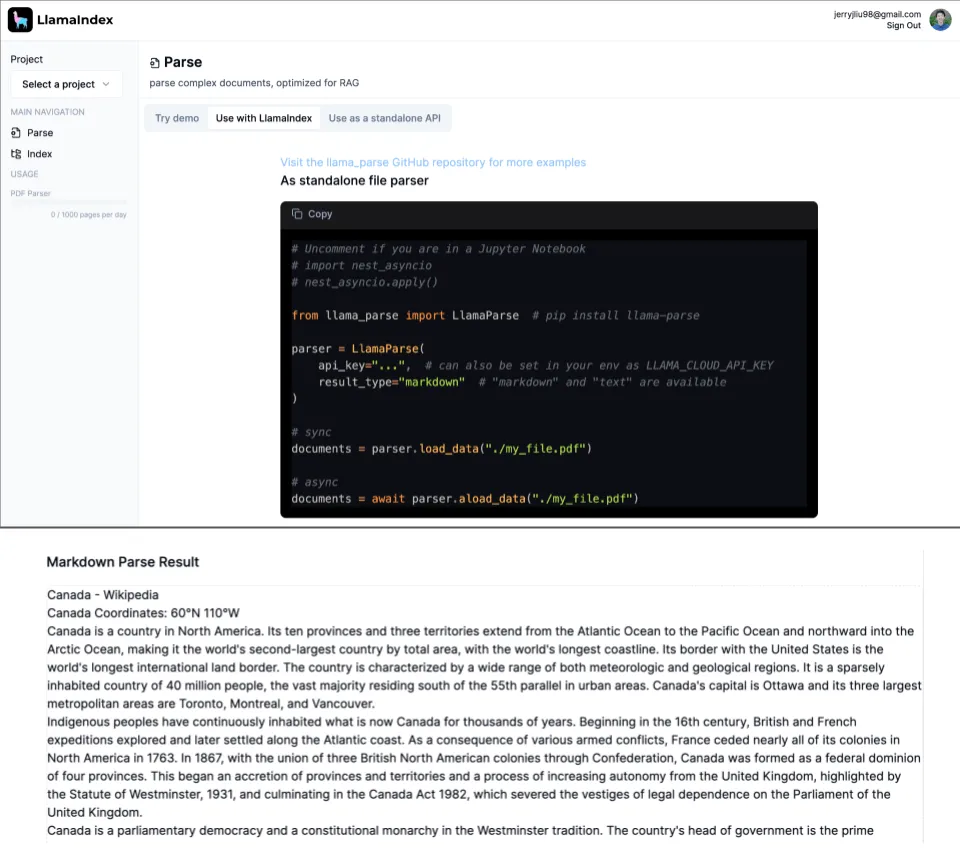
Para satisfacer esta necesidad, el equipo de LlamaIndex ha presentado la solución: LiteParse.
LiteParse tiene un enfoque distinto al de LlamaParse, la herramienta pesada basada en la nube. Esta herramienta fue diseñada bajo la filosofía de que "el agente debe poder comprender los documentos de manera inmediata y segura".
La clave: El método de 'Rejilla Espacial' (Spatial Grid)
LiteParse no se limita a recolectar caracteres. Utiliza tecnología de reconocimiento de diseño espacial para identificar dónde se ubica el texto en el documento.
Al mapear el texto en una rejilla basada en coordenadas, preserva al máximo la disposición del documento original. Gracias a esto, la IA puede comprender la estructura de las tablas o el flujo de los párrafos de una manera mucho más similar a la humana. Es especialmente excelente manteniendo estructuras de sangría o formatos de tablas ASCII que los LLM modernos entienden muy bien.
💡 Fortalezas únicas de LiteParse
- Velocidad abrumadora: En 2026, LiteParse es tan rápido que puede procesar un documento de aproximadamente 500 páginas en solo 2 segundos en un entorno de CPU convencional. Puede integrarse directamente en flujos de trabajo de agentes en tiempo real sin necesidad de una GPU.
- Ejecución local completa: No es necesario llamar a una API en la nube. Esto representa una ventaja enorme en entornos corporativos donde la privacidad de los datos es crucial, o en entornos de IA local (Local LLM) con conexión a internet limitada.
- Soporte multi-formato: Además de PDF, puede procesar archivos Word (DOCX), Excel (XLSX), PowerPoint (PPTX) e incluso imágenes. (Nota: se requiere la instalación de LibreOffice para procesar archivos de Office).
- Escalabilidad flexible: Además del OCR Tesseract integrado, puede conectarse fácilmente con motores de OCR externos como EasyOCR o PaddleOCR a través de un servidor HTTP.
LiteParse vs LlamaParse: ¿Cuál elegir?
Esta es una pregunta frecuente: "¿Entonces ya no necesito el LlamaParse que venía usando?"
La conclusión es: "Ambas herramientas no son competidoras, sino complementarias". El criterio de elección es claro según el uso.
| Característica | LiteParse (Local/Ligero) | LlamaParse (Nube/Preciso) |
|---|---|---|
| Objetivo principal | Agentes de código, pipelines en tiempo real | Productos de Inteligencia de Documentos |
| Valor clave | Velocidad, bajo costo, seguridad local | Precisión extrema, análisis de layouts complejos |
| Entorno de ejecución | PC local, On-device | Servicios basados en la nube |
| Escenario recomendado | Cuando el agente debe leer y actuar rápido | Cuando se debe extraer perfectamente la estructura de tablas y Markdown |
LiteParse está optimizado para tareas de "ejecución", donde el agente debe escanear el documento y actuar de inmediato. Por otro lado, LlamaParse es adecuado para tareas de "análisis", donde se requiere analizar perfectamente hasta la estructura más mínima del documento para convertirla en una base de datos.
Uso práctico de LiteParse: Desde la instalación hasta la ejecución
Uno de los mayores atractivos de LiteParse es su interfaz amigable para desarrolladores. Se puede empezar a usar con unos pocos comandos sin configuraciones complejas.
1. Instalación sencilla
Puede instalarlo a través del gestor de paquetes de su lenguaje preferido. Si es usuario de Python, use pip; si es de Node.js, use npm.
# Entorno Python
pip install liteparse

# Entorno Node.js
npm i @llamaindex/liteparse
2. Probar directamente con la CLI
Una vez terminada la instalación, puede parsear documentos directamente desde la terminal.
# Parsear un PDF a texto
lite-parse document.pdf

# Extraer en formato JSON con información detallada (bounding boxes, info de fuentes, etc.)
lite-parse document.pdf --format json
3. Uso avanzado: Generación de capturas de pantalla (Screenshots)
Si el texto extraído no es suficiente, utilice la potente función de extracción de capturas de pantalla de LiteParse. Puede convertir una página específica en un PNG de alta calidad para entregar una entrada visual al LLM. Esto es clave para el "patrón de agente hiper-ajustado", que permite al agente "ver" directamente el diseño del documento para tomar decisiones.
Nota importante: Al procesar documentos de Office o imágenes, debe tener instalados LibreOffice e ImageMagick en su sistema. En macOS se recomienda usar
brew install, y en Ubuntuapt-get install.
Conclusión: El nuevo estándar para los agentes de IA
LiteParse no es solo una biblioteca. Es un intento de resolver el cuello de botella en la etapa de "lectura de datos", que es la forma en que la IA comprende el mundo.
Si le preocupa la seguridad de los datos, si los costos de las APIs en la nube son una carga, o si es un desarrollador que necesita reducir la respuesta de su agente aunque sea por un segundo, LiteParse no es una opción, es una necesidad.
Al final, la inteligencia de la IA depende de la calidad de los datos de entrada. ¿Qué le parece si le regala a su agente de IA unos "ojos" más claros y precisos a través de LiteParse?
Al construir agentes de IA, ¿qué considera más importante: la 'velocidad' o la 'precisión'? ¡Comparta su opinión en los comentarios!
Referencias
- What is LiteParse? | Developer Documentation - LlamaParse · developers.llamaindex.ai
- LiteParse: Local Document Parsing for AI Agents - LlamaIndex · llamaindex.ai
- LiteParse vs LlamaParse: Choosing the Right Document Parser · linkedin.com
- LiteParse by LlamaIndex: Fast Local PDF Parsing with OCR and ... · levelup.gitconnected.com



