"在等待 AI 生成回答时,您是否只是呆呆地盯着屏幕上的光标?"
在使用 ChatGPT 或 Claude 等大语言模型(LLM)时,我们会遇到所谓的“打字机效果”,即回答是一个字一个字断断续续跳出来的。无论技术如何进步,我们真正想要的其实是像实时对话一样流畅且即时的反应。
特别是对于试图构建企业级服务的开发者或产品经理来说,这种“延迟(Latency)”是决定服务生死存亡的关键问题。因为每秒输出的 Token 数量,将决定用户体验的极高或极低。
今天,2026年5月29日,我们将深入探讨 Kog (Kog AI) 提出的革命性技术,该技术为一举解决这一顽疾提供了可能。
为什么 LLM 会让我们等待?
我们在使用 LLM 时感受到的焦躁并非心理作用,其中存在明确的技术瓶颈。
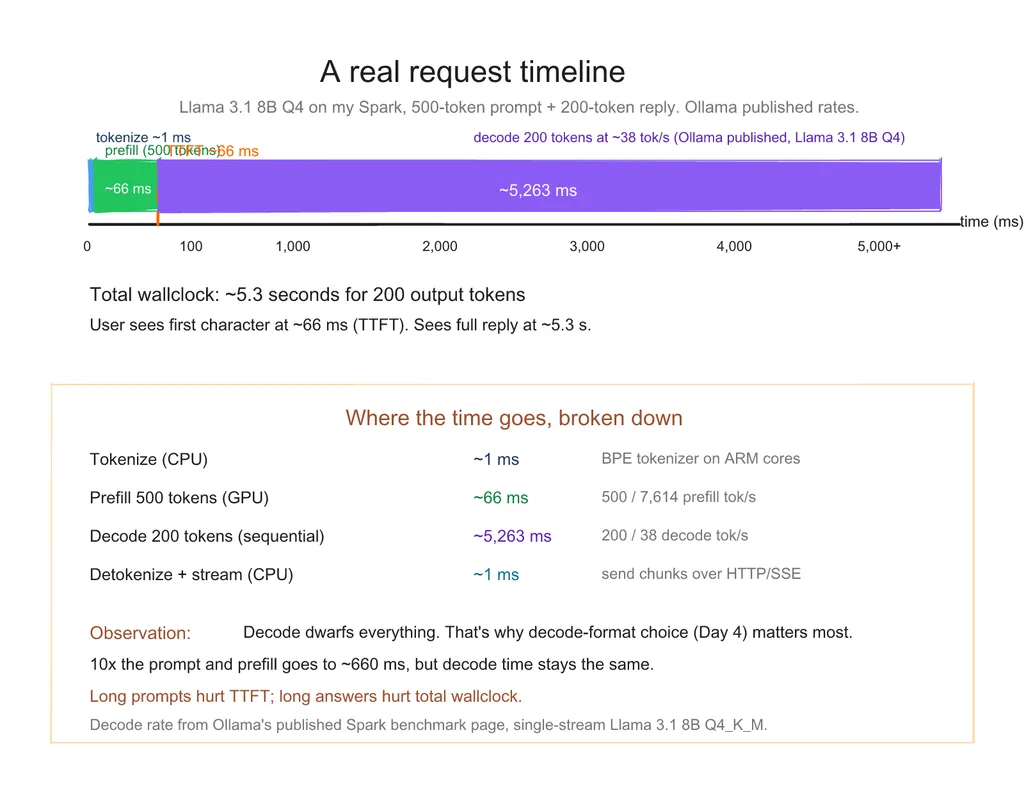
通常情况下,LLM 并不是一次性生成整个句子,而是逐个生成被称为 Token(标记)的词语碎片。这个过程被称为“Token 生成循环(Token-generation loop)”。在传统方式下,每当这个循环运行时,数据都必须在 GPU 和内存之间来回传递。
这就像是一位动作极快的厨师正在做菜,但负责递送食材的助手动作太慢,导致厨师拿着刀却只能呆呆地站在那里。厨师(GPU 计算能力)足够快,但传递食材(内存带宽)的速度跟不上。
此外,随着模型规模的扩大,这种“传递食材”的负担呈指数级增长。在 2026 年的今天,我们渴望更聪明的模型,却陷入了必须忍受更长等待时间的矛盾之中。
Kog 提出的答案:将循环合而为一
在这种情况下,今天 Kog 的发布在业界引起了巨大的轰动。他们并没有去研发全新的专用芯片(ASIC)或引入昂贵的垄断硬件,而是利用我们现有的**标准数据中心 GPU(如 NVIDIA H200 等)**解决了这个问题。
他们解决方案的核心在于“将 Token 生成循环完全封闭在单个 GPU 上下文(Context)之内”。
让我们再次回到刚才那个厨师的比喻。Kog 的方法不是每次都请求助手递送食材,而是直接把所有的食材装在一个大托盘里,整块地放在厨师身边。
具体而言,他们采用了以下创新的软件优化技术:
- Monokernel(单内核)深度挖掘:不再将计算过程切得很碎,而是将其整合为一个巨大的执行单元,从而最大限度地减少了 GPU 内部数据往返产生的开销。
- 延迟张量并行(Delayed Tensor Parallelism):通过智能调整数据处理顺序,寻找最佳时机,使计算设备能够不停歇地工作。
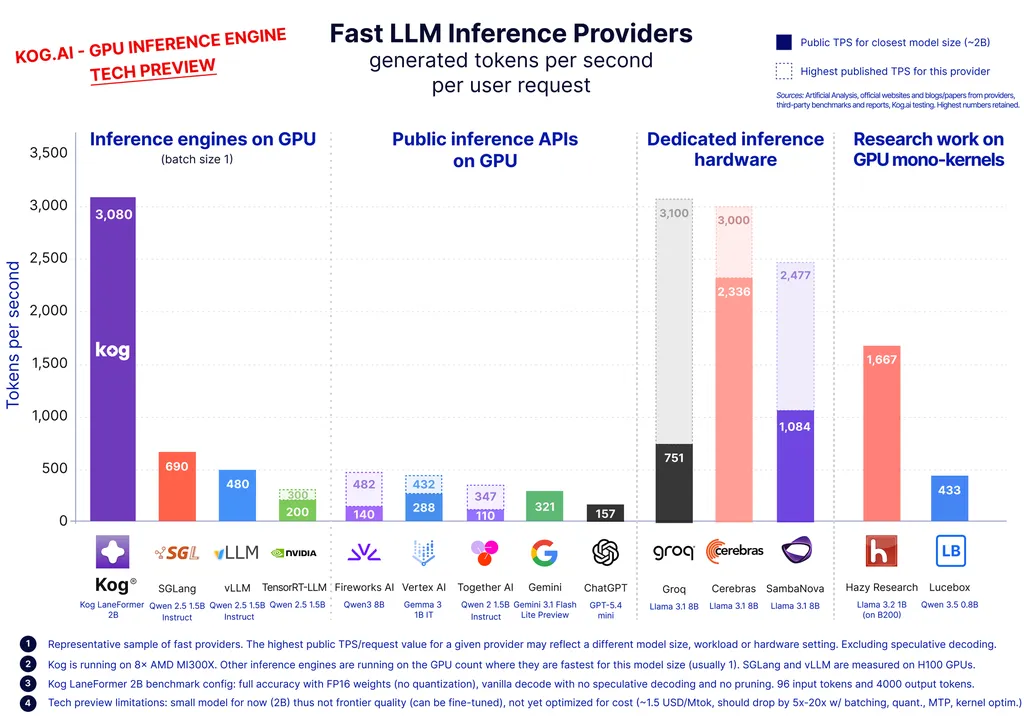
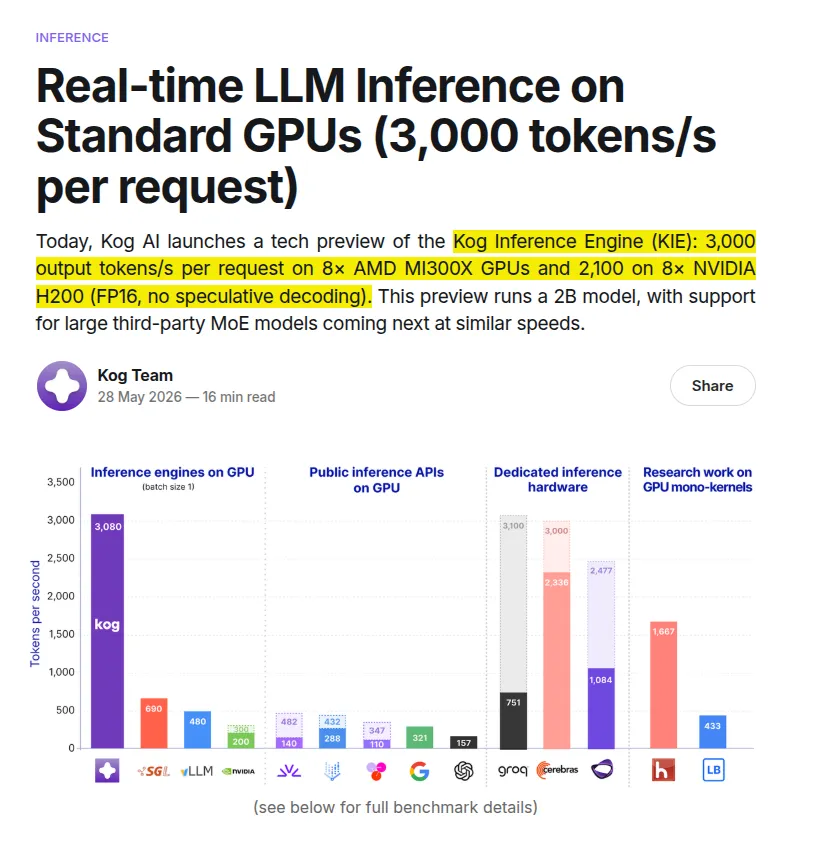
通过这项技术,Kog 在由 8 台标准 GPU 构成的环境中,实现了单次请求每秒 3,000 个 Token (3k tokens/s) 的惊人速度。这意味着实时交互式 AI 输出回答的速度将远超人类的阅读速度。
一切都是玫瑰色的吗?冷静的分析与现实的局限
当然,所有的创新都伴随着争议和局限。专家们甚至针对此次发布展开了激烈的辩论。在我们盲目接受这项技术作为“万能钥匙”之前,有三个点需要考虑。
首先是对比对象的公平性问题。由于初始测试使用的是 2B(20亿参数)规模的极小模型,业界提出了质疑:这种速度在 GPT 级别的巨型模型上是否也能实现?
对此,Kog 的开发者 Gaeld 用数学依据进行了反驳。他的逻辑是,即便模型规模增大,只要调整精度(Precision),就能将内存占用维持在一定水平。例如,如果以 FP8 精度运行 GPT-OSS-120B 这样的模型,其内存占用将与测试的小型模型趋于接近,因此该技术具有充分的可扩展性。
其次是硬件限制。此次成果是在 NVIDIA H200 等高性能数据中心 GPU 上取得的。对于我们家里使用的 RTX 系列等消费级 GPU,由于内存带宽的限制,可能难以完全享受到这种速度。事实上,也有报告称在某些高级消费级 GPU 上的测试速度约为 500 Token/秒。
第三是精度与性能的权衡。另一家公司 Taalas 展示了每秒 15,000 个 Token 的压倒性数据,但那是使用了 3-bit 量化(Quantization)这种极端压缩技术的结果。也就是说,我们必须记住,为了速度,可能需要在一定程度上牺牲模型的“智能(精度)”。
AI 服务的未来:人人都能使用实时 AI 的时代
尽管如此,Kog 的这次成就意义绝不轻微。最重要的一点是,这项技术可以在“标准 GPU”上运行。
如果我们每次运行 AI 都必须购买价值数十亿美元的特殊芯片,那么 AI 技术将永远是巨型企业的专利。然而,像 Kog 这样极大化现有基础设施利用率的方式,将加速“AI 技术的民主化”。
现在,中小企业或初创公司也可以利用现有的服务器资源,实现金融咨询 AI、实时医疗辅助 AI,或是无延迟的游戏 NPC 等高阶服务。
2026 年的 AI 市场正在从单纯的“谁更聪明”转向“谁能更快速、更廉价地将其融入实际服务中”的竞争。Kog 的出现,相当于在这场竞争中带上了强力的武器。
总结:等待消失的世界
让我们总结一下今天看到的内容:
- 问题:LLM 在 Token 生成过程中产生的内存带宽瓶颈导致了响应延迟。
- 解决:Kog 通过将 Token 生成循环整合进单个 GPU 上下文的优化技术,实现了每秒 3,000 个 Token 的速度。
- 意义:无需特殊硬件,仅靠标准 GPU 即可实现实时 AI 服务,降低了 AI 应用的门槛。
技术的进步总是伴随着“这真的可能吗?”的疑问与“这真的实用吗?”的反驳。Kog 的技术究竟能否成为所有 AI 服务的标准,还是仅仅停留于特定用途的技术,还需要我们进一步观察。
您认为 AI 的响应速度要达到多快,才会让您觉得是在进行“真正的对话”呢?欢迎在评论区分享您的想法!
What do you think?
参考资料
- Real-time LLM Inference on Standard GPUs: 3k tokens/s per request · news.ycombinator.com
- Kog · x.com



