「AIが回答を生成するまで、画面のカーソルをぼんやりと眺めていらっしゃいましたか?」
ChatGPTやClaudeのような大規模言語モデル(LLM)を使用していると、回答が文字ごとにポツポツと出てくる、いわゆる「タイピング効果」に直面することがあります。技術がいかに進歩したとしても、私たちが求めているのは、リアルタイムの会話のようにスムーズで即時的な反応です。
特に企業向けサービスを構築しようとする開発者やプランナーにとって、この「遅延時間(Latency)」はサービスの生死を分ける致命的な問題となります。1秒間に何トークン生成されるかによって、ユーザーエクスペリエンスが極端に分かれるためです。
今日は、2026年5月29日、この慢性的な問題を一挙に解決する可能性を提示して登場した**Kog(コグAI)**の革新的な技術について、深く掘り下げていきます。
なぜLLMは私たちを待たせるのか?
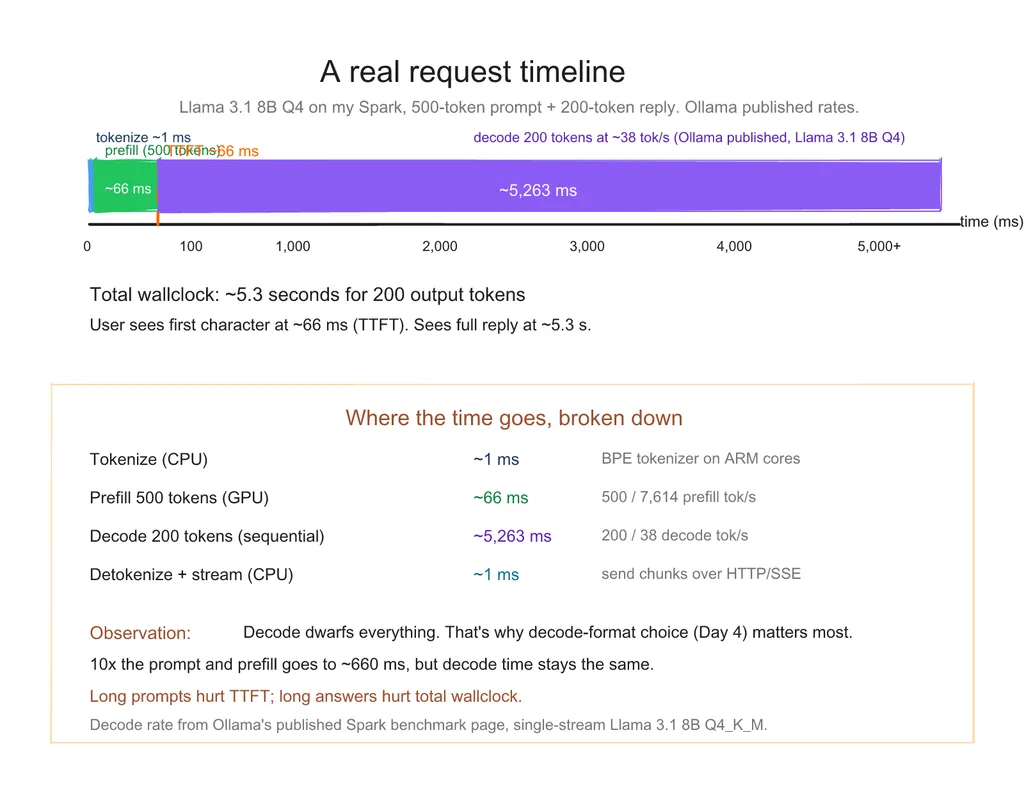
私たちがLLMを使用する時に感じるもどかしさは、単なる気のせいではありません。そこには明確な技術的なボトルネックが存在します。
通常、LLMは一度に文章を作るのではなく、トークン(Token)という単語の断片を一つずつ生成します。この過程を「トークン生成ループ(Token-generation loop)」と呼びますが、従来の方法では、このループが回るたびにGPUとメモリの間を行き来してデータをやり取りしなければなりませんでした。
まるで、非常に速い料理人が料理をしているのに、材料を運んでくる助手があまりにも遅いため、料理人が包丁を持ったままぼんやりと立ち尽くしているような状況です。料理人(GPUの演算能力)は十分に速いのに、材料(メモリ帯域幅)を届ける速度が追いついていないのです。
また、モデルのサイズが大きくなるほど、この「材料の伝達」の負担は幾何級数的に増大します。2026年現在、私たちはより賢いモデルを求めていますが、それと同じだけ長い待ち時間を耐えなければならないという矛盾に陥っています。
Kogが提示した答え:ループを一つにまとめろ
このような状況の中で、本日発表されたKogの発表は業界に大きな波紋を広げています。彼らは特殊な専用チップ(ASIC)を新たに作るなり、高価な独占ハードウェアを持ち込む代わりに、私たちがすでに持っている**標準的なデータセンター用GPU(NVIDIA H200など)**を活用してこの問題を解決しました。
彼らが見出した解決策の核心は、「トークン生成ループを単一のGPUコンテキスト内に完全に閉じ込めること」です。
先ほど例に出した料理人の話をもう一度してみましょう。Kogの方法は、助手に毎回材料を持ってくるよう頼む代わりに、すべての材料を料理人の横にある大きなトレイにまとめて置いておくようなものです。
具体的には、次のような革新的なソフトウェア最適化手法を使用しています。
- モノカーネル(Monokernel)ディープダイブ: 演算プロセスを細かく分割せず、一つの巨大な実行単位としてまとめることで、GPU内部でのデータの往復によるオーバーヘッドを最小限に抑えました。
- 遅延テンソル並列化(Delayed Tensor Parallelism): データ処理の順序をインテリジェントに調整し、演算装置が休みなく働けるよう最適なタイミングを見つけ出します。
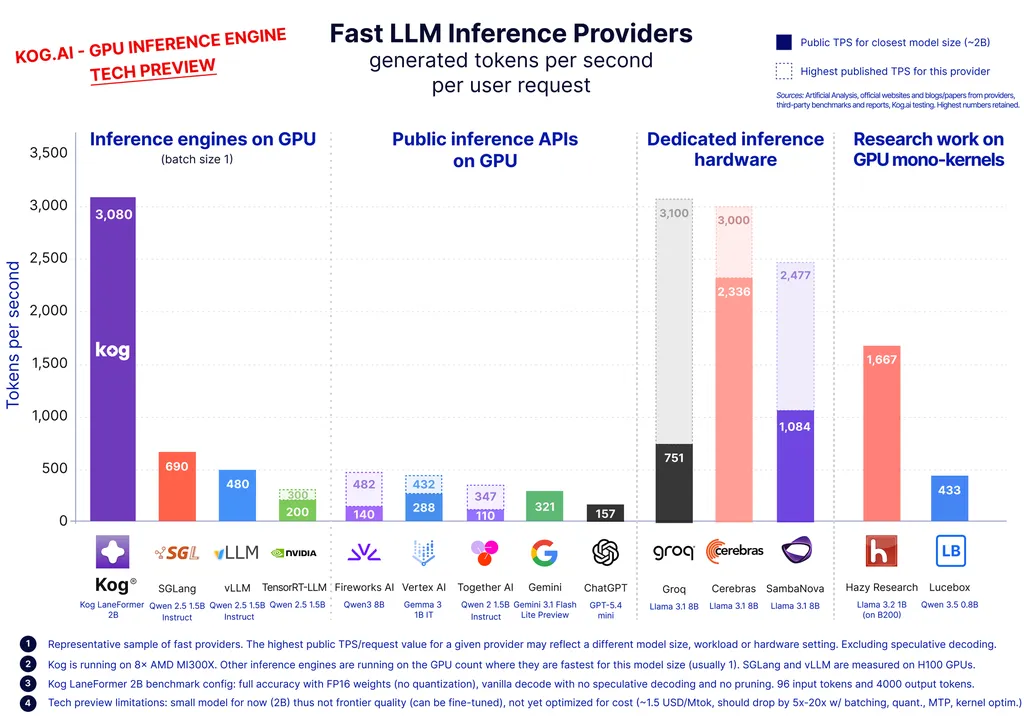
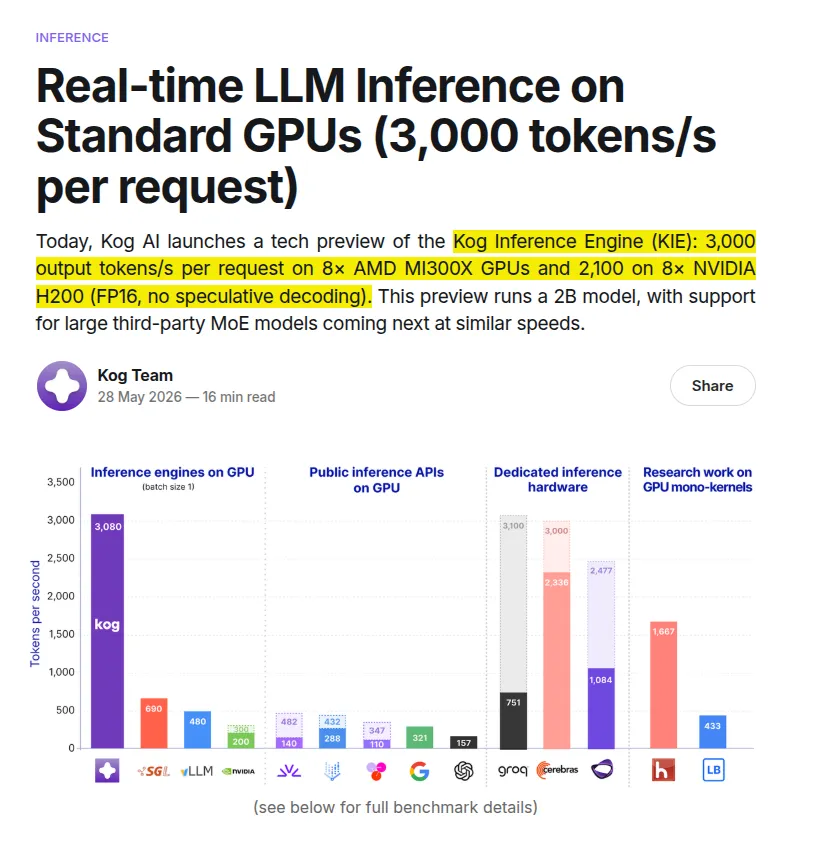
この技術を通じて、Kogは標準的なGPU 8台で構成された環境において、**単一リクエストあたり毎秒3,000トークン(3k tokens/s)**という驚異的な速度を達成しました。これは、リアルタイム対話型AIが人間の読書スピードよりもはるかに速く回答を吐き出せることを意味します。
すべてがバラ色か? 冷静な分析と現実的な限界
もちろん、あらゆる革新には論争と限界がつきものです。専門家の間でも、今回の発表を巡って熱い議論が交わされています。この技術を無条件の「チートキー」として受け入れる前に、考慮すべき3つのポイントがあります。
第一に、比較対象の公平性の問題です。初期テストで使用されたモデルが2B(20億パラメータ)規模の非常に小さなモデルであったため、GPT級の巨大モデルでもこの速度が出るのかという疑問が投げかけられています。
これに対し、Kogの開発者ゲイルド(Gaeld)は数学的な根拠をもって反論しました。モデルのサイズが大きくなっても、精度(Precision)を調整すればメモリ占有率を一定の水準に維持できるという論理です。例えば、GPT-OSS-120BのようなモデルをFP8精度で動かせば、テストされた小さなモデルとメモリ使用量が近くなるため、十分に拡張可能であると説明しています。
第二に、ハードウェアの制約です。今回の成果は、NVIDIA H200のような高性能データセンター用GPUで得られた結果です。私たちが家庭で使うRTXシリーズのような消費者用GPUでは、メモリ帯域幅の限界により、この速度を十分に享受できない可能性があります。実際に一部のテストでは、ハイエンドの消費者用GPUで毎秒約500トークン程度の速度が出たという報告もあります。
第三に、精度と性能のトレードオフです。他の企業であるTaalasが毎秒15,000トークンという圧倒的な数値を提示することもありましたが、これは3ビット量子化(Quantization)という極端な圧縮技術を使用した結果でした。つまり、速度のためにモデルの「知能(精度)」をある程度犠牲にしなければならない可能性があることを、私たちは忘れてはなりません。
AIサービスの未来:誰もがリアルタイムAIを使える時代
それでもなお、Kogの今回の成果が持つ意味は決して軽くありません。最も重要なのは、この技術が「標準的なGPU」で動作するという点です。
もし私たちがAIを動かすたびに、数十億円もする特殊なチップを買わなければならないとしたら、AI技術は巨大企業の独占物にとどまっていたでしょう。しかし、Kogのように既存のインフラを最大限に活用する方式は、「AI技術の民主化」を加速させます。
これにより、中小企業やスタートアップも既存のサーバーリソースを活用して、金融相談AI、リアルタイム医療補助AI、あるいは遅延のないゲームNPCといった高度なサービスを実装できるようになります。
2026年のAI市場は、単に「誰がより賢いか」を超えて、「誰がより速く、より安く、実際のサービスに組み込めるか」の戦いに移行しています。Kogはその戦いにおいて、強力な武器を手に現れたと言えます。
まとめ:待ち時間が消えた世界
今日見てきた内容を整理します。
- 問題: LLMのトークン生成過程で発生するメモリ帯域幅のボトルネックが、応答の遅延を引き起こす。
- 解決: Kogはトークン生成ループを単一のGPUコンテキスト内に統合する最適化技術により、毎秒3,000トークンの速度を達成した。
- 意味: 特殊なハードウェアなしで標準的なGPUでもリアルタイムAIサービスが可能になり、AI導入のハードルが下がった。
技術の発展は常に、「これが本当に可能なのか?」という疑問と、「これが本当に実用的か?」という反論の間で進歩してきました。Kogの技術が果たしてすべてのAIサービスの標準となり得るのか、あるいは特定の用途に限定された技術に留まるのかは、もう少し見守る必要がありそうです。
皆さんは、AIの応答速度がどれくらい速くなれば「本当の対話」をしていると感じますか? コメント欄で皆さんの考えを共有してください!
What do you think?
参考文献
- Real-time LLM Inference on Standard GPUs: 3k tokens/s per request · news.ycombinator.com
- Kog · x.com



