"AI가 답변을 생성할 때까지 화면의 커서만 멍하니 바라보고 계셨나요?"
챗GPT나 클로드 같은 대규모 언어 모델(LLM)을 사용하다 보면, 답변이 한 글자씩 툭툭 끊겨 나오는 이른바 '타이핑 효과'를 마주하게 됩니다. 기술이 아무리 발전했다고 해도, 우리가 원하는 건 실시간 대화처럼 매끄럽고 즉각적인 반응이죠.
특히 기업용 서비스를 구축하려는 개발자나 기획자들에게 이 '지연 시간(Latency)'은 서비스의 생사를 결정짓는 치명적인 문제입니다. 초당 몇 토큰이 나오느냐에 따라 사용자 경험이 극과 극으로 갈리기 때문입니다.
오늘은 오늘, 2026년 5월 29일, 이 고질적인 문제를 단숨에 해결할 가능성을 제시하며 등장한 Kog(코그에이아이)의 혁신적인 기술에 대해 깊이 있게 파헤쳐 보겠습니다.
왜 LLM은 우리를 기다리게 만드는 걸까?
우리가 LLM을 사용할 때 느끼는 답답함은 단순한 기분 탓이 아닙니다. 거기에는 명확한 기술적 병목 현상이 존재합니다.
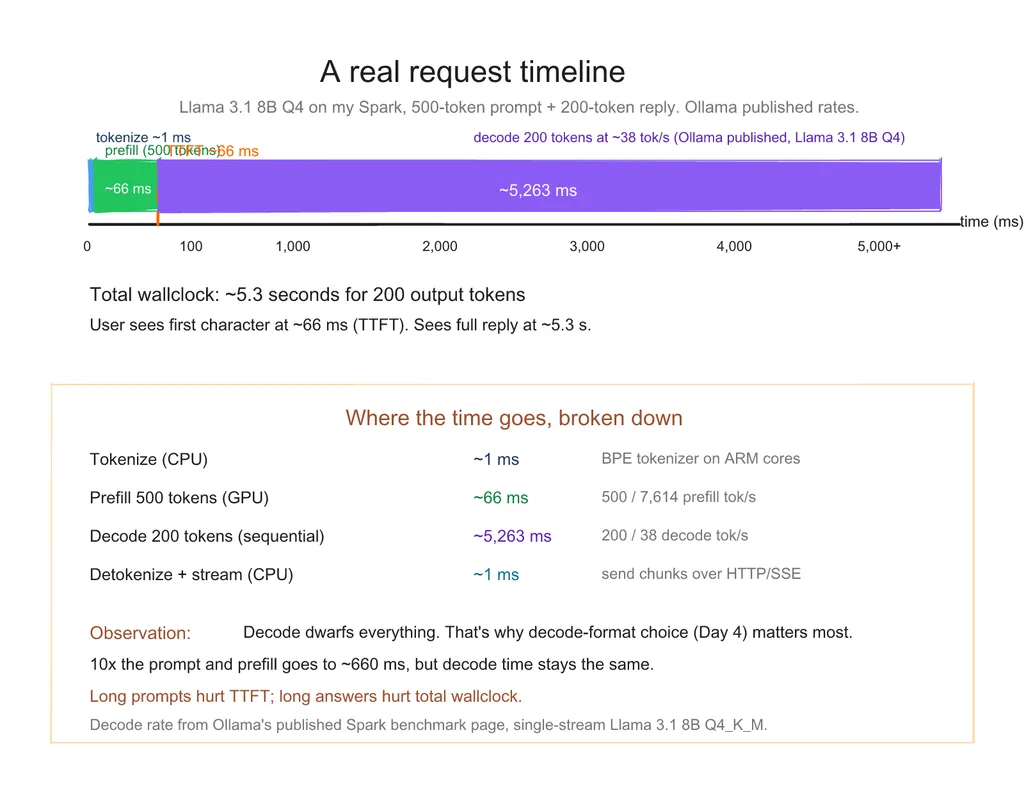
보통 LLM은 한 번에 문장을 만드는 것이 아니라, 토큰(Token)이라는 단어의 조각을 하나씩 생성합니다. 이 과정을 '토큰 생성 루프(Token-generation loop)'라고 부르는데, 기존 방식에서는 이 루프가 돌 때마다 GPU와 메모리 사이를 오가며 데이터를 주고받아야 했습니다.
마치 아주 빠른 요리사가 요리를 하고 있는데, 재료를 가져다주는 보조가 너무 느려서 요리사가 칼을 잡고 멍하니 서 있는 상황과 같습니다. 요리사(GPU 연산 능력)는 충분히 빠른데, 재료(메모리 대역폭)를 전달하는 속도가 따라오지 못하는 것이죠.
또한, 모델의 크기가 커질수록 이 '재료 전달'의 부담은 기하급수적으로 늘어납니다. 2026년 현재, 우리는 더 똑똑한 모델을 원하지만, 그만큼 더 긴 기다림을 감내해야 하는 모순에 빠져 있습니다.
Kog가 제시한 해답: 루프를 하나로 묶어라
이런 상황에서 오늘 등장한 Kog의 발표는 업계에 커다란 파장을 일으키고 있습니다. 그들은 특수한 전용 칩(ASIC)을 새로 만들거나 값비싼 독점 하드웨어를 가져오는 대신, 우리가 이미 가지고 있는 표준 데이터센터 GPU(NVIDIA H200 등)를 활용해 이 문제를 해결했습니다.
그들이 찾아낸 해결책의 핵심은 "토큰 생성 루프를 단일 GPU 컨텍스트 내에 완전히 가두는 것"입니다.
앞서 제가 비유했던 요리사 이야기를 다시 해볼까요? Kog의 방식은 보조에게 재료를 가져다 달라고 매번 요청하는 대신, 모든 재료를 요리사 옆에 커다란 쟁반에 담아 통째로 놓아주는 것과 같습니다.
구체적으로는 다음과 같은 혁신적인 소프트웨어 최적화 기법을 사용했습니다.
- 모노커널(Monokernel) 딥 다이브: 연산 과정을 잘게 쪼개지 않고 하나의 거대한 실행 단위로 묶어, GPU 내부에서 데이터가 왔다 갔다 하는 오버헤드를 최소화했습니다.
- 지연 텐서 병렬화(Delayed Tensor Parallelism): 데이터 처리의 순서를 지능적으로 조정하여, 연산 장치들이 쉬지 않고 일할 수 있도록 최적의 타이밍을 찾아냅니다.
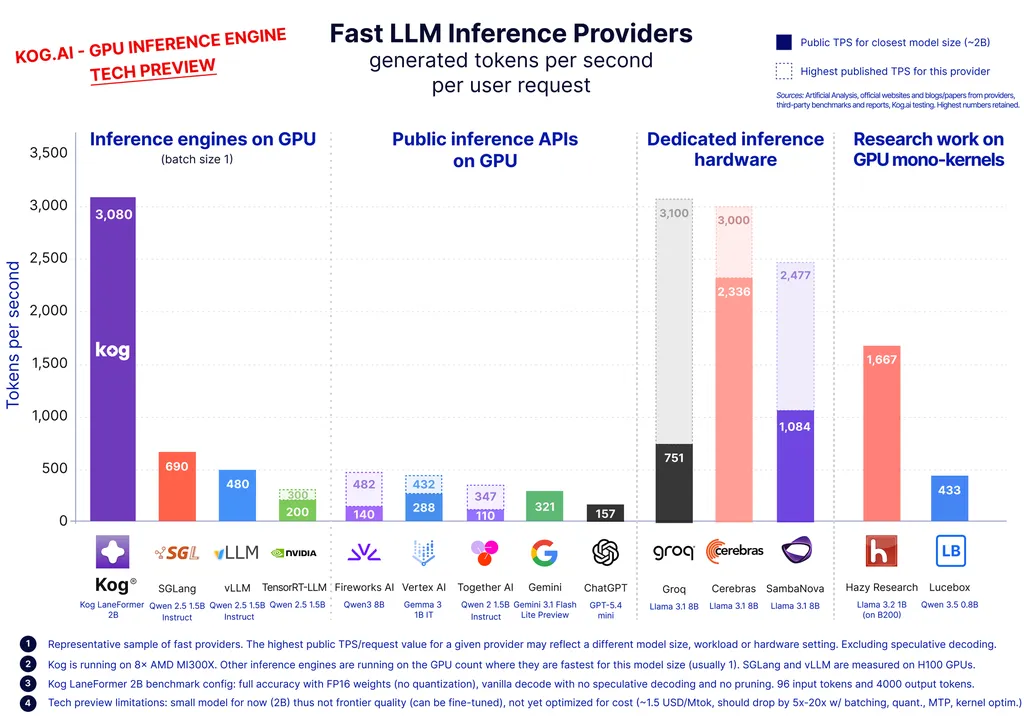
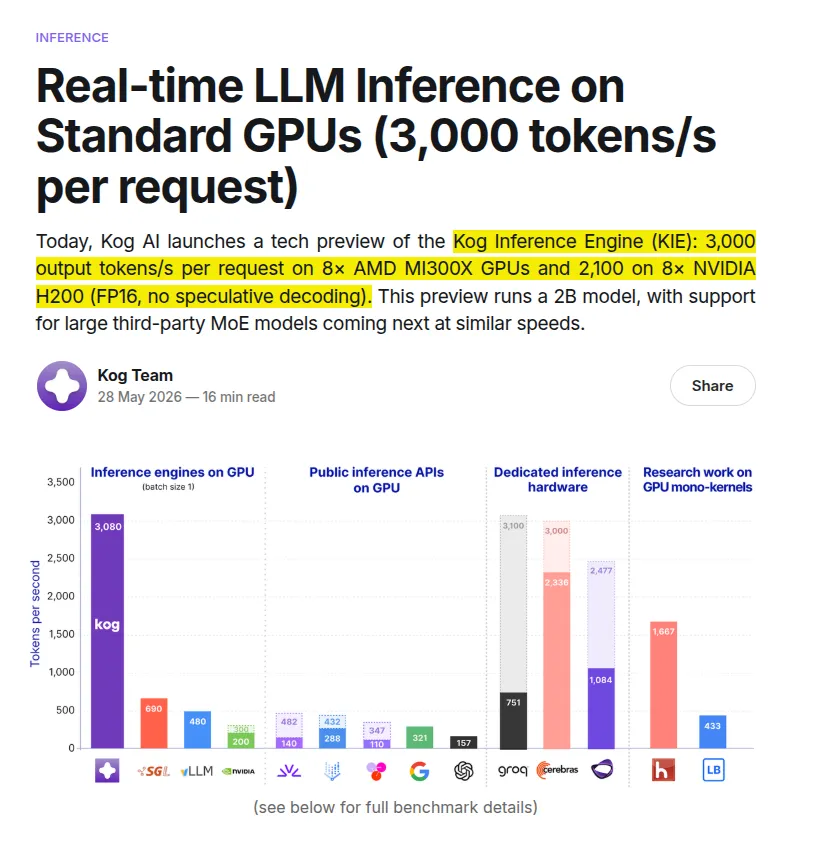
이 기술을 통해 Kog는 표준 GPU 8대를 구성한 환경에서 단일 요청당 초당 3,000 토큰(3k tokens/s)이라는 경이로운 속도를 달성했습니다. 이는 실시간 대화형 AI가 인간의 읽기 속도보다 훨씬 빠르게 답변을 쏟아낼 수 있음을 의미합니다.
모든 것이 장밋빛일까? 냉정한 분석과 현실적인 한계
물론, 모든 혁신에는 논란과 한계가 따르기 마련입니다. 전문가들 사이에서도 이번 발표를 두고 뜨거운 설전이 벌어지고 있습니다. 우리가 이 기술을 무조건적인 '치트키'로 받아들이기 전에 고려해야 할 세 가지 포인트가 있습니다.
첫째, 비교 대상의 공정성 문제입니다. 초기 테스트에서 사용된 모델이 2B(20억 파라미터) 규모의 아주 작은 모델이었기 때문에, GPT급의 거대 모델에서도 이 속도가 나올 수 있느냐는 의구심이 제기되었습니다.
이에 대해 Kog의 개발자 게일드(Gaeld)는 수학적인 근거를 들어 반박했습니다. 모델의 크기가 커지더라도 정밀도(Precision)를 조절하면 메모리 점유율을 일정 수준으로 유지할 수 있다는 논리입니다. 예를 들어, GPT-OSS-120B 같은 모델을 FP8 정밀도로 돌린다면, 테스트된 작은 모델과 메모리 사용량이 비슷해지므로 충분히 확장 가능하다는 설명입니다.
둘째, 하드웨어의 제약입니다. 이번 성과는 NVIDIA H200 같은 고성능 데이터센터용 GPU에서 거둔 결과입니다. 우리가 집에서 쓰는 RTX 시리즈 같은 소비자용 GPU에서는 메모리 대역폭의 한계 때문에 이 속도를 온전히 누리기 어려울 수 있습니다. 실제로 일부 테스트에서는 고급 소비자용 GPU에서 약 500 토큰/초 정도의 속도가 나왔다는 보고도 있습니다.
셋째, 정밀도와 성능의 트레이드오프입니다. 다른 업체인 테일라스(Taalas)가 초당 15,000 토큰이라는 압도적인 수치를 보여주기도 했는데, 이는 3비트 양자화(Quantization)라는 극단적인 압축 기술을 사용한 결과였습니다. 즉, 속도를 위해 모델의 '지능(정밀도)'을 어느 정도 희생해야 할 수도 있다는 점을 우리는 기억해야 합니다.
AI 서비스의 미래: 누구나 실시간 AI를 쓸 수 있는 시대
그럼에도 불구하고, Kog의 이번 성과가 갖는 의미는 결코 가볍지 않습니다. 가장 중요한 것은 이 기술이 '표준 GPU'에서 작동한다는 점입니다.
만약 우리가 매번 AI를 돌리기 위해 수십억 원짜리 특수 칩을 사 와야 한다면, AI 기술은 거대 기업들의 전유물로 남았을 것입니다. 하지만 Kog처럼 기존 인프라를 극대화하는 방식은 'AI 기술의 민주화'를 가속화합니다.
이제 중소기업이나 스타트업도 기존에 보유한 서버 자원을 활용해, 금융 상담 AI, 실시간 의료 보조 AI, 혹은 지연 없는 게임 NPC 같은 고차원적인 서비스를 구현할 수 있게 됩니다.
2026년의 AI 시장은 단순히 "누가 더 똑똑한가"를 넘어, "누가 더 빠르고 저렴하게, 실제 서비스에 녹여내는가"의 싸움으로 넘어가고 있습니다. Kog는 그 싸움에서 강력한 무기를 들고 나타난 셈입니다.
요약하며: 기다림이 사라진 세상
오늘 살펴본 내용을 정리해 보겠습니다.
- 문제: LLM의 토큰 생성 과정에서 발생하는 메모리 대역폭 병목 현상이 응답 지연을 초래함.
- 해결: Kog는 토큰 생성 루프를 단일 GPU 컨텍스트 내로 통합하는 최적화 기술로 초당 3,000 토큰의 속도를 달성함.
- 의미: 특수 하드웨어 없이 표준 GPU로도 실시간 AI 서비스가 가능해짐으로써 AI 도입의 문턱이 낮아짐.
기술의 발전은 언제나 "이게 정말 가능해?"라는 의문과 "이게 정말 실용적이야?"라는 반론 사이에서 진보해 왔습니다. Kog의 기술이 과연 모든 AI 서비스의 표준이 될 수 있을지, 아니면 특정 용도에 국한된 기술로 남을지는 조금 더 지켜봐야 할 것 같습니다.
여러분은 AI의 응답 속도가 얼마나 빨라져야 '진짜 대화'를 하고 있다고 느끼시나요? 댓글로 여러분의 생각을 공유해 주세요!
What do you think?
참고자료
- Real-time LLM Inference on Standard GPUs: 3k tokens/s per request · news.ycombinator.com
- Kog · x.com