"¿Se ha quedado mirando fijamente el cursor en la pantalla mientras espera a que la IA genere su respuesta?"
Al utilizar modelos de lenguaje de gran tamaño (LLM) como ChatGPT o Claude, nos encontramos con el llamado "efecto de escritura", donde las respuestas aparecen letra por letra de forma intermitente. Por mucho que la tecnología haya avanzado, lo que realmente deseamos es una respuesta fluida e instantánea, como en una conversación en tiempo real.
Especialmente para los desarrolladores y planificadores que buscan construir servicios empresariales, esta "latencia" es un problema crítico que determina la supervivencia del servicio. Esto se debe a que la experiencia del usuario varía drásticamente dependiendo de cuántos tokens se generen por segundo.
Hoy, 29 de mayo de 2026, profundizaremos en la tecnología revolucionaria de Kog (Kog AI), que ha surgido presentando la posibilidad de resolver este problema crónico de una sola vez.
¿Por qué los LLM nos hacen esperar?
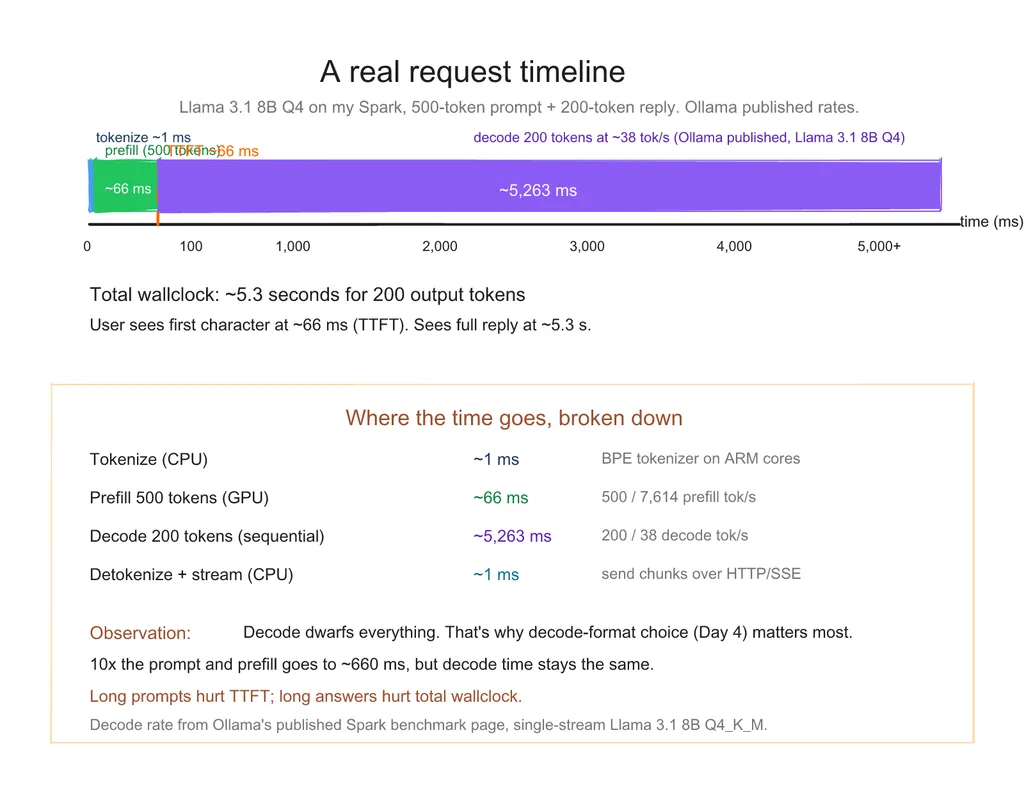
La frustración que sentimos al usar un LLM no es solo una sensación subjetiva. Existe un cuello de botella técnico claro.
Normalmente, un LLM no construye una oración de una sola vez, sino que genera fragmentos de palabras llamados tokens, uno tras otro. Este proceso se denomina "bucle de generación de tokens" (token-generation loop) y, en los métodos tradicionales, cada vez que este bucle se ejecuta, los datos deben intercambiarse constantemente entre la GPU y la memoria.
Es como si un chef muy rápido estuviera cocinando, pero su asistente fuera demasiado lento para traerle los ingredientes, obligando al chef a quedarse parado con el cuchillo en la mano. El chef (capacidad de cómputo de la GPU) es lo suficientemente rápido, pero la velocidad de entrega de los ingredientes (ancho de banda de la memoria) no puede seguirle el ritmo.
Además, a medida que el tamaño del modelo aumenta, esta carga de "entrega de ingredientes" crece exponencialmente. En este 2026, nos encontramos en la paradoja de querer modelos más inteligentes, pero tener que soportar esperas cada vez más largas.
La solución de Kog: Unificar el bucle
En este contexto, el anuncio de Kog realizado hoy está causando un gran impacto en la industria. En lugar de crear nuevos chips especializados (ASIC) o traer costoso hardware propietario, han resuelto este problema aprovechando las GPU de centros de datos estándar (como la NVIDIA H200) que ya poseemos.
La clave de su solución es "encerrar completamente el bucle de generación de tokens dentro de un único contexto de GPU".
¿Retomamos la analogía del chef? El método de Kog es como, en lugar de pedirle al asistente que traiga los ingredientes cada vez, colocar todos los ingredientes en una gran bandeja justo al lado del chef.
Específicamente, utilizaron las siguientes técnicas innovadoras de optimización de software:
- Monokernel Deep Dive: En lugar de fragmentar el proceso de cálculo, lo agrupan en una única unidad de ejecución masiva, minimizando la sobrecarga (overhead) del movimiento de datos dentro de la GPU.
- Delayed Tensor Parallelism: Ajustan inteligentemente el orden del procesamiento de datos para encontrar el momento óptimo para que los dispositivos de cálculo trabajen sin descanso.
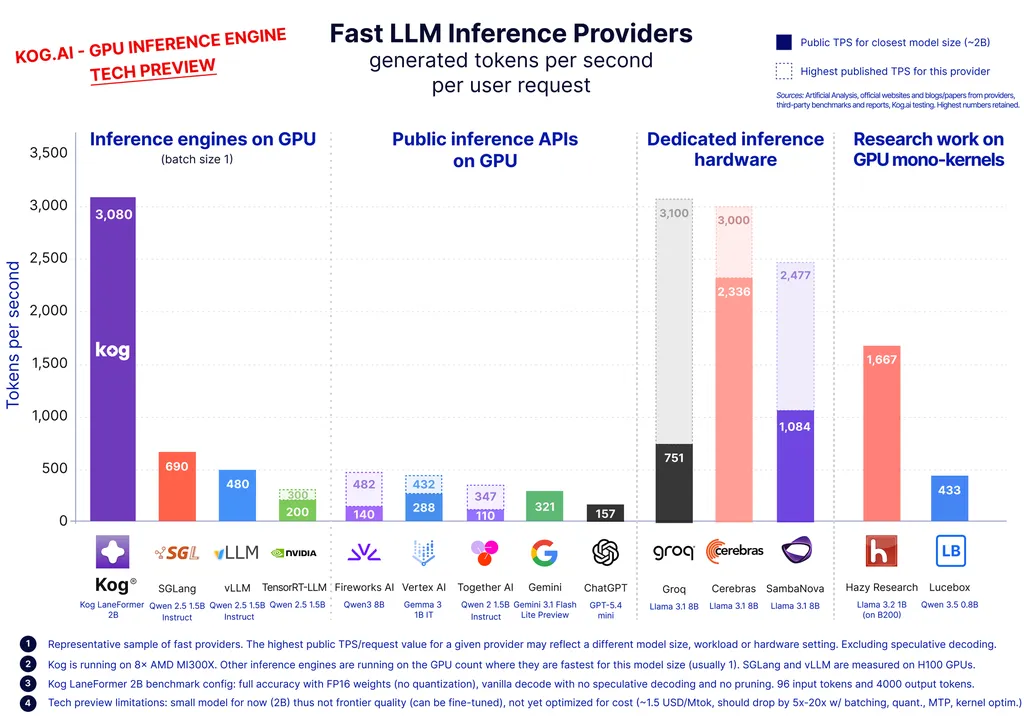
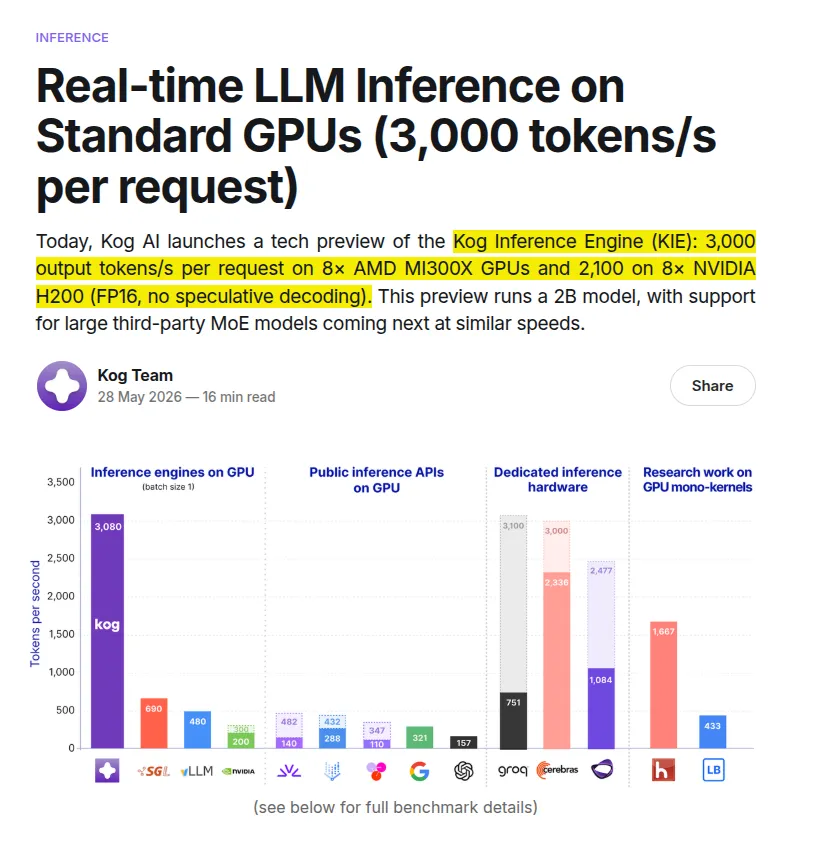
Gracias a esta tecnología, Kog ha logrado una velocidad asombrosa de 3,000 tokens por segundo (3k tokens/s) en un entorno configurado con 8 GPUs estándar. Esto significa que una IA conversacional en tiempo real puede volcar respuestas mucho más rápido de lo que un humano puede leer.
¿Es todo color de rosa? Análisis frío y limitaciones reales
Por supuesto, toda innovación conlleva controversias y límites. Incluso entre expertos, se está produciendo un intenso debate sobre este anuncio. Antes de aceptar esta tecnología como un "truco definitivo", hay tres puntos que debemos considerar.
Primero, el problema de la equidad en la comparación. Dado que el modelo utilizado en las pruebas iniciales era un modelo muy pequeño de 2B (2 mil millones de parámetros), surge la duda de si esta velocidad se podrá alcanzar también en modelos gigantes de la escala de GPT.
Ante esto, Gaeld, desarrollador de Kog, respondió con argumentos matemáticos. Su lógica es que, incluso si el tamaño del modelo aumenta, se puede mantener el uso de memoria en un nivel constante ajustando la precisión (Precision). Por ejemplo, si se ejecuta un modelo como GPT-OSS-120B con precisión FP8, el uso de memoria sería similar al del pequeño modelo probado, lo que hace que la tecnología sea perfectamente escalable.
Segundo, las limitaciones del hardware. Este logro se obtuvo utilizando GPUs de alto rendimiento para centros de datos, como la NVIDIA H200. En las GPUs de consumo, como la serie RTX que usamos en casa, podría ser difícil disfrutar de esta velocidad debido a las limitaciones del ancho de banda de la memoria. De hecho, algunos informes indican que en GPUs de consumo de gama alta se alcanzó una velocidad de unos 500 tokens/s.
Tercero, el intercambio (trade-off) entre precisión y rendimiento. Otra empresa, Taalas, mostró una cifra abrumadora de 15,000 tokens por segundo, pero esto fue resultado de una técnica de compresión extrema llamada cuantización (Quantization) de 3 bits. Es decir, debemos recordar que para obtener velocidad, es posible que se deba sacrificar un poco la "inteligencia" (precisión) del modelo.
El futuro de los servicios de IA: Una era donde cualquiera puede usar IA en tiempo real
A pesar de todo, el significado del logro de Kog no es ligero. Lo más importante es que esta tecnología funciona en "GPUs estándar".
Si tuviéramos que comprar chips especiales de miles de millones de wones cada vez que quisiéramos ejecutar una IA, la tecnología de IA seguiría siendo un privilegio de las grandes corporaciones. Sin embargo, el enfoque de Kog de maximizar la infraestructura existente acelera la "democratización de la tecnología de IA".
Ahora, las pequeñas y medianas empresas o las startups también podrán implementar servicios de alto nivel, como IAs de asesoría financiera, IAs de asistencia médica en tiempo real o NPCs de videojuegos sin latencia, utilizando los recursos de servidor que ya poseen.
El mercado de la IA en 2026 está pasando de la simple pregunta de "¿quién es más inteligente?" a la de "quién puede integrarlo en servicios reales de forma más rápida y económica". Kog ha aparecido con un arma poderosa para esa batalla.
Resumen: Un mundo donde la espera desaparece
Resumamos lo visto hoy:
- Problema: El cuello de botella del ancho de banda de la memoria durante el proceso de generación de tokens de los LLM provoca retrasos en la respuesta.
- Solución: Kog ha logrado una velocidad de 3,000 tokens por segundo mediante una técnica de optimización que integra el bucle de generación de tokens en un único contexto de GPU.
- Significado: Al permitir servicios de IA en tiempo real con GPUs estándar sin necesidad de hardware especial, se reduce la barrera de entrada para la adopción de la IA.
El avance tecnológico siempre ha progresado entre la duda de "¿es esto realmente posible?" y la objeción de "¿es esto realmente práctico?". Habrá que observar un poco más para ver si la tecnología de Kog se convierte en el estándar de todos los servicios de IA o si se queda como una tecnología limitada a usos específicos.
¿Qué tan rápida debe ser la respuesta de una IA para que sientas que estás teniendo una "conversación real"? ¡Comparte tus pensamientos en los comentarios!
What do you think?
Referencias
- Real-time LLM Inference on Standard GPUs: 3k tokens/s per request · news.ycombinator.com
- Kog · x.com



