"明明是同样的矩阵乘法,为什么有的数据快,有的数据却慢呢?"
对于训练深度学习模型或进行大规模数值计算的工程师来说,这可能是一个曾多次浮现在脑海中的疑问。直到目前为止,我们一直认为算法复杂度(Complexity)或内存带宽(Bandwidth)就是性能的全部。
但在 2026 年的今天,理解硬件的物理极限正成为软件优化的新巅峰。根据最近发现的有趣事实,我们所处理的**数据模式(Data Pattern)**竟然是决定 GPU 物理功耗和时钟频率的核心变量。
今天,我们将通过对比分析影响 GPU 矩阵乘法性能的各种因素,深入探讨为什么我们应该关注数据的“纹理”。
性能优化的范式转移:数学优化 vs 物理优化
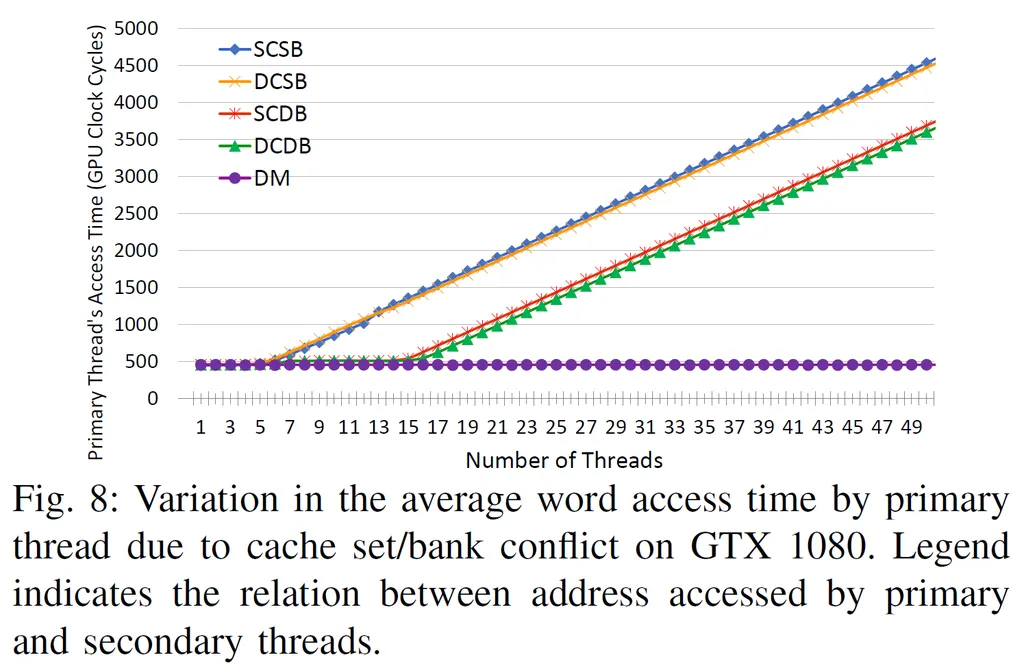
过去的性能优化主要停留在数学领域。对于矩阵运算,主要的思考点在于如何降低 的复杂度,或者如何排列内存访问以提高缓存命中率(Cache Hit Rate)。
然而,最近的研究指出了一个完全不同维度的难题:硬件的物理极限。
GPU 是一个由数千个核心同时运作的庞大并行引擎。当这个引擎全速运转时,最大的障碍不是数学计算公式,而是硬件必须承受的热量和电力。
根据 Horace He 最近发现的案例,在执行 8192x8192 大小的矩阵乘法时,观察到性能会因数据值的不同而产生 10% 以上的差异。尽管执行的数学运算次数完全相同,但当输入数据像“0”一样简单时,GPU 能维持更高的时钟频率并快速运行;而当输入随机(Random)数据时,性能却会出现剧烈下降。
这表明我们正在从只追求算法“数学优越性”的时代,转向必须考虑硬件“功耗管理机制”的时代。
决定性能的三大核心要素对比分析
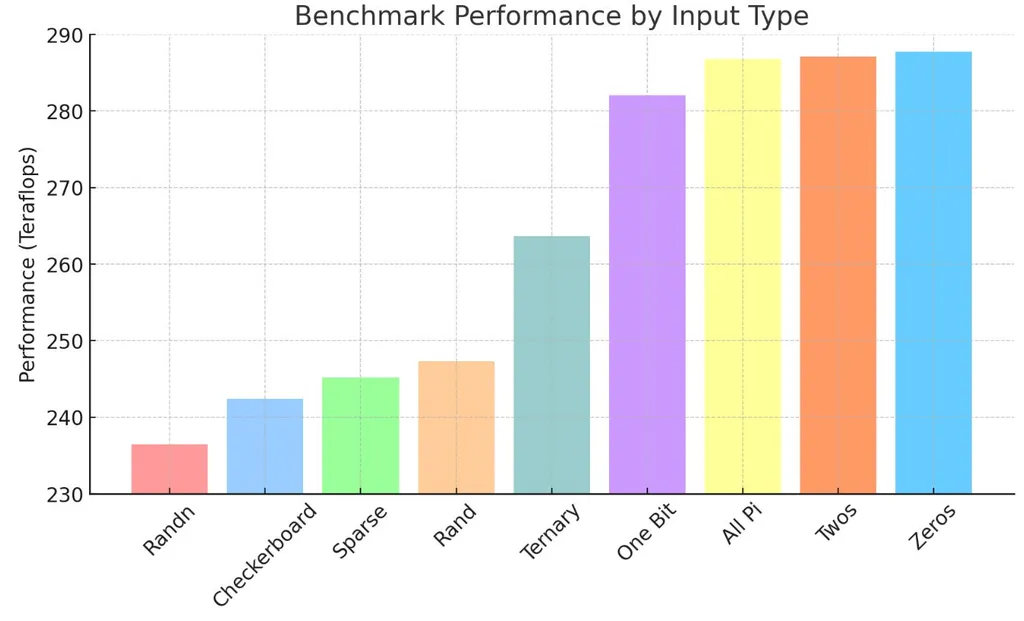
那么,决定 GPU 性能的实际因素究竟是什么?我们可以从三个维度来分析性能下降的原因。让我们对比一下各要素的特性。
1. 算法及内存访问模式 (The Software Layer)
这是最经典也最重要的要素。性能取决于数据从内存中读取的规则程度。
- 优点:如果算法设计得当,可以最大限度地提升内存带宽。数据访问越具有可预测性,GPU 的并行线程就越能专注于计算而无需等待。
- 缺点:然而,现代 GPU 的内存层级结构已经非常先进,仅靠软件层面的优化已难以获得进一步的剧烈性能提升,正面临“物理极限点”。
2. 数据不确定性与位翻转 (The Hardware Layer)
这是近期最受关注的变量。数据的数值变化频率是核心。
- 原理:如果数据值是随机的,晶体管的状态会在 0 和 1 之间频繁切换。这被称为位翻转(Bit Flip)。每当晶体管状态改变时,都会产生动态功耗(Dynamic Power)。
- 优点(可预测的数据):如果数据中包含大量的 0 或具有一定的模式,晶体管的状态切换就会最小化。结果是动态功耗降低,GPU 不会被触发功耗限制(Power Limit),从而能长时间维持更高的时钟频率。
- 缺点(随机数据):随机数据会让晶体管不停地跳动。当功耗激增时,GPU 的电压调节模块(VRM)为了防止过热和电力过载,会强制降低时钟频率,即执行“降频(Throttling)”。这就是性能骤降的真相。
3. 系统功耗管理与热控制 (The Environment Layer)
这是硬件架构与运行环境之间的相互作用。
- 特征:服务器级 GPU 与消费级(游戏)GPU 的设计理念截然不同。服务器级 GPU 为了维持最大性能,比起优化空闲(Idle)状态的功耗,更专注于维持可预测的性能和延迟。
- 权衡(Trade-off):如果使用 100% 的电力以最大时钟频率运行,瞬间速度可能很快,但由于温度急剧升高,最终会导致性能下降。相反,适度限制电力以实现高效运行,可能更有利于缩短整体任务时间。
| 比较项目 | 算法优化 | 数据模式 (位翻转) | 电力/热管理 |
|---|---|---|---|
| 主要目标 | 内存带宽/缓存 | 晶体管状态切换 | 时钟频率/温度 |
| 优化方式 | 数据对齐及并行化 | 数据分布操纵 | 电力限制 (Power Limiting) |
| 可控性 | 高 (修改代码) | 中 (需要数据预处理) | 低 (硬件限制) |
专家建议:我们应该做哪些准备?
那么,我们未来应该采取什么样的策略呢?简单地说“把代码写得更高效”现在已经只是一个不完整的答案。
我深信,未来高性能计算(HPC)和 AI 优化的核心在于“软硬件协同设计(Hardware-Software Co-design)”。为此,我推荐以下三种方法:
第一,制定考虑数据分布的预处理策略。 如果任务的性能至关重要,就必须了解数据的性质。可以考虑像最近讨论的 TurboQuant 技术那样,在保持数据安全性的同时,通过对数据进行有意的转换来提高计算效率。如果数据过于“随机”,应思考是否存在将其映射为更具“可预测性”形式的方法。
第二,与其盲目追求“最大性能”,不如寻找“最优效率”。 将所有的 GPU 任务都运行在最大功耗模式下是低效的。通过实验,寻找将电力限制在 70~80% 水平时,在不触发降频的情况下能产生更稳定且更快结果(Throughput)的临界点,这才是带来实质性性能提升的关键。
第三,拓宽对架构的理解。 现在的工程师不仅要理解算法,还要理解晶体管的开关功耗、GPU 的功耗限制机制以及服务器级硬件的设计特性。仅仅意识到“数据值决定了物理硬件的‘运动’”这一事实,就足以彻底改变优化的视野。
结语:数据不仅仅是数字,更是物理流
归根结底,这次发现带给我们的启示非常明确:数据不仅仅是数学计算的对象,更是驱动硬件这一物理实体运动的能量流。
矩阵乘法速度随数据值而变化的原因在于,数据决定了晶体管的运动,而这种运动又反过来决定了 GPU 的功耗和时钟频率。理解这一隐形连接的人,将在未来的 AI 优化竞争中胜出。
在以往进行性能优化时,您是否像考虑代码逻辑一样,也考虑过硬件的物理特性呢?
欢迎在评论区分享您的优化经验!
参考资料
- Matrix Multiplications on GPUs Run Faster When Given "Predictable ... · news.ycombinator.com
- Understanding the Efficiency of GPU Algorithms for Matrix-Matrix ... · graphics.stanford.edu