"똑같은 행렬 곱셈인데, 왜 어떤 데이터는 빠르고 어떤 데이터는 느릴까?"
딥러닝 모델을 학습시키거나 대규모 수치 해석을 수행하는 엔지니어라면 한 번쯤 마주했을 법한 의문입니다. 우리는 지금까지 알고리즘의 복잡도(Complexity)나 메모리 대역폭(Bandwidth)이 성능의 전부라고 믿어왔습니다.
하지만 2026년 현재, 하드웨어의 물리적 한계를 이해하는 것이 소프트웨어 최적화의 새로운 정점이 되고 있습니다. 최근 밝혀진 흥미로운 사실에 따르면, 우리가 다루는 데이터의 패턴이 GPU의 물리적인 전력 소모와 클럭 속도를 결정짓는 핵심 변수라는 점이 드러났기 때문입니다.
오늘은 GPU 기반 행렬 곱셈 성능을 좌우하는 요인들을 비교 분석하며, 우리가 왜 데이터의 '질감'에 주목해야 하는지 깊이 있게 살펴보겠습니다.
성능 최적화의 패러다임 변화: 수학적 최적화 vs 물리적 최적화
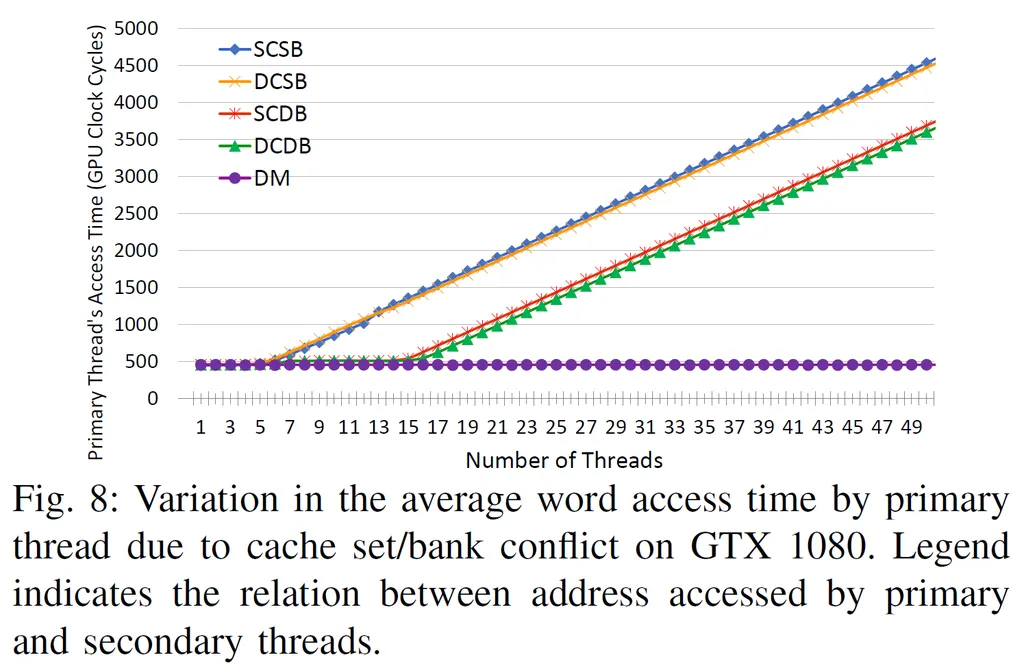
과거의 성능 최적화는 주로 수학적인 영역에 머물러 있었습니다. 행렬 연산의 경우 의 복잡도를 어떻게 줄일 것인가, 혹은 메모리 접근을 어떻게 정렬하여 캐시 적중률(Cache Hit Rate)을 높일 것인가가 주된 고민이었죠.
하지만 최근 연구들은 전혀 다른 차원의 문제를 지적합니다. 바로 하드웨어의 물리적 한계입니다.
GPU는 수천 개의 코어가 동시에 움직이는 거대한 병렬 엔진입니다. 이 엔진이 풀 가동될 때 가장 큰 걸림돌은 수학적 계산식이 아니라, 하드웨어가 견뎌야 하는 열과 전력입니다.
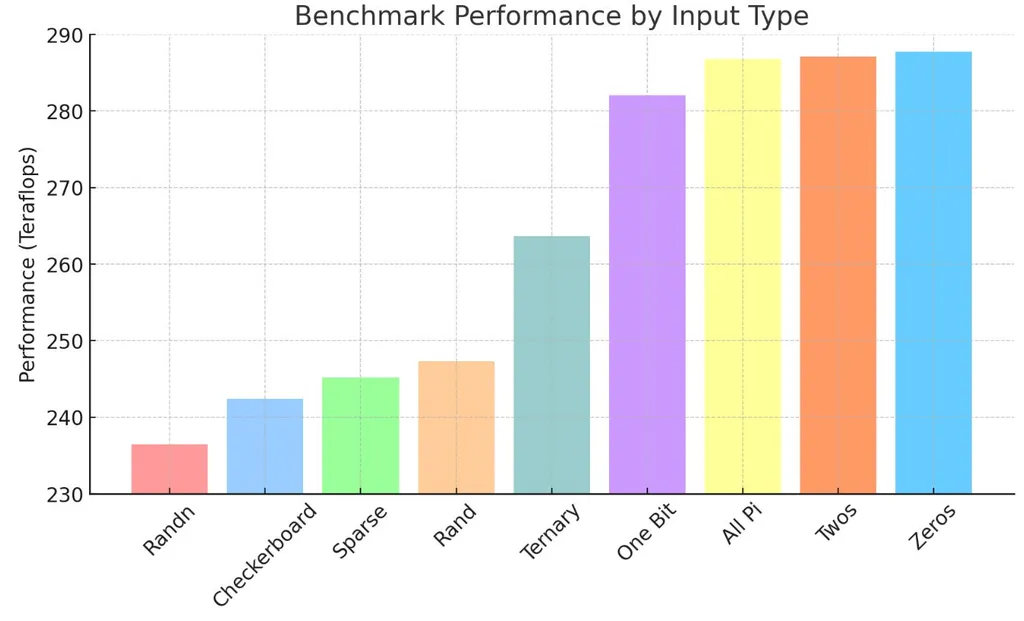
최근 Horace He가 발견한 사례를 보면, 8192x8192 크기의 행렬 곱셈을 수행할 때 데이터의 값에 따라 성능이 10% 이상 차이 나는 현상이 관찰되었습니다. 수학적으로 동일한 연산 횟수를 수행함에도 불구하고, 입력 데이터가 '0'처럼 단순할 때는 GPU가 더 높은 클럭을 유지하며 빠르게 달리는 반면, 무작위(Random) 데이터가 들어오면 성능이 급감하는 현상이 나타난 것이죠.
이는 우리가 알고리즘의 '수학적 우월성'만 따지던 시대에서, 하드웨어의 '전력 관리 메커니즘'을 고려해야 하는 시대로 넘어가고 있음을 시사합니다.
성능을 결정짓는 세 가지 핵심 요소 비교 분석
그렇다면 GPU의 성능을 결정짓는 실제 요인들은 무엇일까요? 우리는 크게 세 가지 관점에서 성능 저하의 원인을 분석할 수 있습니다. 각 요소의 특성을 비교해 보겠습니다.
1. 알고리즘 및 메모리 접근 패턴 (The Software Layer)
가장 고전적이면서도 중요한 요소입니다. 데이터가 메모리에서 얼마나 규칙적으로 읽히느냐에 따라 성능이 갈립니다.
- 장점: 알고리즘을 잘 설계하면 메모리 대역폭을 극한으로 끌어올릴 수 있습니다. 데이터 접근이 예측 가능할수록 GPU의 병렬 스레드들이 대기 시간 없이 연산에 집중할 수 있습니다.
- 단점: 하지만 현대 GPU는 이미 메모리 계층 구조가 매우 고도화되어 있어, 소프트웨어적인 최적화만으로는 더 이상의 극적인 성능 향상을 얻기 힘든 '물리적 한계점'에 도달해 있습니다.
2. 데이터의 불확실성과 비트 플립 (The Hardware Layer)
최근 가장 주목받는 변수입니다. 데이터의 값이 얼마나 자주 변하느냐가 핵심입니다.
- 원리: 데이터 값이 무작위적이면 트랜지스터의 상태가 0과 1 사이를 빈번하게 오갑니다. 이를 비트 플립(Bit Flip)이라고 합니다. 트랜지스터의 상태가 바뀔 때마다 전력이 소모되는 동적 전력(Dynamic Power)이 발생합니다.
- 장점 (예측 가능한 데이터): 데이터가 0이 많거나 패턴이 일정하면 트랜지스터의 상태 전환이 최소화됩니다. 결과적으로 동적 전력 소모가 줄어들고, GPU는 전력 제한(Power Limit)에 걸리지 않고 더 높은 클럭 주파수를 오래 유지할 수 있습니다.
- 단점 (무작위 데이터): 무작위 데이터는 트랜지스터를 끊임없이 움직이게 만듭니다. 전력 소모가 급증하면 GPU의 전압 조절 모듈(VRM)은 과열과 전력 과부하를 막기 위해 클럭을 강제로 낮추는 '스로틀링'을 실행합니다. 이것이 바로 성능 급감의 실체입니다.
3. 시스템 전력 관리 및 열 제어 (The Environment Layer)
하드웨어 아키텍처와 운영 환경의 상호작용입니다.
- 특징: 서버급 GPU와 소비자용(게이밍) GPU는 설계 철학부터 다릅니다. 서버용은 최대 성능을 유지하기 위해 아이들(Idle) 상태의 전력 소모를 최적화하기보다, 예측 가능한 성능과 지연 시간을 유지하는 데 집중합니다.
- 트레이드오프: 전력을 100% 사용해 최대 클럭으로 돌리면 순간 속도는 빠를 수 있지만, 급격한 온도 상승으로 인해 결국 성능이 꺾이는 현상이 발생합니다. 반면, 전력을 약간 제한하여 효율적으로 운용하는 것이 전체 작업 시간을 단축하는 데 유리할 수 있습니다.
| 비교 항목 | 알고리즘 최적화 | 데이터 패턴(비트 플립) | 전력/열 관리 |
|---|---|---|---|
| 주요 타겟 | 메모리 대역폭/캐시 | 트랜지스터 상태 전환 | 클럭 주파수/온도 |
| 최적화 방식 | 데이터 정렬 및 병렬화 | 데이터 분포 조작 | 전력 제한(Power Limiting) |
| 제어 가능성 | 높음 (코드 수정) | 중간 (데이터 전처리 필요) | 낮음 (하드웨어 제약) |
전문가의 제언: 우리는 무엇을 준비해야 하는가?
그렇다면 우리는 앞으로 어떤 전략을 취해야 할까요? 단순히 "코드를 더 효율적으로 짜자"라는 말은 이제 반쪽짜리 정답입니다.
저는 향후 고성능 컴퓨팅(HPC)과 AI 최적화의 핵심이 '하드웨어와의 정합성(Hardware-Software Co-design)'에 있다고 확신합니다. 이를 위해 다음과 같은 세 가지 접근법을 추천합니다.
첫째, 데이터의 분포를 고려한 전처리 전략을 세우십시오. 만약 성능이 극도로 중요한 작업이라면, 데이터의 성질을 파악해야 합니다. 최근 논의되는 TurboQuant 기법처럼 데이터의 보안을 유지하면서도 연산 효율을 높이기 위해 데이터에 의도적인 변환을 가하는 방식이 고려될 수 있습니다. 데이터가 너무 '무작위적'이라면, 이를 조금 더 '예측 가능한' 형태로 매핑할 수 있는 방법이 있는지 고민해봐야 합니다.
둘째, 무조건적인 '최대 성능' 설정보다는 '최적 효율'을 찾으십시오. 모든 GPU 작업을 최대 전력 모드로 돌리는 것은 비효율적입니다. 실험을 통해 전력을 70~80% 수준으로 제한했을 때, 스로틀링 없이 더 안정적이고 빠른 결과(Throughput)를 내는 지점을 찾아내는 것이 실질적인 성능 향상을 가져옵니다.
셋째, 아키텍처에 대한 이해를 넓히십시오. 이제 엔지니어는 알고리즘뿐만 아니라 트랜지스터의 스위칭 전력, GPU의 전력 제한 메커니즘, 그리고 서버급 하드웨어의 설계 특성을 이해해야 합니다. 데이터의 값이 물리적 하드웨어의 '움직임'을 결정한다는 사실을 인지하는 것만으로도 최적화의 시야가 완전히 달라질 것입니다.
마치며: 데이터는 단순한 숫자가 아닌, 물리적 흐름입니다
결국 이번 발견이 우리에게 주는 교훈은 명확합니다. 데이터는 단순히 수학적 계산의 대상이 아니라, 하드웨어라는 물리적 실체를 움직이는 에너지의 흐름이라는 점입니다.
행렬 곱셈의 속도가 데이터의 값에 따라 달라지는 이유는, 데이터가 트랜지스터의 움직임을 결정하고, 그 움직임이 다시 GPU의 전력과 클럭을 결정하기 때문입니다. 이 보이지 않는 연결 고리를 이해하는 자가 미래의 AI 최적화 경쟁에서 승리할 것입니다.
여러분은 지금까지 성능 최적화를 할 때, 코드의 논리만큼이나 하드웨어의 물리적 특성을 고려해 보신 적이 있나요?
여러분의 최적화 경험은 어떠했는지 댓글로 공유해 주세요!
참고자료
- Matrix Multiplications on GPUs Run Faster When Given "Predictable ... · news.ycombinator.com
- Understanding the Efficiency of GPU Algorithms for Matrix-Matrix ... · graphics.stanford.edu