"Es la misma multiplicación de matrices, ¿por qué algunos datos son rápidos y otros lentos?"
Esta es una duda que cualquier ingeniero que entrene modelos de deep learning o realice análisis numéricos a gran escala se habrá planteado alguna vez. Hasta ahora, hemos creído que la complejidad del algoritmo (Complexity) o el ancho de banda de la memoria (Bandwidth) eran los únicos factores que determinaban el rendimiento.
Sin embargo, en este 2026, comprender los límites físicos del hardware se está convirtiendo en la nueva cúspide de la optimización de software. Según hallazgos recientes e interesantes, se ha revelado que el patrón de los datos que manejamos es la variable clave que determina el consumo de energía física y la velocidad de reloj (clock speed) de la GPU.
Hoy analizaremos comparativamente los factores que dictan el rendimiento de la multiplicación de matrices basada en GPU y profundizaremos en por qué debemos prestar atención a la "textura" de los datos.
El cambio de paradigma en la optimización del rendimiento: Optimización matemática vs. Optimización física
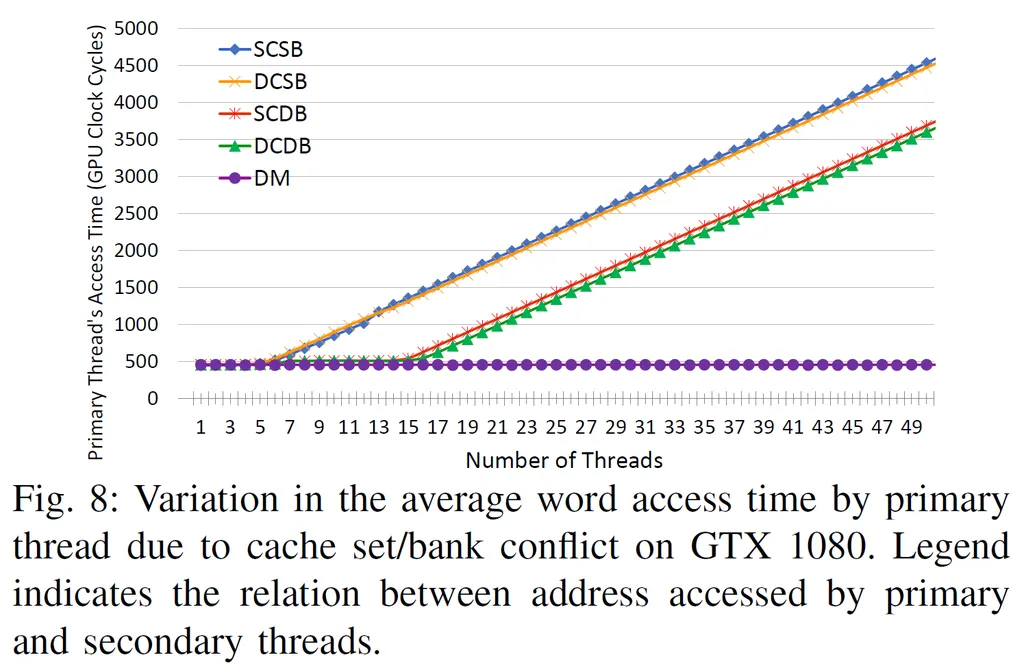
En el pasado, la optimización del rendimiento se centraba principalmente en el ámbito matemático. En el caso de las operaciones de matrices, la preocupación principal era cómo reducir la complejidad de o cómo organizar el acceso a la memoria para aumentar la tasa de aciertos en la caché (Cache Hit Rate).
Pero las investigaciones recientes señalan un problema de una dimensión completamente distinta: los límites físicos del hardware.
Una GPU es un enorme motor paralelo con miles de núcleos moviéndose simultáneamente. Cuando este motor funciona a plena capacidad, el mayor obstáculo no son las fórmulas matemáticas, sino el calor y la energía que el hardware debe soportar.
Observando casos descubiertos recientemente por Horace He, se ha observado que al realizar una multiplicación de matrices de tamaño 8192x8192, el rendimiento varía en más de un 10% dependiendo de los valores de los datos. A pesar de realizar el mismo número de operaciones matemáticas, cuando los datos de entrada son simples, como el '0', la GPU puede mantener un reloj más alto y correr más rápido; por el contrario, cuando entran datos aleatorios (Random), el rendimiento cae drásticamente.
Esto sugiere que estamos pasando de una era en la que solo nos preocupábamos por la "superioridad matemática" de los algoritmos, a una era en la que debemos considerar el "mecanismo de gestión de energía" del hardware.
Análisis comparativo de los tres factores clave que determinan el rendimiento
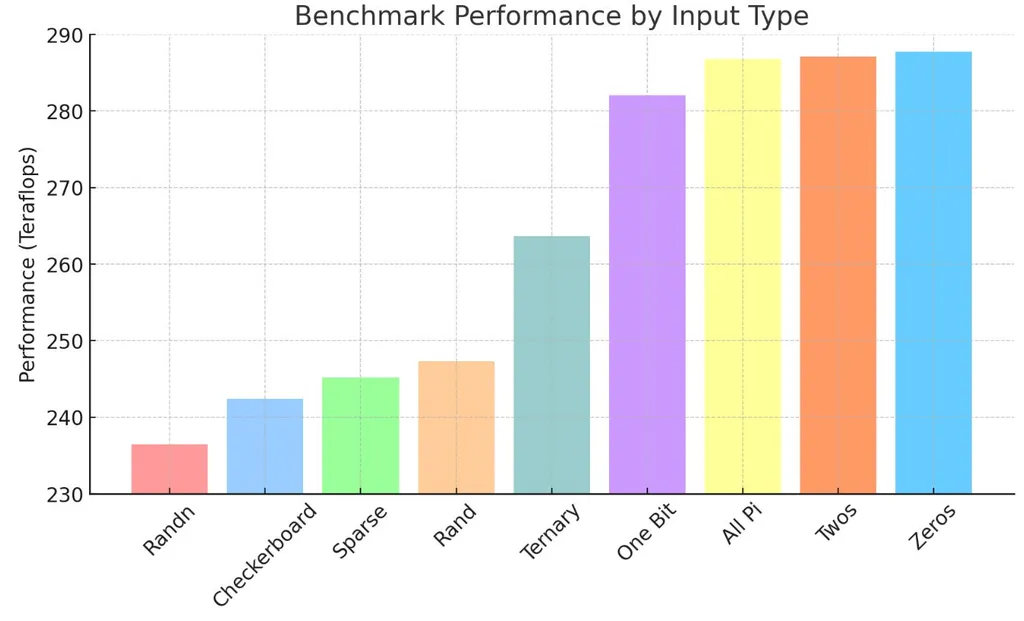
Entonces, ¿cuáles son los factores reales que determinan el rendimiento de una GPU? Podemos analizar las causas de la degradación del rendimiento desde tres perspectivas principales. Comparemos las características de cada factor.
1. Algoritmo y patrones de acceso a la memoria (The Software Layer)
Es el factor más clásico y crucial. El rendimiento depende de qué tan regularmente se lean los datos de la memoria.
- Ventaja: Si se diseña bien el algoritmo, se puede llevar el ancho de banda de la memoria al límite. Cuanto más predecible sea el acceso a los datos, más podrán concentrarse los hilos paralelos de la GPU en el cómputo sin tiempos de espera.
- Desventaja: Sin embargo, las GPU modernas ya cuentan con estructuras de memoria muy avanzadas, por lo que se ha alcanzado un "límite físico" donde es difícil obtener mejoras de rendimiento drásticas solo mediante la optimización de software.
2. Incerteza de los datos y conmutación de bits (The Hardware Layer)
Es la variable que más atención está recibiendo recientemente. La clave es con qué frecuencia cambian los valores de los datos.
- Principio: Si los valores de los datos son aleatorios, el estado de los transistores oscila frecuentemente entre 0 y 1. Esto se conoce como bit flip (conmutación de bits). Cada vez que cambia el estado de un transistor, se genera potencia dinámica (Dynamic Power), que es el consumo de energía.
- Ventaja (Datos predecibles): Si los datos tienen muchos ceros o un patrón constante, las transiciones de estado de los transistores se minimizan. Como resultado, el consumo de potencia dinámica disminuye y la GPU puede mantener una frecuencia de reloj más alta por más tiempo sin alcanzar el límite de potencia (Power Limit).
- Desventaja (Datos aleatorios): Los datos aleatorios obligan a los transistores a moverse constantemente. Cuando el consumo de energía se dispara, el módulo de regulación de voltaje (VRM) de la GPU ejecuta un "throttling" (estrangulamiento), reduciendo forzosamente la frecuencia de reloj para evitar el sobrecalentamiento y la sobrecarga de potencia. Esta es la realidad detrás de la caída repentina del rendimiento.
3. Gestión de la energía del sistema y control térmico (The Environment Layer)
Es la interacción entre la arquitectura del hardware y el entorno de operación.
- Características: La filosofía de diseño de las GPU de grado servidor y las GPU de consumo (gaming) es distinta. Las de servidor se enfocan en mantener un rendimiento y una latencia predecibles, más que en optimizar el consumo de energía en estado de reposo (Idle) para alcanzar el máximo rendimiento.
- Compromiso (Trade-off): Ejecutar con el 100% de la potencia a la máxima frecuencia puede dar una velocidad instantánea mayor, pero debido al rápido aumento de la temperatura, eventualmente el rendimiento caerá. Por el contrario, limitar ligeramente la potencia para operar de manera eficiente puede ser más ventajoso para reducir el tiempo total de trabajo.
| Ítem de comparación | Optimización de algoritmo | Patrón de datos (Bit Flip) | Gestión de potencia/calor |
|---|---|---|---|
| Objetivo principal | Ancho de banda/Caché | Transición de estado de transistores | Frecuencia de reloj/Temperatura |
| Método de optimización | Ordenamiento y paralelización | Manipulación de la distribución de datos | Limitación de potencia (Power Limiting) |
| Controlabilidad | Alta (Modificación de código) | Media (Requiere preprocesamiento) | Baja (Restricción de hardware) |
Sugerencia del experto: ¿Qué debemos preparar?
Entonces, ¿qué estrategia debemos adoptar de ahora en adelante? Decir simplemente "escribamos código más eficiente" es ahora una respuesta incompleta.
Estoy convencido de que el núcleo de la computación de alto rendimiento (HPC) y la optimización de la IA en el futuro reside en el "diseño conjunto hardware-software (Hardware-Software Co-design)". Para ello, recomiendo los siguientes tres enfoques:
Primero, establezca estrategias de preprocesamiento que consideren la distribución de los datos. Si se trata de una tarea donde el rendimiento es extremadamente crítico, debe comprender la naturaleza de los datos. Se podrían considerar métodos como la técnica TurboQuant, que aplica transformaciones intencionadas a los datos para aumentar la eficiencia computacional manteniendo la seguridad de los mismos. Si los datos son demasiado "aleatorios", debe reflexionar sobre si existe una forma de mapearlos a un formato más "predecible".
Segundo, busque la "eficiencia óptima" en lugar de la "máxima potencia" incondicional. Ejecutar todas las tareas de GPU en modo de máxima potencia es ineficiente. Mediante la experimentación, encontrar el punto donde, al limitar la potencia a un nivel del 70~80%, se obtienen resultados (throughput) más estables y rápidos sin sufrir throttling, traerá una mejora real en el rendimiento.
Tercero, amplíe su comprensión de la arquitectura. Ahora, un ingeniero debe entender no solo los algoritmos, sino también la potencia de conmutación de los transistores, los mecanismos de limitación de potencia de la GPU y las características de diseño del hardware de clase servidor. El solo hecho de reconocer que los valores de los datos determinan el "movimiento" del hardware físico cambiará completamente su visión de la optimización.
Conclusión: Los datos no son simples números, son un flujo físico
En última instancia, la lección que este descubrimiento nos deja es clara: los datos no son solo objetos de cálculo matemático, sino un flujo de energía que mueve la entidad física llamada hardware.
La razón por la que la velocidad de la multiplicación de matrices varía según los valores de los datos es que los datos determinan el movimiento de los transistores, y ese movimiento, a su vez, determina la potencia y el reloj de la GPU. Aquellos que comprendan este vínculo invisible serán quienes triunfen en la futura competencia de optimización de la IA.
Cuando optimizaba el rendimiento hasta ahora, ¿había considerado las características físicas del hardware tanto como la lógica del código?
¡Comparta su experiencia de optimización en los comentarios!
Referencias
- Matrix Multiplications on GPUs Run Faster When Given "Predictable ... · news.ycombinator.com
- Understanding the Efficiency of GPU Algorithms for Matrix-Matrix ... · graphics.stanford.edu