「同じ行列演算なのに、なぜあるデータは速く、あるデータは遅いのか?」
ディープラーニングモデルを学習させたり、大規模な数値解析を行ったりするエンジニアであれば、一度は直面したことのある疑問でしょう。私たちはこれまで、アルゴリズムの計算量(Complexity)やメモリ帯域幅(Bandwidth)こそが性能のすべてであると信じてきました。
しかし、2026年現在、ハードウェアの物理的な限界を理解することが、ソフトウェア最適化の新たな到達点となっています。最近明らかになった興味深い事実によれば、私たちが扱うデータのパターンが、GPUの物理的な消費電力とクロック速度を決定づける鍵となる変数であることが判明したからです。
本日は、GPUベースの行列演算性能を左右する要因を比較分析し、なぜ私たちがデータの「質感」に注目すべきなのかを深く掘り下げていきます。
パフォーマンス最適化のパラダイムシフト:数学的最適化 vs 物理的最適化
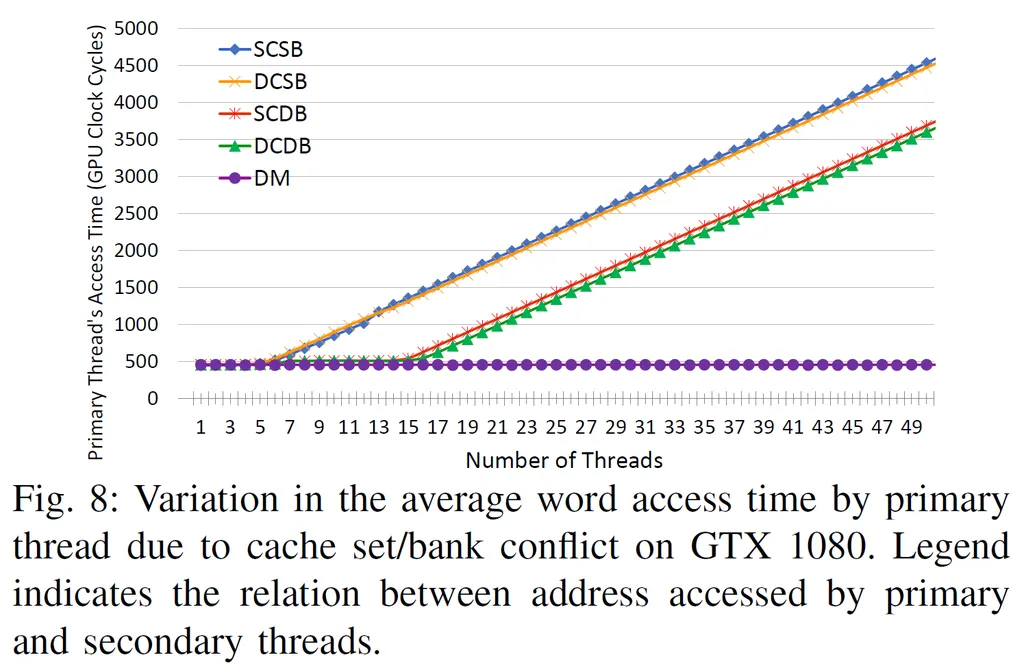
過去のパフォーマンス最適化は、主に数学的な領域に留まっていました。行列演算の場合、の計算量をいかに減らすか、あるいはメモリへのアクセスをどのように整列させてキャッシュヒット率(Cache Hit Rate)を高めるかが主な課題でした。
しかし、近年の研究は全く異なる次元の問題を指摘しています。それは、ハードウェアの物理的な限界です。
GPUは数千のコアが同時に動く巨大な並列エンジンです。このエンジンがフル稼働する際、最大の障害となるのは数学的な計算式ではなく、ハードウェアが耐えなければならない熱と電力です。
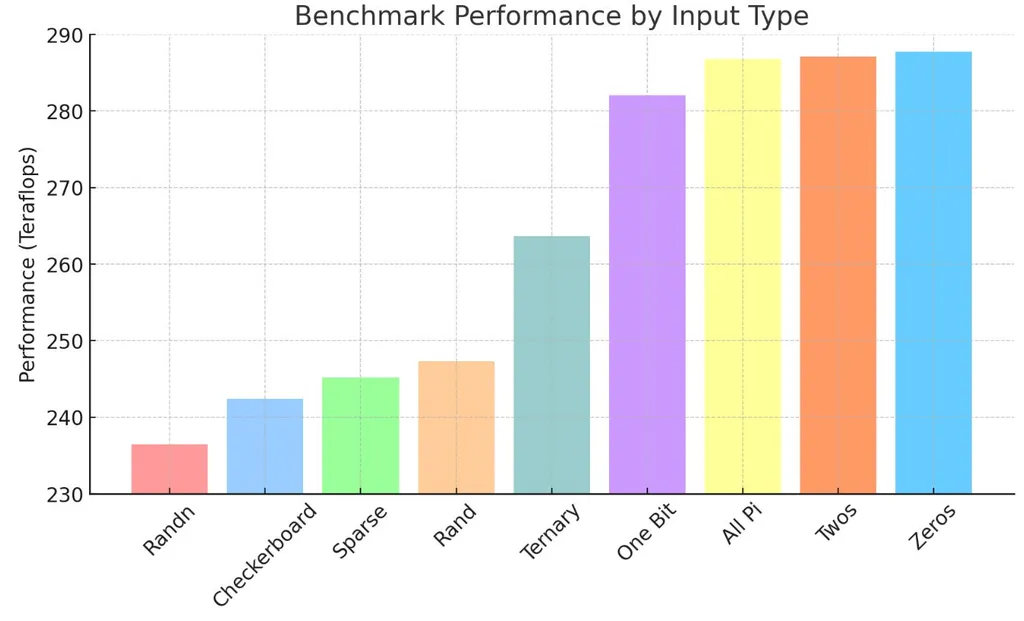
最近、Horace Heが発見した事例によれば、8192x8192サイズの行列演算を行う際、データの値によって性能に10%以上の差が生じる現象が観察されました。数学的には同一の演算回数を実行しているにもかかわらず、入力データが「0」のように単純なときはGPUが高いクロックを維持して高速に動作する一方で、ランダム(Random)なデータが入ってくると性能が急落するという現象が起きたのです。
これは、私たちがアルゴリズムの「数学的な優位性」だけを追求していた時代から、ハードウェアの「電力管理メカニズム」まで考慮しなければならない時代へと移行していることを示唆しています。
パフォーマンスを決定づける3つの核心要素の比較分析
では、GPUの性能を決定づける実際の要因とは何でしょうか?私たちは大きく分けて3つの観点から性能低下の原因を分析できます。それぞれの要素の特性を比較してみましょう。
1. アルゴリズムおよびメモリ・アクセス・パターン (The Software Layer)
最も古典的でありながら、重要な要素です。データがメモリからどれほど規則的に読み取られるかによって、性能が分かれます。
- メリット: アルゴリズムを適切に設計すれば、メモリ帯域幅を極限まで引き出すことができます。データアクセスが予測可能であるほど、GPUの並列スレッドは待ち時間なしで演算に集中できます。
- デメリット: しかし、現代のGPUはすでにメモリ階層構造が非常に高度化されており、ソフトウェア的な最適化だけでは、これ以上の劇的な性能向上を得ることが難しい「物理的な限界点」に達しています。
2. データの不確実性とビットフリップ (The Hardware Layer)
近年、最も注目されている変数です。データの値がどれほど頻繁に変化するかが鍵となります。
- 原理: データ値がランダムであると、トランジスタの状態が0と1の間を頻繁に行き来します。これを**ビットフリップ(Bit Flip)と呼びます。トランジスタの状態が変わるたびに、電力が消費される動的電力(Dynamic Power)**が発生します。
- メリット(予測可能なデータ): データに「0」が多く、パターンが一定であれば、トランジスタの状態遷移が最小限に抑えられます。結果として動的電力の消費が減り、GPUは電力制限(Power Limit)に抵触することなく、高いクロック周波数を長時間維持できます。
- デメリット(ランダムなデータ): ランダムなデータはトランジスタを絶え間なく動かします。電力消費が急増すると、GPUの電圧レギュレータモジュール(VRM)は、過熱と電力過負荷を防ぐためにクロックを強制的に下げる「スロットリング(Throttling)」を実行します。これこそが、性能急落の正体です。
3. システム電力管理および熱制御 (The Environment Layer)
ハードウェア・アーキテクチャと運用環境の相互作用です。
- 特徴: サーバー級GPUとコンシューマー向け(ゲーミング)GPUでは、設計思想から異なります。サーバー用は最大性能を維持するために、アイドル(Idle)状態の消費電力を最適化することよりも、予測可能な性能とレイテンシを維持することに集中します。
- トレードオフ: 電力を100%使用して最大クロックで回せば、瞬間の速度は速いかもしれませんが、急激な温度上昇によって結局パフォーマンスが低下する現象が発生します。一方で、電力をわずかに制限して効率的に運用する方が、全体の作業時間を短縮する上で有利になる場合があります。
| 比較項目 | アルゴリズム最適化 | データパターン (ビットフリップ) | 電力/熱管理 |
|---|---|---|---|
| 主なターゲット | メモリ帯域幅/キャッシュ | トランジスタの状態遷移 | クロック周波数/温度 |
| 最適化手法 | データの整列および並列化 | データ分布の操作 | 電力制限 (Power Limiting) |
| 制御可能性 | 高い (コード修正) | 中程度 (データ前処理が必要) | 低い (ハードウェア制約) |
エキスパートの提言:私たちは何を準備すべきか?
では、私たちは今後どのような戦略を取るべきでしょうか?単に「コードをもっと効率的に書こう」という言葉は、もはや半分しか正解ではありません。
私は、今後のハイパフォーマンス・コンピューティング(HPC)とAI最適化の核心は、「ハードウェアとの整合性(Hardware-Software Co-design)」にあると確信しています。そのために、以下の3つのアプローチを推奨します。
第一に、データの分布を考慮した前処理戦略を立てることです。 もし性能が極めて重要なタスクであれば、データの性質を把握しなければなりません。最近議論されているTurboQuant手法のように、データのセキュリティを維持しつつ演算効率を高めるために、データに意図的な変換を加える手法が検討され得るでしょう。データが「ランダムすぎる」場合、それをもう少し「予測可能な」形にマッピングできる方法がないか検討すべきです。
第二に、無条件な「最大性能」設定よりも「最適効率」を見つけることです。 すべてのGPUタスクを最大電力モードで実行するのは非効率です。実験を通じて、電力を70〜80%程度に制限したときに、スロットリングを起こさずにより安定して高速な結果(スループット)が得られるポイントを見つけ出すことが、実質的な性能向上につながります。
第三に、アーキテクチャへの理解を深めることです。 これからのエンジニアは、アルゴリズムだけでなく、トランジスタのスイッチング電力、GPUの電力制限メカニズム、そしてサーバー級ハードウェアの設計特性を理解する必要があります。データの値が物理的なハードウェアの「動き」を決定するという事実を認識するだけで、最適化の視野は完全に変わるはずです。
結びに:データは単なる数字ではなく、物理的な流れである
結局のところ、今回の発見が私たちに与える教訓は明確です。データは単なる数学的な計算の対象ではなく、ハードウェアという物理的な実体を動かすエネルギーの流れであるということです。
行列演算の速度がデータの値によって変わる理由は、データがトランジスタの動きを決定し、その動きが再びGPUの電力とクロックを決定するからです。この目に見えないつながりを理解する者が、未来のAI最適化競争において勝利を収めるでしょう。
皆さんはこれまで、パフォーマンス最適化を行う際、コードの論理と同じくらいハードウェアの物理的特性を考慮したことはありますか?
皆さんの最適化の経験について、ぜひコメント欄で共有してください!
参考文献
- Matrix Multiplications on GPUs Run Faster When Given "Predictable ... · news.ycombinator.com
- Understanding the Efficiency of GPU Algorithms for Matrix-Matrix ... · graphics.stanford.edu