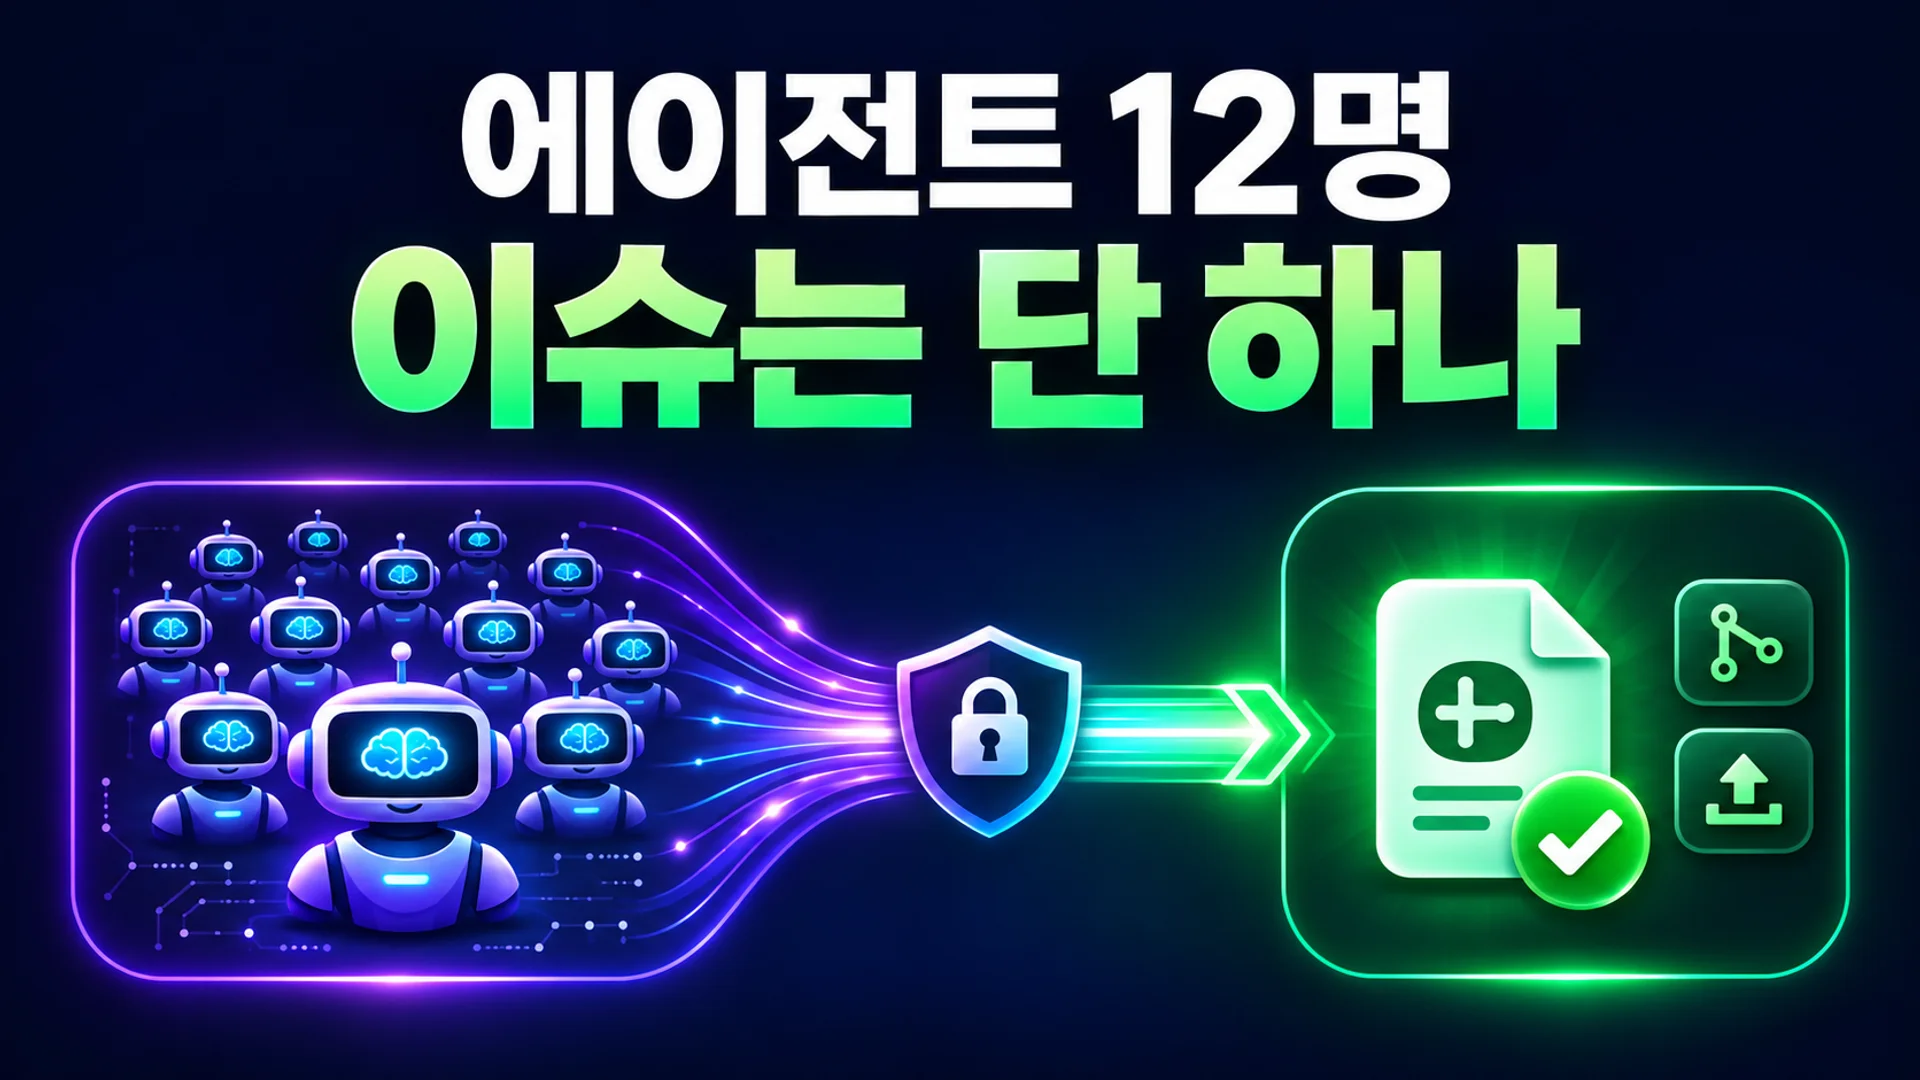
src/ 아래 흩어진 디렉터리에서 폐기된 API 호출을 찾아야 하는 상황을 떠올려 보겠습니다. 12개 디렉터리에 AI 에이전트 열두 개를 동시에 붙이면, 이슈도 열두 개 쏟아질 것 같은 생각이 듭니다. 하지만 GitHub의 에이전틱 워크플로우(gh-aw)에서는 에이전트를 아무리 많이 동원해도 최종적으로 열리는 이슈는 하나뿐입니다. 비결은 복잡한 충돌 해결 기술에 있지 않고, 애초에 에이전트에게 저장소를 수정할 권한(연필)을 쥐여주지 않는 설계에 있습니다.
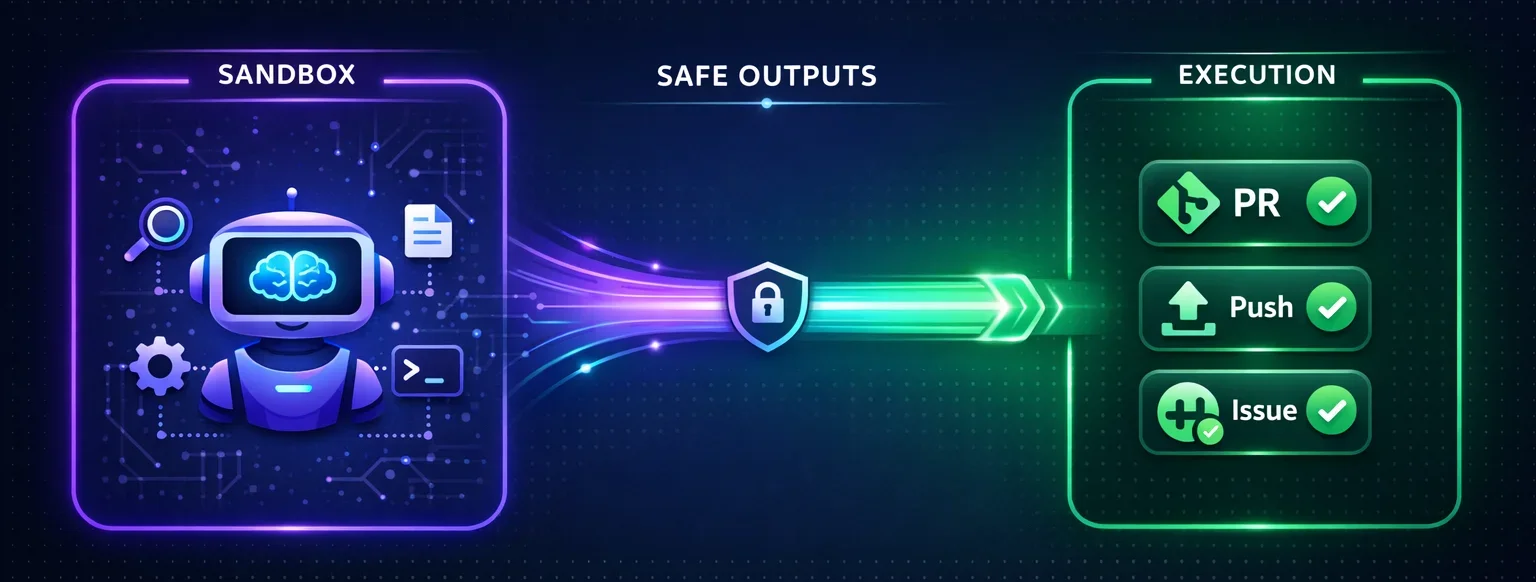
에이전트가 들고 있는 GitHub 토큰에는 쓰기 권한이 아예 없습니다. “이 코드를 저장소에 푸시해”라고 지시해도 토큰 단계에서 거절되므로 물리적으로 저장이 불가능합니다. 에이전트가 할 수 있는 유일한 출력은 “이 내용을 이슈로 만들어주세요”라는 요청 데이터를 남기는 것입니다. 이 글에서는 여러 에이전트가 병렬로 분석하되, 왜 저장소 충돌이나 중복 작업이 발생하지 않는지 그 작동 구조를 살펴봅니다.
병렬성은 ‘읽기’에 있고, ‘쓰기’는 관문 뒤에 있다
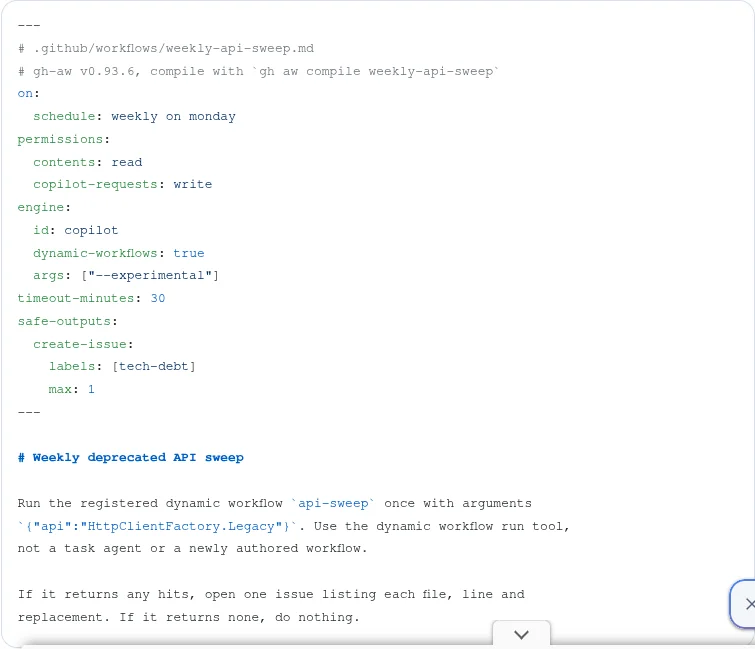
GitHub은 2026년 6월 11일 에이전틱 워크플로우를 공개 프리뷰로 전환했습니다. 이 기능은 코딩 에이전트를 GitHub Actions로 실행해 이슈 분류나 주간 요약 같은 반복 작업을 처리합니다. 이 시스템의 핵심 보안 설계 중 하나는 에이전트에게 읽기 전용 토큰만 제공하고, 비밀 값(secret) 접근을 차단하는 것입니다 1.
즉 병렬 처리는 ‘저장소 읽기와 분석’ 단계에만 존재합니다. 여러 에이전트가 동시에 서로 다른 파일을 열어 내용을 파악할 수는 있지만, 아무도 그 결과를 저장소에 직접 기록하지 못합니다. 실제 저장은 별도의 쓰기 권한을 가진 별도의 작업(job)이 담당합니다. 이 단절 구조가 병렬 실행 시 발생할 수 있는 충돌과 중복을 원천적으로 차단합니다.
Safe Outputs: 제안은 에이전트가, 실행은 시스템이
GitHub 공식 문서에서 ‘Safe Outputs’라 부르는 메커니즘이 분리된 저장을 담당합니다. 에이전트는 쓰기 권한 없이 구조화된 데이터(요청사항)만 생성하고, 이를 읽은 권한 있는 별도 잡(Job)이 실제 API를 호출합니다 2. 에이전트가 “이런 제목으로 이슈를 만들어달라”고 남기면, issues: write 권한을 가진 다른 시스템이 이를 처리하는 식입니다 2.
여기서 중복 방지의 열쇠가 되는 기본값이 있습니다. 별도 설정이 없다면 create-issue 기능은 자동으로 켜지는데, 그 상한(max)이 ‘1’로 고정됩니다 2. 라벨과 제목 접두사 역시 워크플로 ID와 연결되어 통제됩니다 2. 12개의 에이전트가 동시에 “이슈 생성”을 요청해도, 관문 역할인 시스템은 이를 확인하고 단 한 번만 실행합니다.
각 요청은 고유 ID(so_...)를 가지며, 작업 간 순서가 필요하면 depends-on으로 이전 작업의 ID를 참조해 대기열을 만듭니다. 앞선 작업이 완료되어야 다음이 실행되며, 의존 관계가 꼬이면(fail-closed) 안전을 위해 실행이 멈춥니다 2. PR 병합 또한 이 규칙을 따르는데, 에이전트가 직접 병합 권한을 갖는 것이 아니라 시스템이 정책을 검증한 뒤 승인된 건만 처리합니다 23.
실제 코드에서 보는 병렬과 순차의 경계
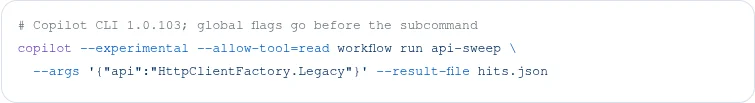
Start Debugging이 공개한 api-sweep 예제 코드는 이 흐름을 잘 보여줍니다. 이 예제는 src/ 하위의 각 디렉터리에 에이전트를 하나씩 붙여 폐기된 API 호출(HttpClientFactory.Legacy)을 찾습니다 3.
// .github/extensions/api-sweep/extension.mjs (Start Debugging 예제 기반)
const dirs = await ctx.step("dirs-v1", async () =>
  (await readdir("src", { withFileTypes: true }))
    .filter((d) => d.isDirectory())
    .map((d) => `src/${d.name}`),
);
// ctx.parallel(): 디렉터리 수만큼 에이전트를 동시 실행 (읽기/분석)
const results = await ctx.parallel(dirs.map((dir) => () =>
  ctx.agent(
    `List every call to ${api} under ${dir} and the replacement it needs. ` +
    `Return an empty list if there are none.`,
    { label: `sweep:${dir}`, schema: HITS },
  ),
));
// 결과를 합치는 단계는 순차적으로 진행됨
return { hits: results.filter(Boolean).flatMap((r) => r.hits) };
ctx.parallel() 함수를 쓰는 구간까지만 병렬 실행입니다. 각 에이전트는 찾아낸 결과를 JSON 형태로 반환하기만 합니다. 반환된 데이터들이 하나로 합쳐진 뒤, 마지막 단계에서 safe-outputs 설정(max: 1)에 따라 최종적으로 단 하나의 이슈가 생성됩니다 3. 열두 개 에이전트가 각자 발견한 내용을 가져와도, 최종 관문에서 하나로 수렴합니다.
세 가지 운영 방식과 공통의 안전 경계
멀티 에이전트를 사용하는 방식은 크게 세 가지로 나뉘며, 쓰기 권한의 유무가 다릅니다 3.
/fleet(즉석 실행): Copilot CLI 세션에서 사용자가 프롬프트를 던지면 하위 에이전트들이 즉시 작업을 분담합니다. 사람이 지켜보며 방향을 잡을 때 적합하며, 세션에 부여된 권한으로 저장이 가능합니다 3.- 동적 워크플로우 (스크립트): 분할 계획을 JavaScript 코드로 미리 정의합니다. 반복 실행이나 예산 상한이 필요한 작업에 쓰이며, 세션 권한과 코드에 따라 저장 가능 여부가 결정됩니다 3.
- gh-aw (무인 자동화): 이벤트나 스케줄에 의해 아무도 보지 않을 때 실행됩니다. 이 환경에서는 에이전트 잡이 반드시 읽기 전용이어야 하며, 모든 쓰기는 Safe Outputs 관문을 통과해야 합니다 3.
Carvana나 Marks & Spencer 같은 기업들이 gh-aw를 복잡한 시스템 변경이나 유지보수에 사용하는 것도, 결국 이러한 내장된 제어 장치가 만들어내는 신뢰 덕분입니다 1. Carvana는 여러 저장소를 동시에 건드리는 변경까지 에이전트에게 맡길 수 있었던 이유를 '유연성과 기본 제공 통제'에서 찾았고, Marks & Spencer는 이슈 분류와 의존성 유지보수에 사라지던 개발 시간을 재사용 가능한 워크플로우 카탈로그로 되돌렸습니다.
마무리
여러 AI 에이전트가 같은 저장소를 다룰 때 충돌하지 않는 이유는 그들이 똑똑하게 경쟁해서가 아닙니다. gh-aw 구조의 에이전트는 읽기 전용 토큰을 가지고 있어 물리적으로 저장소에 쓸 수 없기 때문입니다 31. 대신 생성된 요청은 max 상한과 라벨 규칙을 갖춘 별도 관문에서 검증되고, 여러 제안이 들어와도 최종 반영은 한 번만 이루어집니다 2. 병렬성이 안전하게 유지되는 것은 복잡한 머지 기술 덕분이 아니라, 쓰기를 애초에 단일 관문 뒤로 밀어냈기 때문입니다.
참고자료
- Getting Started with GitHub Agentic Workflows · kdnuggets.com↩
- Safe Outputs | GitHub Agentic Workflows · github.github.com↩
- Copilot Dynamic Workflows vs /fleet vs GitHub Agentic Workflows: Which Multi-Agent Option to Reach For - Start Debugging · startdebugging.net↩