Hacker News 用户(EA-3167)尝试在网页浏览器中调节假声带(位于真声带上方的辅助发声结构)的位置。当形成解剖学上适当的形态时,确实发出了源自蒙古和图瓦地区的传统喉音唱法呼麦(Khoomei)特有的泛音1。虽然尚未实现低音频段的卡基拉(Kargyraa),但对高音频段的西格特(Sygyt)的再现却颇为逼真1。
通过指尖改变声带和气道的形状来发出声音的这款工具名为“Chimera Vocal Synth”。由于名称容易引起误解,人们可能以为它是通过超声波或 MRI 拍摄真实声带并显示出来的设备。然而,Chimera 并非直接照亮用户喉咙的镜子,而是一种物理模拟,它通过计算机计算空气流经虚拟咽喉的过程,并以实时 3D 画面呈现。也就是说,它更接近于一个练习伙伴,让用户能够即时实验“呈现这种形状就会发出这种声音”,而不是用来诊断“我的喉咙现在处于什么状态”。
非拍摄而是计算,由虚拟气道产生的声音
Chimera 的开发者 jamesondh 在 GitHub 仓库中清晰地阐明了该项目的核心。其中产生的所有声音并非预先录制的样本,而是由空气穿过由肺、声带、分叉声道、嘴唇和鼻子构成的虚拟气道所产生的声音2。引擎采用 Rust 语言编写,转换为 WebAssembly 技术,并基于 AudioWorklet 方式在浏览器中实时处理声音2。
关键在于,声音不是被播放出来的,而是被“制作”出来的。只要用户稍微改变舌头的位置,虚拟气道的形状就会随之改变,空气流经的通道也会随之变化,从而即时改变声音的音高和共鸣音。该引擎基于 FDTD(时域有限差分法,即通过将气流按时间和空间网格划分进行计算的方法)运行2。这意味着计算机逐一计算了空气通过狭窄缝隙时产生的压力、声带振动的速度以及这些波在口腔和鼻腔中的共鸣方式2。
因此,Chimera 不同于输入文本即可发声的普通 AI 语音合成器。当输入英语单词(基于 CMUdict 词典)或 IPA(国际音标)时,它会在屏幕上显示为了发出该读音舌部和嘴唇必须如何移动的“发音动作”2。这将发音的过程而非结果可视化。
屏幕上可见且可用手调节的内容
屏幕上同时提供调节音高、呼吸压力、声带收紧强度(Pressed)以及颤音的语音控制项3。
尤其是将声带运动速度放慢 100 倍显示的功能引人注目3。在真实情况下,声带每秒振动数十次至数百次,肉眼无法分辨其形态,但如果将其放大 100 倍显示,则可以观察到声带相互接触又分离的微细动作。此外,从声门(声带之间的缝隙)到嘴唇的管腔区域、共鸣频谱,以及元音的主要共鸣频率 F1/F2 区域也一并显示出来3。
在默认设置界面上,可以看到音高 110 Hz(A2 音符)、呼吸压力 8.0 cmH₂O(将气压表示为水柱高度的单位)、Pressed 50%、颤音 0 音分等数值3。当调节这些数值时,屏幕上的共鸣曲线和气流图也会随之实时变化3。还可以连续混合并应用男性、女性和儿童的身体特征2。
| 用户可调节的项目 | 屏幕上随之变化的因素 |
|---|---|
| 舌头、嘴唇、下颌位置 | 3D 横截面中的气道形状、气流及声压流 |
| 音高、呼吸压力 | 声带振动速度、共鸣频谱的变化 |
| Pressed(声带收紧) | 声带接触模式、波形变化 |
| 元音选择 | F1/F2 共鸣频率显示区域的移动 |
通过视觉确认口型来学习发声
该工具的实用价值在于视觉反馈。Hacker News 的跨性别用户 goodmythical 评价称:“‘请将声音接近‘aunt’中的‘a’音’这样的口头指令,视觉演示可以提供更具象的引导”1。他解释说,这在适合性别认同的声音训练、歌唱和语言学习方面非常有用1。
传统的发声指导往往依赖于“张大口”、“把声音从喉咙里放出来”等抽象语言。Chimera 将这些指令转化为解剖学形状进行展示。即使是同一个元音,F1/F2 共鸣曲线也会根据舌部位置或下颌张开程度实时移动,因此用户可以通过视觉确认“这种形状产生这种声音”的对应关系来进行调节。
整体用户案例也支持这一方向。hankbond 写道,为了哄婴儿睡觉,他学习了喉音唱法(throat singing,通过喉咙共鸣发出泛音的发声),并发现很有趣的一点是:如果要让合成器也完全复制自己发出的声音,就需要弄清楚嘴巴和喉咙各部分必须呈现什么形状1。nxobject 分享了他计划通过移动舌头来掌握澳洲式“o”元音。muglug 则讲述了他先让 AI(Claude)读取 PDF 乐谱,然后花费数小时手动将合成结果调整为符合真实声音的过程1。
模拟的局限性与验证努力
用户观察也证实,模拟并不能完美重现所有条件。odo1242 报告称,当将舌头调至最左下方、嘴唇闭合并尽可能向后拉、喉部调至最顶端、软腭调至最底端时,会发出物理上不准确的、非人类的尖叫声音1。他推测,正常操作中未察觉的微小设置误差,可能在极端条件下表现为失真1。
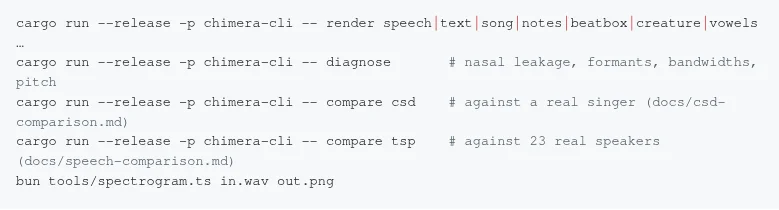
开发者 jamesondh 正在记录验证这些差异的程序。他使用 chimera CLI(命令行工具)执行离线渲染和测量,并与 Children's Song Dataset 中的真实歌手声音进行评分比较,还与 TSP 语音数据库中的 23 名真实说话人进行音素级对比2。此外,该工具还提供了分析鼻腔泄漏、共振峰(共鸣频率成分)、带宽和音高的诊断功能2。
改变假声带的位置会改变声音吗?在虚拟气道的物理模型中,确实会改变。EA-3167 成功制造出西格特泛音,以及 odo1242 在极端位置体验到不自然的声音,分别展示了事物的两面。Chimera 不是诊断我声音的医疗设备,而是一个可以视觉探究“哪种口型制造哪种声音”的实验室。
参考资料
- Chimera Vocal Synth | Hacker News · news.ycombinator.com↩
- GitHub - jamesondh/chimera-vocal-synth: the ultimate vocal synthesizer - sing, speak, beatbox, and more · github.com↩
- Chimera Vocal Synth - 기도 시뮬레이션으로 소리를 만드는 음성 합성기 | GeekNews · news.hada.io↩