“我刚刚做了 Merge(合并),为什么以前写的代码不见了?”
如果这个问题出现在你们团队的 Slack 频道中,那一刻,你们面对的将不仅仅是简单的服务故障,而是一场“灾难”。最近发生的 GitHub 事件,不仅是简单的无法访问,更是一个令人震惊的案例,它展示了我们最信任的版本控制系统是如何破坏我们宝贵的资产——代码库的。
今天,我们将深入剖析近期 GitHub 发生的致命技术事故、隐藏在其背后的生态系统结构性问题,以及我们未来应该做出怎样的应对准备。
1. 不仅仅是“瘫痪”:代码完整性崩溃的原因
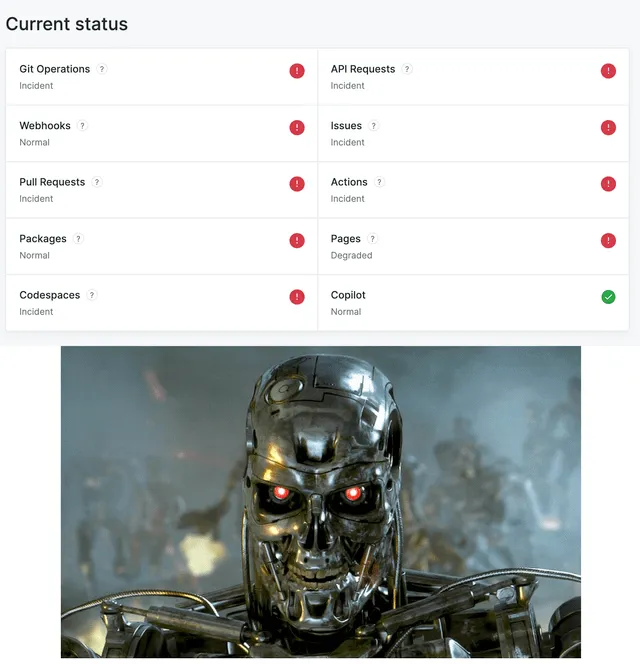
通常我们遇到的服务器故障,程度多为“无法访问网站”或“API 响应缓慢”。然而,这次 GitHub 事件的核心在于更为恐怖的数据完整性(Data Integrity)丧失。
事件的起因发生在合并 Pull Request(拉取请求)的过程中。在正常的工作流中,新代码应该被添加到现有代码之上。然而,由于系统内部逻辑错误,在执行合并操作时,反而出现了之前的关键提交被回退(Revert)的现象。
为什么这很致命?
- 历史扭曲:开发团队明确反映的变更事项消失得无影无踪,代码被强制切换回了从未经过的过去状态。
- 责任归属混乱:当代码发生非预期的变化时,极难判断这是开发者的失误还是平台的错误。
- 信任崩溃:版本控制系统(VCS)存在的意义——“变更历史的准确性”——已经崩塌。
与其说服务暂时停止,不如说“我们辛辛苦苦建立的塔,可能因为平台的一个 Bug 就彻底坍塌”,这一事实给所有工程师带来了巨大的心理冲击。
2. 被微软收购后,发生了什么变化?
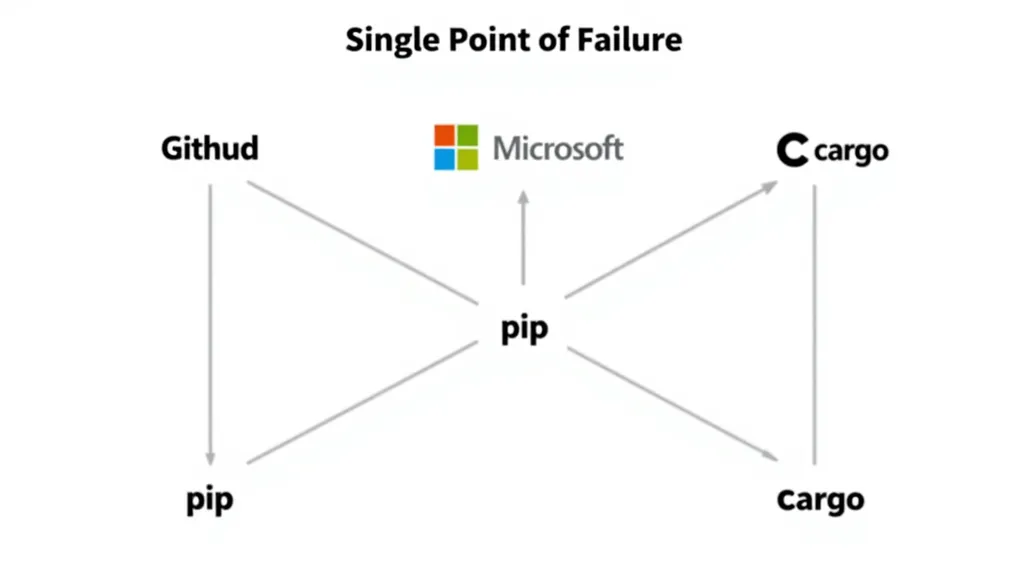
以此事故为契机,社区(如 Hacker News 等)展开了激烈的争论。核心疑问在于:“GitHub 在被微软收购后,故障频率是否变高了?”
用户指出,GitHub 正在变得越来越像一个单点故障(Single Point of Failure)。有观点认为,随着向 Azure 基础设施的迁移、内部工程团队的变化以及 GitHub Actions 向 .NET 的迁移等结构性变化频繁发生,稳定性正在动摇。
特别值得关注的是 GitHub 的垄断地位。我们常说“如果 GitHub 不稳定,换到 GitLab 或 Codeberg 不就行了吗”,但现实并非如此。
想想我们每天使用的包管理器:
pip install(Python)cargo build(Rust)go get(Go)
这些命令仍然深度依赖托管在 GitHub 上的存储库(Repository)。也就是说,如果 GitHub 崩溃,其影响将不仅仅是网站无法访问,而是全球的构建环境和部署流水线可能同时瘫痪。由于这种生态系统上的依赖性,开发者们处于一种“虽然感到不安,却无法离开 GitHub”的诡异依赖关系中。
3. 生存策略:质疑自动化
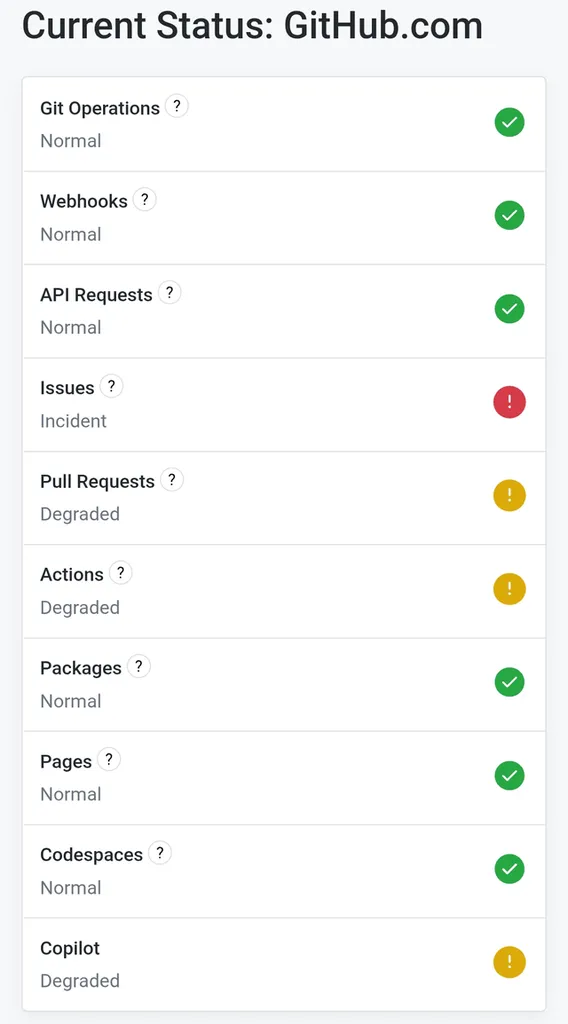
那么,我们该如何保护自己的代码免受这个庞大平台的错误影响呢?这次事件给我们留下了几条深刻的教训。
第一,自动化工具不能保证完整性。 我们信任 CI/CD 流水线和自动合并流程,但如果平台的后端逻辑出错,自动化反而会变成“快速传播错误状态的工具”。在自动化流程前后,必须设置验证结果的步骤。
第二,必须重新意识到本地环境的重要性。 当服务器状态异常时,最终能救我们的是留在自己电脑里的本地 Git 历史和备份。在所有重要的合并操作之后,必须养成在本地确认代码是否按预期反映的习惯。
第三,积极利用状态监控系统。 GitHub 为了透明地公开事故信息,运营着多种通知渠道:
- Email/SMS:基础的紧急通知。
- Slack 集成:通过与协作工具联动,确保整个团队能立即感知。
- Webhook:在需要技术性自动化响应时非常有用。
发生故障时,与其惊慌失措地问“为什么不行?”,不如通过 GitHub Status 页面以编程化的方式掌握现状并建立应对体系,这才是专业人士的做法。
4. 新领导层与变革动向
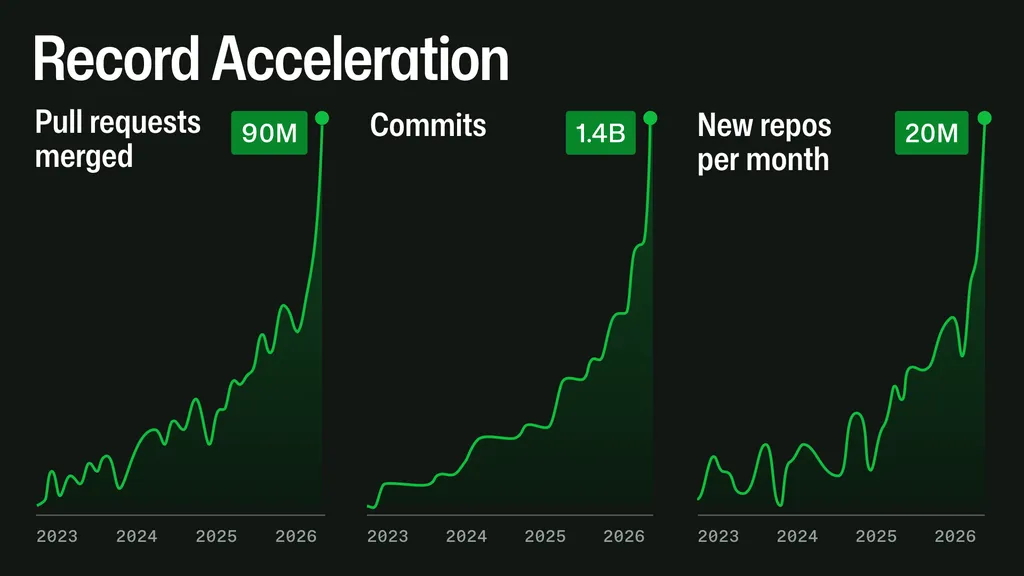
另一方面,GitHub 在混乱之中也表现出了加强组织稳定性的迹象。其中最具代表性的便是新任 CTO(首席技术官)Vladimir Fedorov 的加入。
他在 Facebook (Meta) 工作了 12 年并领导过大规模工程团队,他强调“开发者优先(developer-first)”的思维方式。这被解读为 GitHub 的战略意图,旨在解决近期发生的一系列故障和数据完整性问题,并赢回用户失去的信任。
GitHub 在平台稳定性与创新之间走钢丝,通过此次引进 CTO 能否构建出更加稳固的基础设施,仍是留给开发者的课题。
总结
这次 GitHub 事件不仅仅是接入故障,更是一个可怕的警告:平台的逻辑错误可能会改写代码的历史本身。GitHub 的垄断地位虽然为我们带来了便利,但同时也带来了巨大的单点故障风险。
最终,我们能做的最佳实践如下:
- 不要盲目迷信自动化的合并流程,务必始终验证结果。
- 保持本地环境与独立的备份策略。
- 通过 GitHub Status 通知系统敏捷地应对故障情况。
平台随时可能动摇,但我们的代码不应动摇。
对于 GitHub 的垄断地位和近期的故障,您有什么看法?如果 GitHub 明天突然停止服务,您的团队会如何应对?欢迎在评论区分享您的观点!
参考资料
- Incident with Git Operations, Issues and Pull Requests [resolved] · news.ycombinator.com
- An update on GitHub availability · github.blog
- Incident History - GitHub Status · githubstatus.com