"Acabo de hacer un merge, ¿por qué ha desaparecido el código en el que trabajé antes?"
Si esta pregunta aparece en el canal de Slack de tu equipo, en ese preciso momento te estarás enfrentando a un "desastre" que va más allá de una simple interrupción del servicio. El reciente incidente de GitHub fue un evento impactante que demostró que, más allá de una simple incapacidad de acceso, el sistema de control de versiones en el que más confiamos puede destruir nuestro activo más preciado: la base de código (codebase).
Hoy analizaremos en profundidad el reciente y crítico fallo técnico de GitHub, los problemas estructurales del ecosistema que se esconden detrás de él y qué medidas debemos tomar de ahora en adelante.
1. No es un simple "bloqueo": La razón por la que la integridad del código colapsó
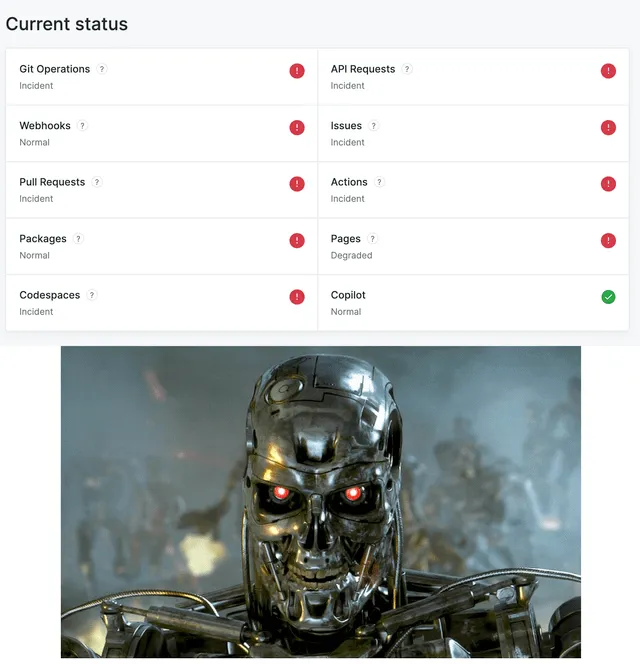
Normalmente, los fallos de servidor que experimentamos se limitan a "no se puede acceder al sitio" o "la respuesta de la API es lenta". Sin embargo, el núcleo del incidente de GitHub fue una mucho más aterradora pérdida de integridad de datos (Data Integrity).
El origen del incidente ocurrió durante el proceso de realizar un Pull Request (PR). En un flujo de trabajo normal, el nuevo código debería añadirse al código existente. No obstante, debido a un error en la lógica interna del sistema, al realizar el merge, ocurrió el fenómeno de reversión (revert) de commits importantes anteriores.
¿Por qué es esto tan fatal?
- Distorsión histórica: Los cambios que el equipo de desarrollo había implementado claramente desaparecieron sin dejar rastro, y el código fue forzado a un estado pasado por el que nunca debió volver.
- Confusión en la responsabilidad: Cuando el código cambia de forma no intencionada, es extremadamente difícil determinar si se trata de un error del desarrollador o de un fallo de la plataforma.
- Colapso de la confianza: Se ha roto la "exactitud del historial de cambios", que es la razón de ser de un sistema de control de versiones (VCS).
Más que una simple interrupción temporal del servicio, el hecho de que la torre que hemos construido con tanto esfuerzo pueda derrumbarse por un solo bug de la plataforma supone un gran impacto psicológico para todos los ingenieros.
2. Tras la adquisición de Microsoft, ¿qué ha cambiado?
A raíz de este incidente, se ha desatado un intenso debate en la comunidad (como en Hacker News). La duda central es: "¿No ha aumentado la frecuencia de los fallos desde que GitHub fue adquirido por Microsoft?".
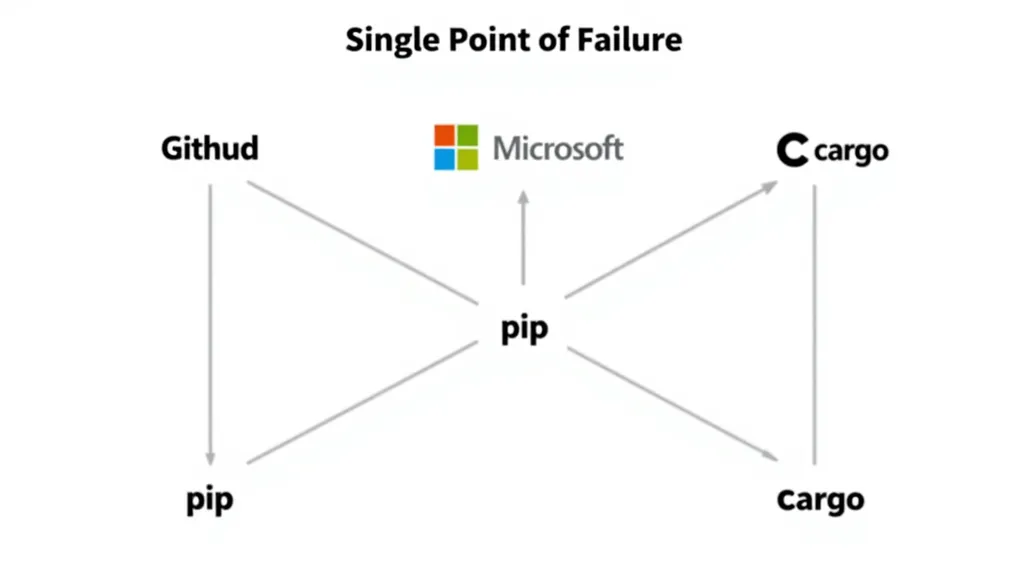
Los usuarios señalan que GitHub se está convirtiendo cada vez más en un punto único de fallo (Single Point of Failure). Argumentan que la estabilidad se está viendo afectada debido a cambios estructurales frecuentes, como la transición a la infraestructura de Azure tras la adquisición de Microsoft, los cambios en los equipos de ingeniería interna y la migración de GitHub Actions a .NET.
Un punto especialmente digno de atención es la posición monopolística de GitHub. Solemos decir: "Si GitHub es inestable, ¿por qué no nos mudamos a GitLab o Codeberg?", pero la realidad es distinta.
Pensemos en los gestores de paquetes que utilizamos a diario:
pip install(Python)cargo build(Rust)go get(Go)
Estos comandos siguen dependiendo profundamente de repositorios alojados en GitHub. Es decir, si GitHub colapsa, no se trata solo de no poder acceder a un sitio web; la estructura es tal que los entornos de construcción (build environments) y los pipelines de despliegue de todo el mundo podrían paralizarse simultáneamente. Debido a esta dependencia ecosistémica, los desarrolladores se encuentran en una "extraña relación de dependencia" donde sienten inseguridad pero no pueden abandonar GitHub.
3. Estrategia de supervivencia: Desconfía de la automatización
Entonces, ¿cómo podemos proteger nuestro código de los errores de esta gigantesca plataforma? Este incidente nos ha dejado varias lecciones dolorosas.
Primero, las herramientas de automatización no garantizan la integridad. Confiamos en los pipelines de CI/CD y en los procesos de merge automatizados, pero si la lógica del backend de la plataforma falla, la automatización se convierte en "una herramienta para propagar rápidamente un estado incorrecto". Es imprescindible incluir pasos de verificación de los resultados antes y después de los procesos automatizados.
Segundo, debemos redescubrir la importancia del entorno local. Cuando el estado del servidor sea anómalo, lo que finalmente nos salvará será el historial local de Git y los backups que residan en nuestro propio ordenador. Es necesario cultivar el hábito de verificar siempre en local si el código se ha reflejado según lo previsto después de cada merge importante.
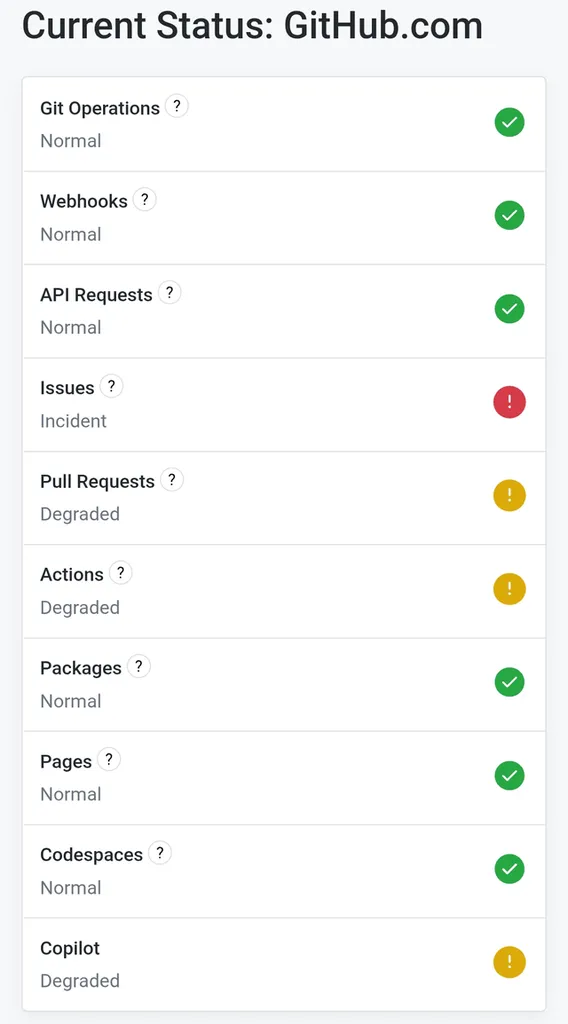
Tercero, utiliza activamente los sistemas de monitorización de estado. GitHub opera diversos canales de notificación para publicar información de forma transparente cuando ocurren incidentes.
- Email/SMS: Notificaciones de emergencia básicas.
- Integración con Slack: Configúralo para que todo el equipo se entere de inmediato al conectarlo con tus herramientas de colaboración.
- Webhook: Útil cuando se requiere una respuesta técnicamente automatizada.
En lugar de entrar en pánico preguntándote "¿por qué no funciona?", un enfoque profesional consiste en tener un sistema para identificar y responder a la situación actual de forma programática a través de la página de GitHub Status.
4. Nuevo liderazgo y movimientos de cambio
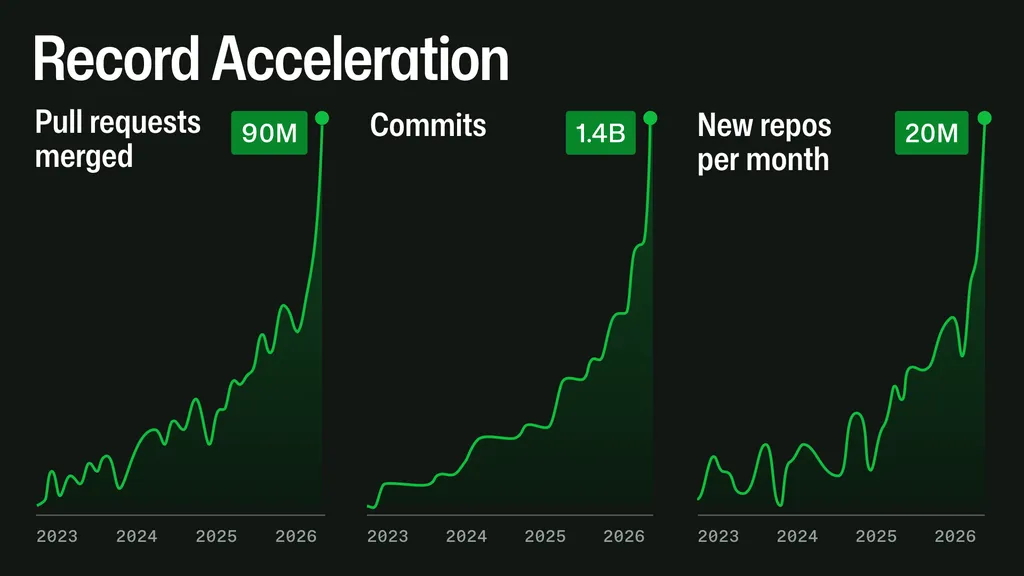
Por otro lado, en medio de este caos, GitHub está mostrando movimientos para fortalecer la estabilidad de su organización. Un ejemplo representativo es la incorporación de Vladimir Fedorov como nuevo CTO (Director de Tecnología).
Tras trabajar 12 años en Facebook (Meta) liderando grandes equipos de ingeniería, él enfatiza una mentalidad orientada al desarrollador (developer-first). Esto se interpreta como la voluntad estratégica de GitHub de resolver la serie de fallos recientes y los problemas de integridad de datos, recuperando la confianza perdida de los usuarios.
Queda como tarea para nosotros, los desarrolladores, observar hasta qué punto GitHub, que camina por la cuerda floja entre la estabilidad de la plataforma y la innovación, podrá construir una infraestructura más sólida gracias a la contratación de este nuevo CTO.
Resumen y Conclusión
El incidente de GitHub no fue un simple fallo de conexión, sino una advertencia aterradora de que los errores de lógica de una plataforma pueden alterar la historia misma del código. La posición monopolística de GitHub nos ha brindado conveniencia, pero al mismo tiempo nos ha cargado con el riesgo de ser un enorme punto único de fallo.
En última instancia, lo mejor que podemos hacer es lo siguiente:
- No confiar ciegamente en los procesos de merge automatizados; verificar siempre los resultados.
- Mantener un entorno local y una estrategia de backup independiente.
- Responder ágilmente ante situaciones de fallo mediante el sistema de notificaciones de GitHub Status.
Las plataformas pueden tambalearse en cualquier momento. Pero nuestro código no debe tambalearse.
¿Qué opinas sobre la posición monopolística de GitHub y sus recientes fallos? Si GitHub se detuviera mañana mismo, ¿cómo respondería tu equipo? ¡Comparte tu opinión en los comentarios!
Referencias
- Incident with Git Operations, Issues and Pull Requests [resolved] · news.ycombinator.com
- An update on GitHub availability · github.blog
- Incident History - GitHub Status · githubstatus.com