"방금 머지(Merge)를 했는데, 왜 예전에 작업했던 코드가 사라졌지?"
이 질문이 만약 여러분의 팀 슬랙(Slack) 채널에 올라온다면, 그 순간 여러분은 단순한 서비스 장애를 넘어선 '재앙'을 마주하게 된 것입니다. 최근 발생한 GitHub의 인시던트는 단순한 접속 불능을 넘어, 우리가 가장 신뢰해야 할 버전 관리 시스템이 어떻게 우리의 소중한 자산인 코드베이스를 파괴할 수 있는지 보여준 충격적인 사건이었습니다.
오늘은 최근 GitHub에서 발생한 치명적인 기술적 사고와 그 이면에 숨겨진 생태계의 구조적 문제, 그리고 우리가 앞으로 어떤 대비를 해야 하는지 깊이 있게 파헤쳐 보겠습니다.
1. 단순한 '먹통'이 아니다: 코드 무결성이 붕괴된 이유
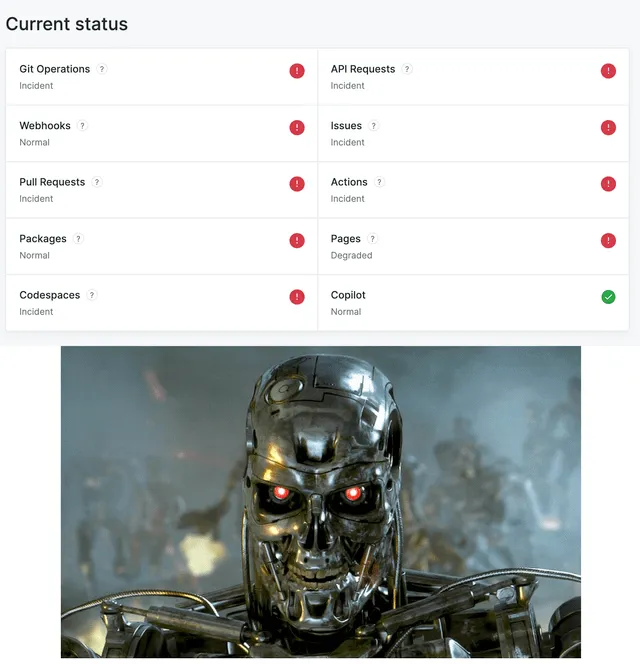
보통 우리가 겪는 서버 장애는 "사이트에 접속이 안 된다" 혹은 "API 응답이 느리다" 정도입니다. 하지만 이번 GitHub 인시던트의 핵심은 훨씬 더 공포스러운 데이터 무결성(Data Integrity) 손실에 있었습니다.
사건의 발단은 풀 리퀘스트(Pull Request)를 머지하는 과정에서 발생했습니다. 정상적인 워크플로우라면 새로운 코드가 기존 코드에 더해져야 합니다. 그런데 시스템 내부 로직의 오류로 인해, 머지를 수행하자 오히려 이전의 중요한 커밋들이 되돌아가는(Revert) 현상이 나타난 것입니다.
이것이 왜 치명적일까요?
- 역사적 왜곡: 개발팀이 분명히 반영했던 변경 사항이 흔적도 없이 사라지고, 한 번도 거친 적 없는 과거의 상태로 코드가 강제 전환되었습니다.
- 책임 소재의 혼란: 코드가 의도치 않게 변했을 때, 이것이 개발자의 실수인지 플랫폼의 오류인지 판단하기가 매우 어렵습니다.
- 신뢰의 붕괴: 버전 관리 시스템(VCS)의 존재 이유인 '변경 이력의 정확성'이 무너진 것입니다.
단순히 서비스가 잠시 멈추는 것보다, 우리가 쌓아온 공든 탑이 플랫폼의 버그 한 번에 허물어질 수 있다는 사실은 모든 엔지니어에게 큰 심리적 타격을 주었습니다.
2. Microsoft 인수 이후, 무엇이 변했나?
이번 사고를 계기로 커뮤니티(Hacker News 등)에서는 뜨거운 논쟁이 벌어졌습니다. "GitHub가 Microsoft에 인수된 이후 장애 빈도가 높아진 것 아니냐"는 의구심이 핵심이었죠.
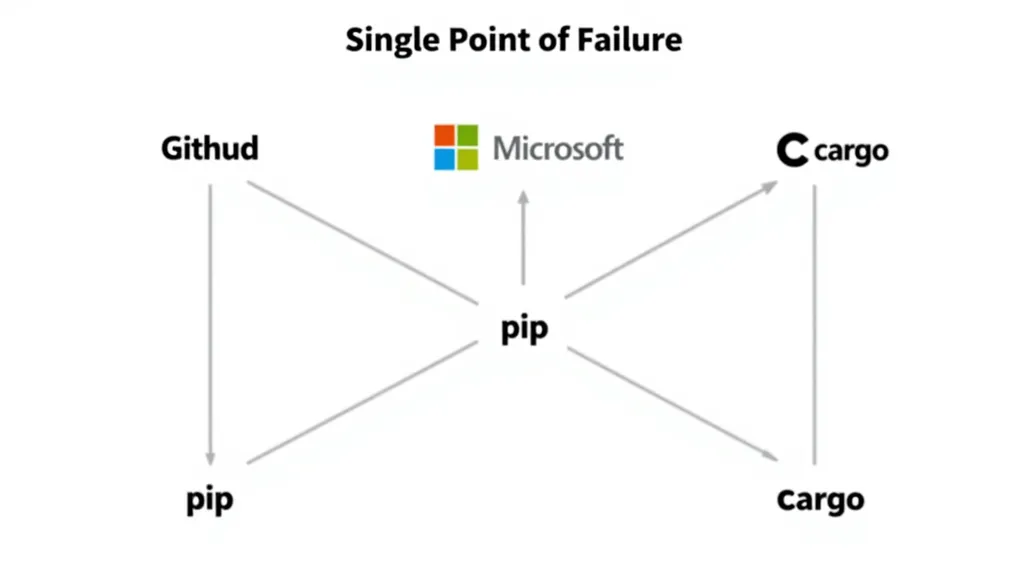
사용자들은 GitHub가 점점 더 단일 실패 지점(Single Point of Failure)이 되어가고 있다고 지적합니다. Microsoft 인수 이후 Azure 인프라로의 전환, 내부 엔지니어링 팀의 변화, GitHub Actions의 .NET 이전 등 구조적인 변화가 잦아지면서 안정성이 흔들리고 있다는 주장입니다.
특히 주목할 점은 GitHub의 독점적 지위입니다. 우리는 흔히 "GitHub가 불안정하면 GitLab이나 Codeberg로 옮기면 되지 않느냐"라고 말할 수 있을 것 같지만, 현실은 그렇지 않습니다.
우리가 매일 사용하는 패키지 관리자들을 떠올려 보세요.
pip install(Python)cargo build(Rust)go get(Go)
이 명령어들은 여전히 GitHub에 호스팅된 리포지토리에 깊게 의존하고 있습니다. 즉, GitHub가 무너지면 단순히 웹사이트 접속이 안 되는 수준을 넘어, 전 세계의 빌드 환경과 배포 파이프라인이 동시에 마비될 수 있는 구조입니다. 이러한 생태계적 종속성 때문에 개발자들은 불안함을 느끼면서도 GitHub를 떠나지 못하는 '기묘한 의존 관계'에 놓여 있습니다.
3. 살아남기 위한 전략: 자동화를 의심하라
그렇다면 우리는 이 거대한 플랫폼의 오류로부터 어떻게 우리 코드를 지킬 수 있을까요? 이번 사건은 우리에게 몇 가지 뼈아픈 교훈을 남겼습니다.
첫째, 자동화 도구는 무결성을 보장하지 않습니다. 우리는 CI/CD 파이프라인과 자동화된 머지 프로세스를 신뢰하지만, 플랫폼의 백엔드 로직이 틀리면 자동화는 오히려 '잘못된 상태를 빠르게 전파하는 도구'가 됩니다. 자동화된 프로세스 전후로 반드시 결과물을 검증하는 단계를 두어야 합니다.
둘째, 로컬 환경의 중요성을 다시 깨달아야 합니다. 서버의 상태가 이상할 때 우리를 구해줄 것은 결국 내 컴퓨터에 남아 있는 로컬 Git 히스토리와 백업입니다. 모든 중요한 머지 작업 이후에는 로컬에서 코드가 의도한 대로 반영되었는지 반드시 확인하는 습관이 필요합니다.
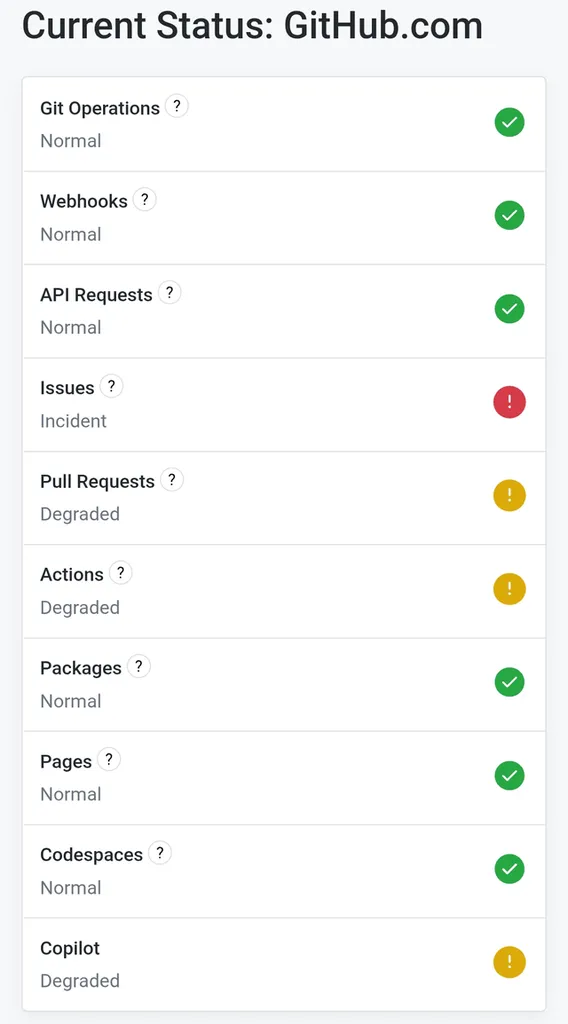
셋째, 상태 모니터링 시스템을 적극 활용하세요. GitHub는 사고 발생 시 정보를 투명하게 공개하기 위해 다양한 알림 채널을 운영합니다.
- Email/SMS: 기본적인 긴급 알림.
- Slack 통합: 협업 툴과 연동하여 팀 전체가 즉시 인지할 수 있도록 설정.
- Webhook: 기술적으로 자동화된 대응이 필요한 경우 유용함.
장애가 발생했을 때 "왜 안 되지?"라고 당황하기보다, GitHub Status 페이지를 통해 현재 상황을 프로그래밍 방식으로 파악하고 대응하는 체계를 갖추는 것이 프로페셔널한 접근입니다.
4. 새로운 리더십과 변화의 움직임
한편, GitHub는 이러한 혼란 속에서 조직의 안정성을 강화하려는 움직임도 보이고 있습니다. 최근 새로운 CTO(수석기술책임자)로 선임된 볼라디미르 페도로프(Vladimir Fedorov)의 합류가 대표적입니다.
페이스북(Meta)에서 12년간 근무하며 대규모 엔지니어링 팀을 이끌었던 그는, 개발자 우선(developer-first) 마인드셋을 강조합니다. 이는 최근 발생한 일련의 장애와 데이터 무결성 이슈를 해결하고, 사용자들에게 잃어버린 신뢰를 되찾아주겠다는 GitHub의 전략적 의지로 풀이됩니다.
플랫폼의 안정성과 혁신 사이에서 줄타기를 하고 있는 GitHub가 이번 CTO 영입을 통해 얼마나 더 견고한 인프라를 구축할 수 있을지는 우리 개발자들의 숙제로 남았습니다.
요약 및 결론
이번 GitHub 인시던트는 단순한 접속 장애가 아니라, 플랫폼의 로직 오류가 코드의 역사 자체를 뒤바꿀 수 있다는 무서운 경고였습니다. GitHub의 독점적 지위는 우리에게 편리함을 주었지만, 동시에 거대한 단일 실패 지점이라는 리스크를 안겨주었습니다.
결국 우리가 할 수 있는 최선은 다음과 같습니다.
- 자동화된 머지 프로세스를 맹신하지 말고, 항상 결과물을 검증할 것.
- 로컬 환경과 별도의 백업 전략을 유지할 것.
- GitHub Status 알림 시스템을 통해 장애 상황에 기민하게 대응할 것.
플랫폼은 언제든 흔들릴 수 있습니다. 하지만 우리의 코드는 흔들리지 않아야 합니다.
여러분은 GitHub의 이러한 독점적 지위와 최근의 장애들에 대해 어떻게 생각하시나요? 만약 GitHub가 내일 당장 멈춘다면, 여러분의 팀은 어떻게 대응하실 건가요? 댓글로 의견을 나눠주세요!
참고자료
- Incident with Git Operations, Issues and Pull Requests [resolved] · news.ycombinator.com
- An update on GitHub availability · github.blog
- Incident History - GitHub Status · githubstatus.com