「さっきマージ(Merge)したのに、なんで以前作業したコードが消えてるんだ?」
もしこの質問が、あなたのチームのSlackチャンネルに投稿されたとしたら、その瞬間、あなたは単なるサービス障害を超えた「災厄」に直面したことになります。最近発生したGitHubのインシデントは、単なる接続不能を超え、私たちが最も信頼すべきバージョン管理システムがいかにして私たちの貴重な資産であるコードベースを破壊し得るかを示した、衝撃的な事件でした。
今日は、最近GitHubで発生した致命的な技術的事故と、その背後に隠されたエコシステムの構造的な問題、そして私たちが今後どのような備えをすべきかを深く掘り下げていきます。
1. 単なる「停止」ではない:コードの整合性が崩壊した理由
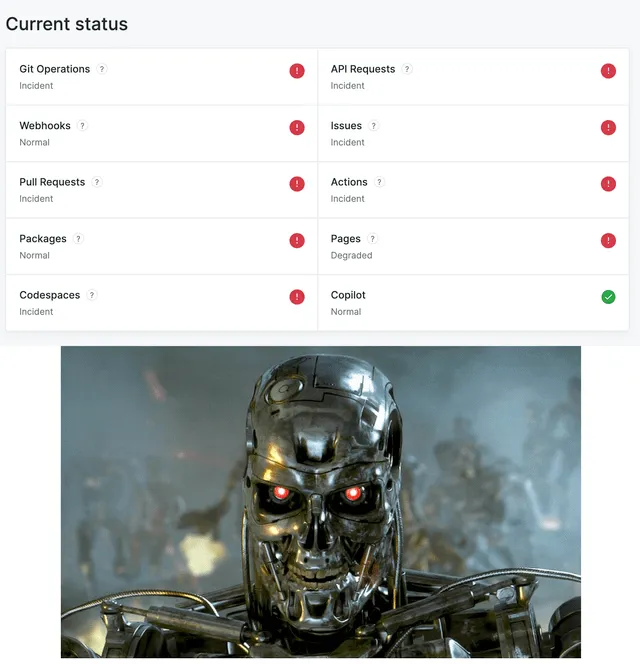
通常、私たちが経験するサーバー障害は「サイトにアクセスできない」あるいは「APIのレスポンスが遅い」といった程度です。しかし、今回のGitHubインシデントの核心は、はるかに恐ろしいデータ整合性(Data Integrity)の損失にありました。
事の発端は、プルリクエスト(Pull Request)をマージする過程で発生しました。正常なワークフローであれば、新しいコードが既存のコードに追加されるはずです。しかし、システム内部ロジックのエラーにより、マージを実行した結果、むしろ以前の重要なコミットが巻き戻る(Revert)現象が現れたのです。
これがなぜ致命的なのでしょうか?
- 履歴の歪曲: 開発チームが確実に反映した変更事項が跡形もなく消え去り、一度も通ったことのない過去の状態へとコードが強制的に遷移してしまいました。
- 責任所在の混乱: コードが意図せず変化した際、それが開発者のミスなのかプラットフォームのエラーなのかを判断するのが非常に困難になります。
- 信頼の崩壊: バージョン管理システム(VCS)の存在理由である「変更履歴の正確性」が崩れ去ったのです。
単にサービスが一時的に止まることよりも、私たちが積み上げてきた努力の結晶が、プラットフォームのバグ一つで崩れ去る可能性があるという事実は、すべてのエンジニアに大きな心理的打撃を与えました。
2. Microsoft買収後、何が変わったのか?
今回の事故をきっかけに、コミュニティ(Hacker Newsなど)では激しい論争が巻き起こりました。「GitHubがMicrosoftに買収されてから、障害の頻度が高まったのではないか」という疑念が核心にありました。
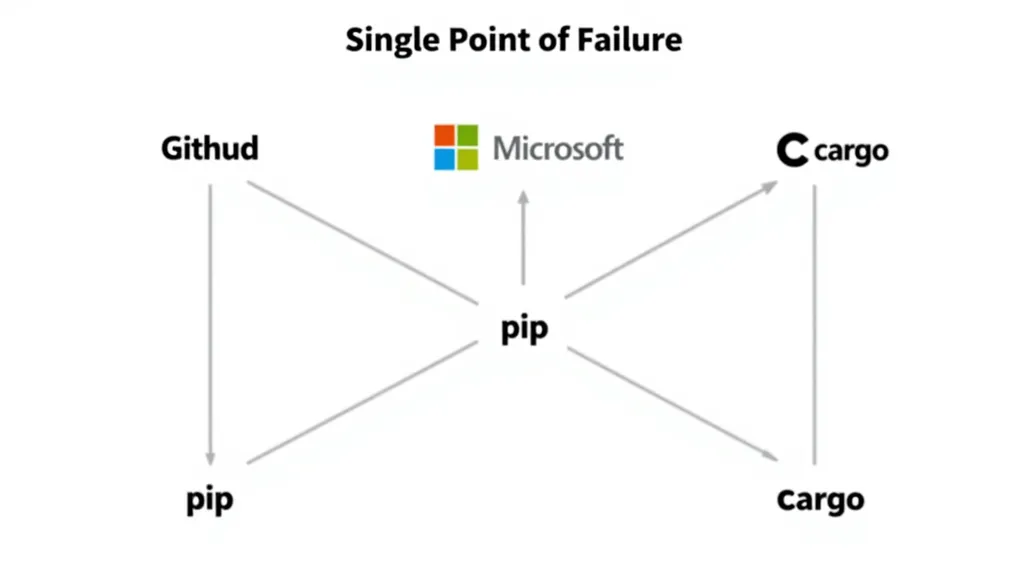
ユーザーたちは、GitHubがますます**単一障害点(Single Point of Failure)**になりつつあると指摘しています。Microsoft買収後のAzureインフラへの移行、内部エンジニアリングチームの変化、GitHub Actionsの .NET 移行など、構造的な変化が頻繁に起きることで安定性が揺らいでいるという主張です。
特に注目すべきは、GitHubの独占的な地位です。「GitHubが不安定なら、GitLabやCodebergに移ればいいじゃないか」と口では言えるかもしれませんが、現実はそうではありません。
私たちが毎日使用しているパッケージマネージャーを思い浮かべてみてください。
pip install(Python)cargo build(Rust)go get(Go)
これらのコマンドは、依然としてGitHubでホスティングされているリポジトリに深く依存しています。つまり、GitHubが崩壊すれば、単にウェブサイトにアクセスできなくなるレベルを超え、全世界のビルド環境とデプロイパイプラインが同時に麻痺しかねない構造なのです。このようなエコシステム的な依存関係のため、開発者は不安を感じながらもGitHubを離れられない「奇妙な依存関係」に置かれています。
3. 生き残るための戦略:自動化を疑え
では、私たちはこの巨大なプラットフォームのエラーから、どのようにして自分のコードを守ればよいのでしょうか。今回の事件は、私たちにいくつかの痛烈な教訓を残しました。
第一に、自動化ツールは整合性を保証しません。 私たちはCI/CDパイプラインや自動化されたマージプロセスを信頼していますが、プラットフォームのバックエンドロジックが間違っていれば、自動化はむしろ「誤った状態を高速に伝播させる道具」となります。自動化されたプロセスの前後には、必ず成果物を検証するステップを設けるべきです。
第二に、ローカル環境の重要性を再認識する必要があります。 サーバーの状態がおかしくなったときに私たちを救ってくれるのは、結局のところ自分のコンピュータに残っているローカルのGit履歴とバックアップです。すべての重要なマージ作業の後は、ローカルでコードが意図通りに反映されているかを必ず確認する習慣が必要です。
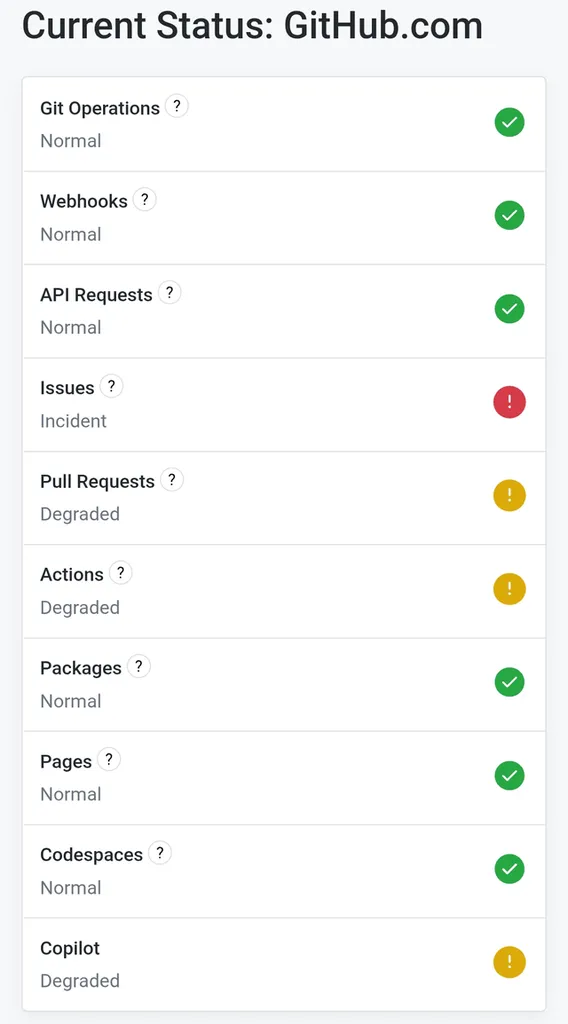
第三に、ステータスモニタリングシステムを積極的に活用してください。 GitHubは事故発生時に情報を透明に公開するため、さまざまな通知チャネルを運営しています。
- Email/SMS: 基本的な緊急通知。
- Slack統合: コラボレーションツールと連携し、チーム全体が即座に把握できるように設定。
- Webhook: 技術的に自動化された対応が必要な場合に有用。
障害が発生したときに「なぜ動かないんだ?」と慌てるのではなく、GitHub Statusページを通じて現在の状況をプログラミング的に把握し、対応できる体制を整えることがプロフェッショナルなアプローチです。
4. 新しいリーダーシップと変化の動き
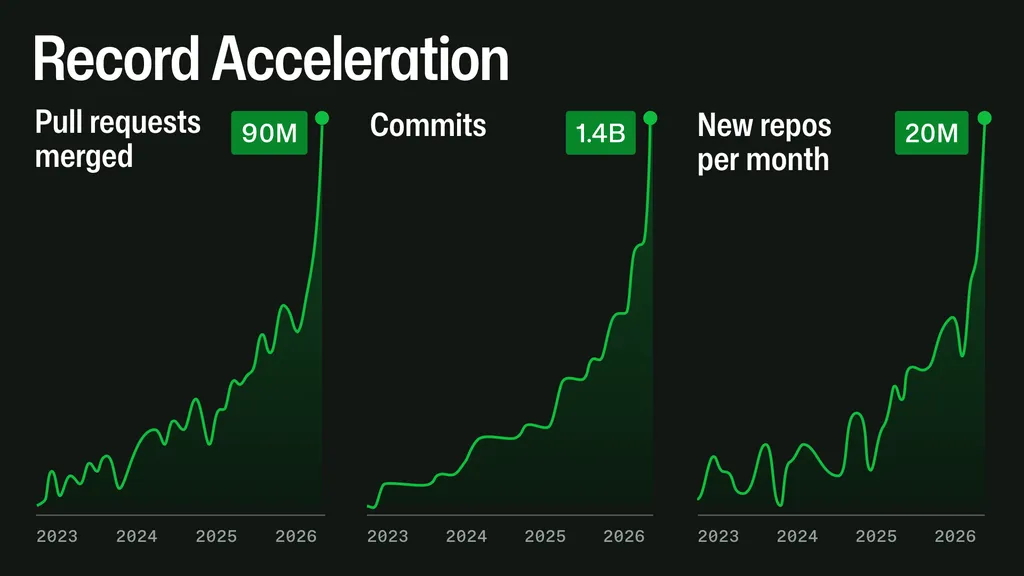
一方で、GitHubはこの混乱の中で組織の安定性を強化しようとする動きも見せています。最近、新しいCTO(最高技術責任者)に任命されたVladimir Fedorovの合流がその代表例です。
Facebook (Meta) で12年間勤務し、大規模なエンジニアリングチームを率いた彼は、「デベロッパー・ファースト(developer-first)」のマインドセットを強調しています。これは、最近発生した一連の障害とデータ整合性の問題を解決し、ユーザーに失われた信頼を取り戻すというGitHubの戦略的な意志と解釈できます。
プラットフォームの安定性とイノベーションの間で綱渡りをしているGitHubが、今回のCTO招聘を通じてどれほど強固なインフラを構築できるかは、私たち開発者たちの課題として残されました。
まとめおよび結論
今回のGitHubインシデントは、単なる接続障害ではなく、プラットフォームのロジックエラーがコードの歴史そのものを書き換え得るという恐ろしい警告でした。GitHubの独占的な地位は私たちに利便性をもたらしましたが、同時に巨大な単一障害点というリスクを突きつけました。
結局、私たちができる最善策は以下の通りです。
- 自動化されたマージプロセスを盲信せず、常に成果物を検証すること。
- ローカル環境と別途のバックアップ戦略を維持すること。
- GitHub Status通知システムを通じて、障害状況に機敏に対応すること。
プラットフォームはいつでも揺らぎ得ます。しかし、私たちのコードは揺らいではなりません。
皆さんはGitHubのこのような独占的な地位と最近の障害についてどうお考えですか?もしGitHubが明日突然止まったら、あなたのチームはどう対応しますか?コメントで意見を聞かせてください!
参考文献
- Incident with Git Operations, Issues and Pull Requests [resolved] · news.ycombinator.com
- An update on GitHub availability · github.blog
- Incident History - GitHub Status · githubstatus.com