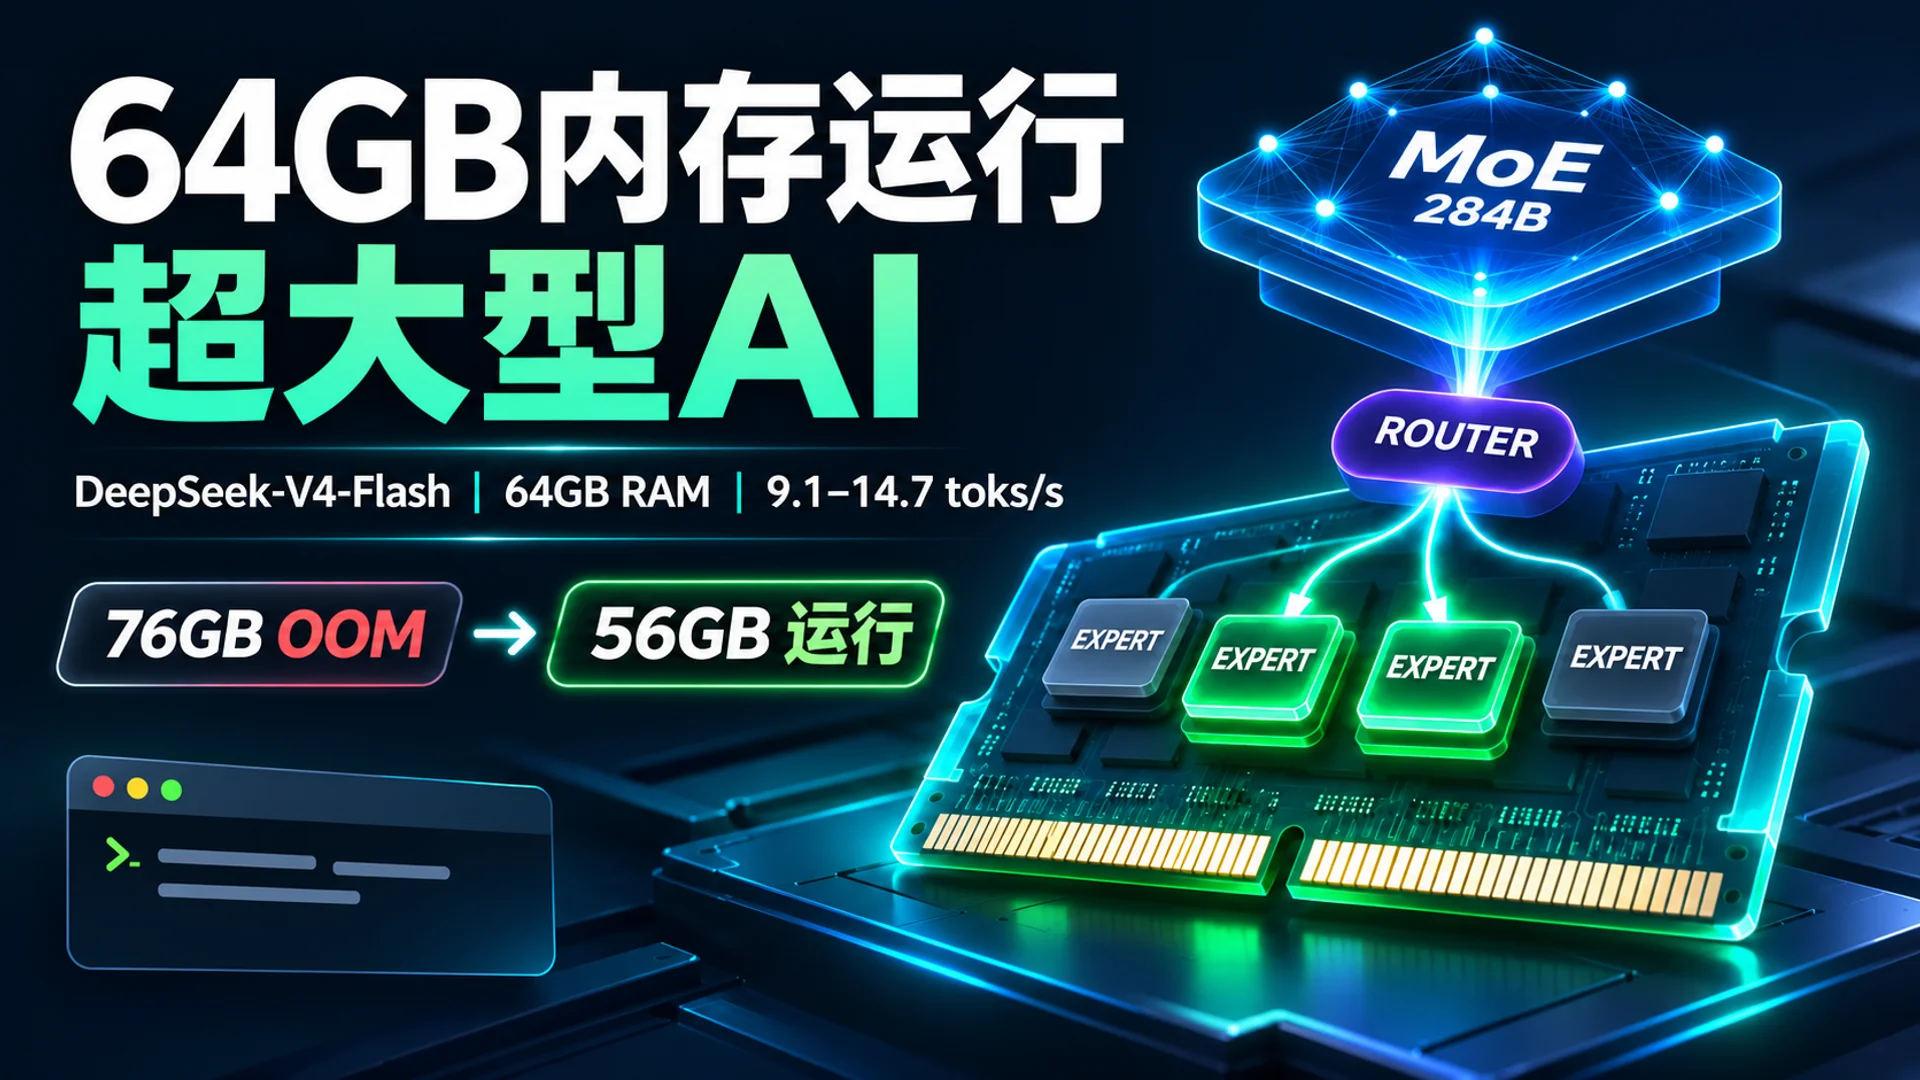
在同一计算机环境下,仅凭文件大小差异便存在“无法运行”与“可用”的分界。GitHub 用户 synchopate 公开的项目 llama-modchip v2.4.0 具体证实了这一界限。总参数为 284.33B(约 2,843 亿个)的 DeepSeek-V4-Flash 模型,若直接加载标准量化文件(76.87GiB)至配备 AMD Ryzen 9 9955HX 和 64GB RAM 的 Linux 机器,操作系统会因内存不足(OOM, Out of Memory)错误而终止进程。
然而,该项目提供了同一模型权重重新组装为 56.56GiB 的文件。使用专用二进制文件运行此文件时,常驻内存(VmRSS)可维持在 57.61~58.9GiB 水平,且无需 NVMe 交换分区即可每秒生成 9~15 个 token(AI 处理句子的基本单位,对应一个单词或单词的一部分)12。约 20GiB 的差异解决了加载问题。下文将基于项目公开的数据,说明该技术如何突破 64GB 内存的物理限制,以及普通用户能感知到的性能水平。
MoE 结构突破 64GB 内存墙的物理依据
在 CPU 上运行大型语言模型(LLM)时,瓶颈并非计算速度,而是内存带宽。因为从 RAM 加载数据的时间远长于 CPU 计算数据的时间。llama-modchip 的技术文档(ARCHITECTURE.md)用具体数值说明了这一现象。
若将典型的“稠密(dense)”30B 模型以 Q4_0(4 位级)量化加载,每生成一个 token 都需要从 RAM 读取约 17GB 的完整权重。DDR5 双通道的实际读取速度约为每秒 75GB,因此 75(带宽)÷ 17(数据量)= 每秒 4.4 个 token成为物理上限。无论 CPU 性能多好,都难以突破这一限制3。
此时,MoE(Mixture of Experts,混合专家)结构成为了解决方案。DeepSeek-V4-Flash 是一个由 43 层组成的 MoE 模型,处理每个 token 时仅激活全部专家中的 6 个(路由专家)和 1 个(共享专家)。实际读取的参数量仅为13.17B(总量的 4.6%)4。当需要读取的数据量减少时,带宽瓶颈也随之缓解。对于激活参数量为 3B 的 Nemotron-3.5 模型,每个 token 只需读取约 1.8GB,理论上可达每秒 41.6 个 token3。
但是,“读取量少”与“存储量小”是不同的概念。即使读取量减少,在将文件加载到 RAM 的瞬间仍需要完整的存储容量。76.87GiB 的文件往往在数据完全读取前就被 OOM 杀手终止进程。因此,llama-modchip 必须同时解决两个问题:① 将存储的权重块本身压缩至 64GB 以下,② 最大化 CPU 读取数据的速度。
将权重大小减少 20GiB 的压缩数学
llama-modchip 为将文件大小从 76.87GiB 降至 56.56GiB,结合了两种自定义转换技术12。
1. 基于 Hessian 的压缩 (SwiGLU-H2)
采用“解析式二阶 Hessian”方式压缩 MoE 专家权重。Hessian 矩阵是表示模型对输入变化敏感程度的二阶导数信息。根据项目文档,对注意力机制(Attention)中使用的矩阵 wo_b × wo_a 进行奇异值分解(SVD)分析后发现,即使裁剪掉总秩的 25%,与原输出方向的相似度(余弦相似度)仍保持在 99.82%4。这确立了被裁剪数值对实际输出几乎无影响的计算依据,从而甄别出可丢弃的成分,并据此将 MoE 专家权重视为 IQ1_S 级别进行压缩。
2. 张量格式转换 (Fractal-64) 将多头潜在注意力(MLA)张量转换为“基于格雷码的 Q2_0”格式(每权重平均 3.75 位,bpw)124。这是一种使用块大小 64 和 BF16 缩放的专用格式。经过这两个过程,总数据量减少 20.31GiB,最终文件大小降至 64GB 以下,从而实现加载。
为了确保压缩数据在 CPU 内部快速处理,还应用了利用包含 AVX-512BW ZMM 寄存器的 4 级内存层级(ZMM 寄存器 → L1D 32KB → L2 1MB → L3 64MB)的**4 级平铺(Tiling)**技术。通过此优化,一次性处理 512 个 token 的预填充(输入处理)速度从每秒 25.0 个 token 提升至 44.36 个 token,提高了约 77%12。
响应速度感知:每秒 9 个 token 是什么水平
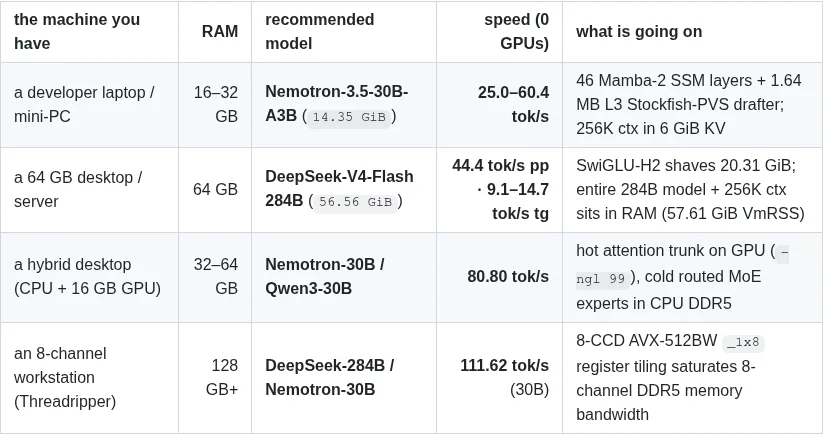
将数字转化为实际使用体验,如下所示。
- Top-5 剪枝模式:纯 9.68~9.87 个 token(与 Gate-First SwiGLU 结合使用时可达 10.15 个 token)对第三层及以后的层应用 Top-5 L₂ 剪枝时,模拟质量评估指标困惑度(PPL)增加 0.42%,但前 1 个 token 的匹配率高达 95.8%124。
作为参考,激活参数量为 3B 的 Nemotron 模型在同一 CPU 上的基础生成速度约为每秒 25 个 token,应用推测解码后平均为 48 个 token(最高 60 个 token),可实现实质性的实时对话1。DeepSeek-V4-Flash 级模型是在“大型模型的智能”与“64GB 内存的限制”之间妥协的结果。
限制事项:必须使用专用二进制文件与质量争议
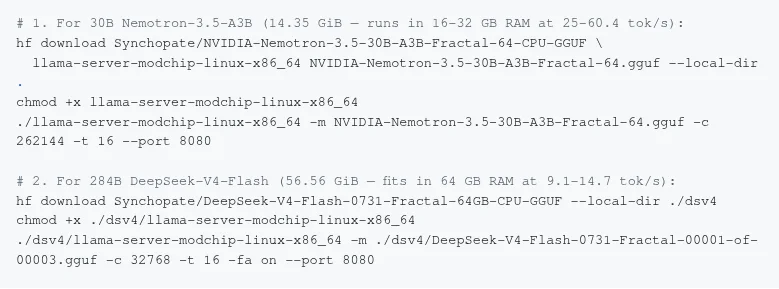
使用此技术需考虑以下限制事项。
- 兼容性问题:Fractal-64 使用专用张量格式(类型 ID 40)。因此,在未修改的标准执行器(llama.cpp, Ollama, LM Studio 等)中会出现
unknown tensor type 40错误,无法打开文件。必须使用 llama-modchip 提供的单个二进制文件(Linux x86_64)运行12。 - 质量争议:关于压缩率(3.75bpw)的实际质量,社区中存在争议。有人指出在 4 位以下量化时性能会急剧下降(基于特定论文),但也有用户报告“在我的环境中,2 位的 DeepSeek 已经足够实用”5。必须区分:项目方公开的 KL 散度(分布相似度)或余弦相似度数值代表的是“与原始版本的数学接近度”,并不保证用户感知到的对话质量45。
结论:MoE 结构与压缩技术结合带来的成果
llama-modchip 的案例表明,存在在 64GB 内存上运行 284B 级大型模型的具体路径。核心在于MoE 结构导致的每个 token 读取量减少(13.17B,占总量 4.6%)与存储容量压缩(76.87GiB → 56.56GiB)相结合的计算逻辑。
只有满足这两个条件(每个 token 读取量减少和存储容量压缩),才能同时实现“加载成功”和“每秒 9~15 个 token 的响应”。不过,该技术要求使用专用执行文件(在未修补的 llama.cpp、Ollama、LM Studio 中会出现 unknown tensor type 40 错误)12,且质量取决于设置。默认的 Top-6 无损模式在使用压缩文件时记录为每秒 9.06~9.95 个 token(应用 PVS 时为每秒 11.5~14.7 个 token),同时保持与原始文件相比 KL 散度为 0、“0.00% Bit-Exact”12,但 Top-5 剪枝模式的困惑度增加约 0.42%,将专家减少至 4 个的 Top-4 模式增加幅度更大,约为 2.85%14。如果是“在没有显卡的情况下运行巨型 AI”的情形,MoE 模型与优化工具的组合可能成为实质性的替代方案。
参考资料
- Llama-modchip: GPU 없이 64GB RAM에서 284B DeepSeek 실행 | GeekNews · news.hada.io↩
- ↩
- ↩
- ↩
- Llama-modchip: 284B DeepSeek on 64GB RAM, no GPU | Hacker News · news.ycombinator.com↩



