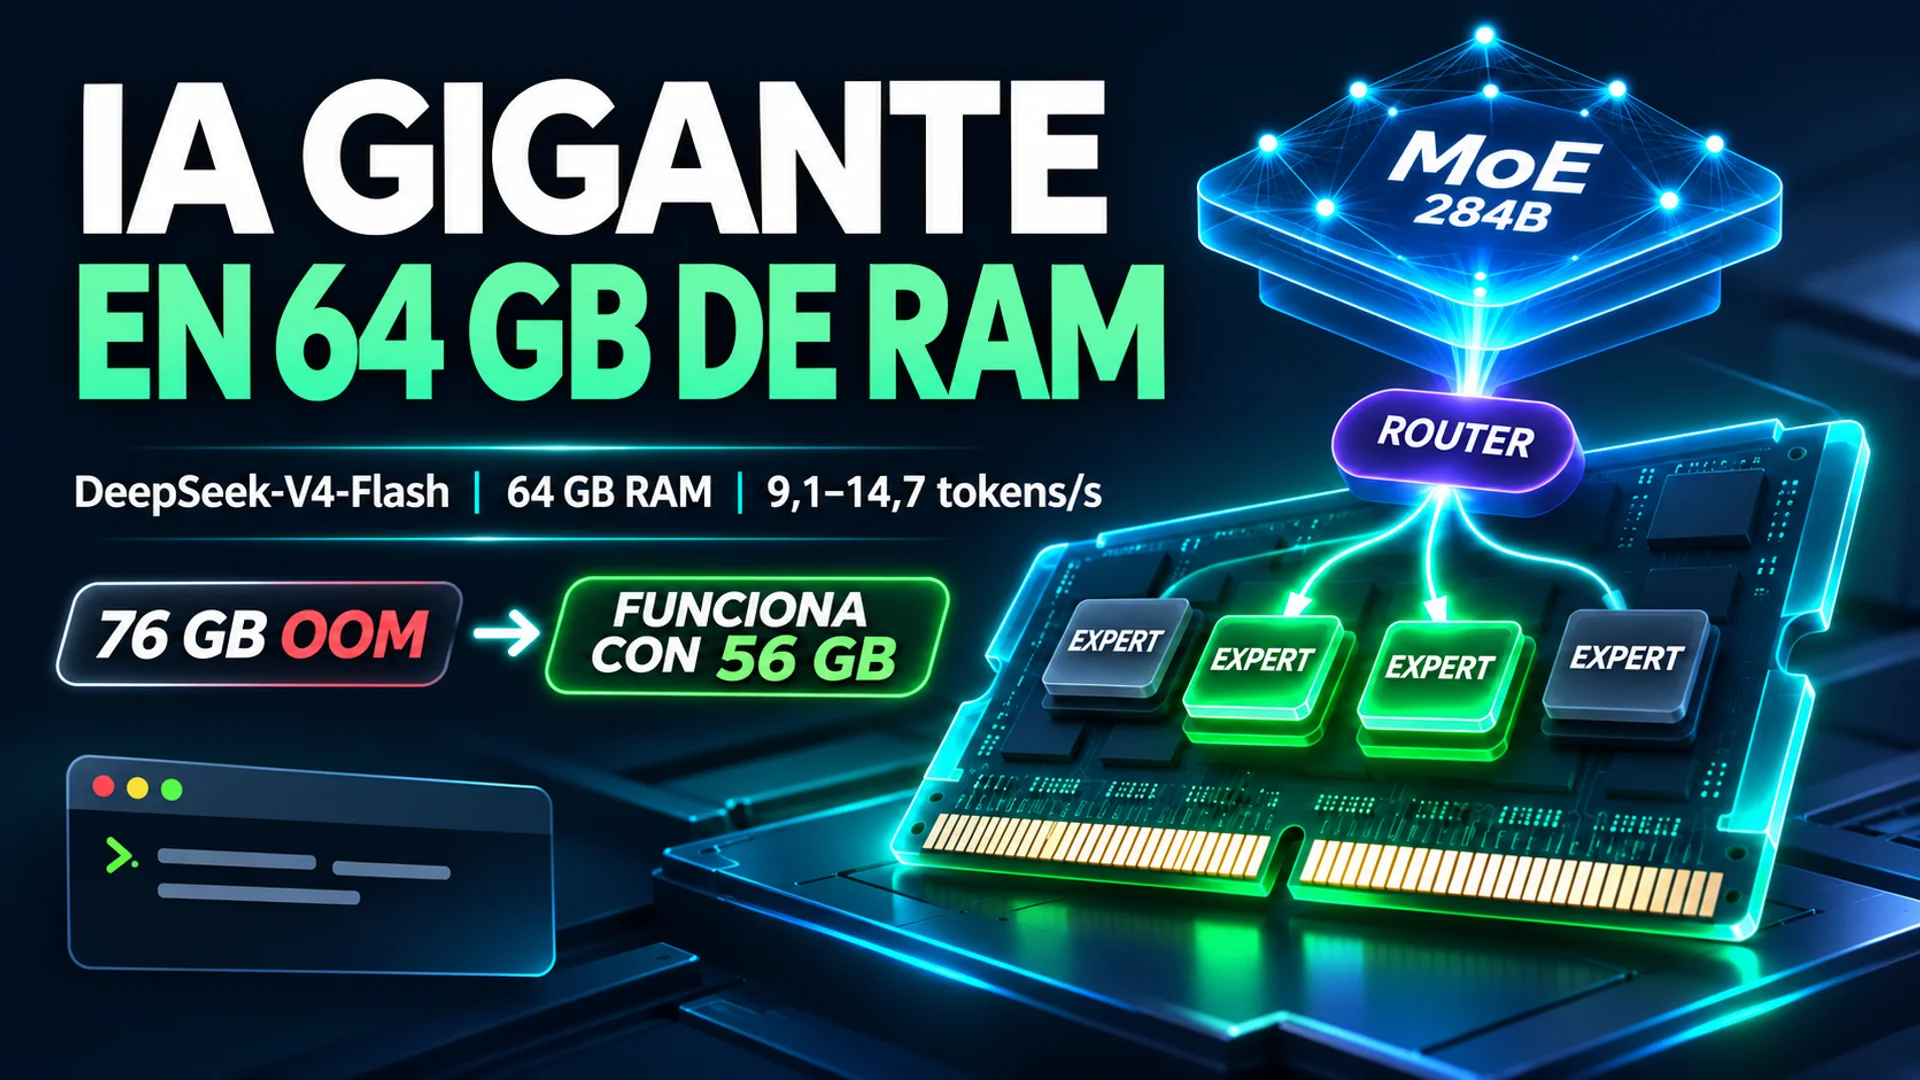
Existe una situación en la que la frontera entre 'no ejecutable' y 'utilizable' se define únicamente por el tamaño del archivo en un mismo entorno de computadora. El proyecto llama-modchip v2.4.0, publicado por el usuario de GitHub synchopate, demostró concretamente esta frontera. Si el modelo DeepSeek-V4-Flash, con un total de 284,33B (aproximadamente 284 300 millones) de parámetros, se carga en una máquina Linux con AMD Ryzen 9 9955HX y 64GB de RAM utilizando el archivo de cuantización estándar (76,87GiB) tal cual, el sistema operativo arroja un error de falta de memoria (OOM, Out of Memory) y finaliza el proceso.
Sin embargo, este proyecto proporcionó un archivo que reensambló los pesos del mismo modelo a 56,56GiB. Al ejecutar este archivo con el binario dedicado, la memoria residente (VmRSS) permanece en niveles de 57,61~58,9GiB y genera 9~15 tokens por segundo (la unidad básica con la que la IA procesa oraciones, correspondiente a una palabra o parte de una palabra) sin utilizar intercambio NVMe12. Una diferencia de aproximadamente 20GiB resolvió la cuestión de la carga. A continuación, se explica cómo esta tecnología superó el límite físico de los 64GB de RAM y qué nivel de rendimiento puede experimentar el usuario promedio, basándose en las cifras publicadas por el proyecto.
La base física de cómo la estructura MoE superó la barrera de los 64GB de RAM
El cuello de botella al ejecutar un modelo de lenguaje grande (LLM) en CPU no es la velocidad de cálculo, sino el ancho de banda de memoria. Esto se debe a que el tiempo necesario para cargar datos desde la RAM es mucho más prolongado que el tiempo que la CPU tarda en procesar los datos. La documentación técnica de llama-modchip (ARCHITECTURE.md) explica este fenómeno con cifras concretas.
Al cargar un modelo estándar 'denso' de 30B con cuantización Q4_0 (nivel de 4 bits), es necesario leer desde la RAM aproximadamente 17GB de pesos totales por cada token generado. Dado que la velocidad real de lectura de DDR5 en doble canal ronda los 75GB por segundo, 75(ancho de banda) ÷ 17(volumen de datos) = 4,4 tokens por segundo constituye el límite físico superior. Por muy potente que sea la CPU, es difícil superar este límite3.
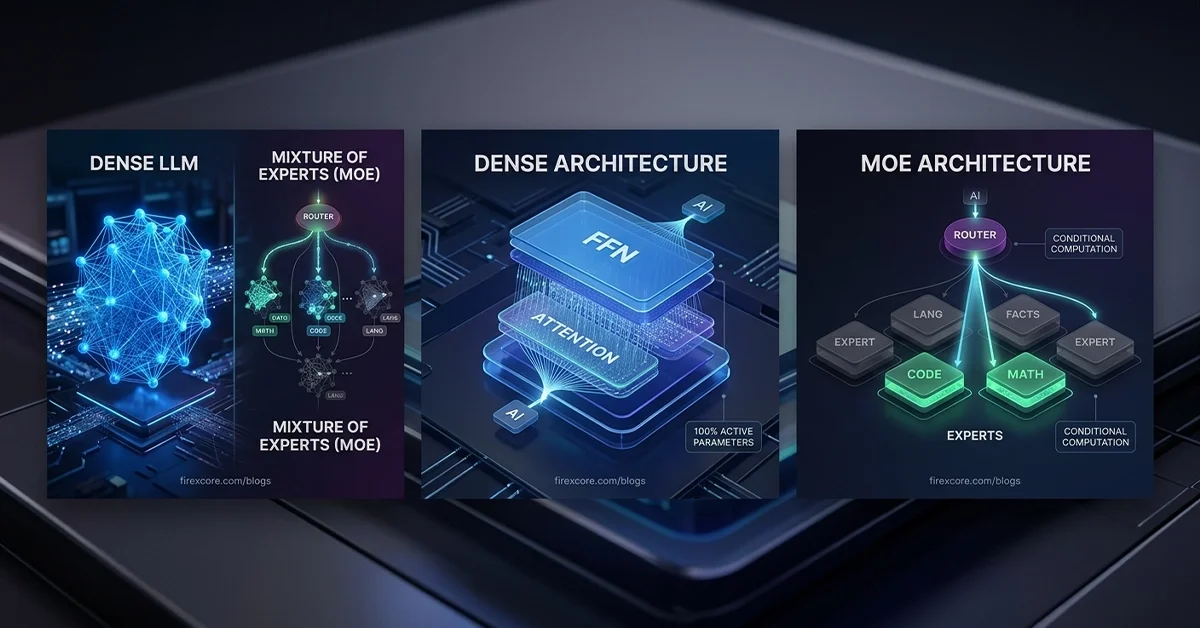
Aquí es donde la estructura de MoE (Mixture of Experts, Mezcla de Expertos) ofrece la solución. DeepSeek-V4-Flash es un modelo MoE compuesto por 43 capas, pero al procesar un token solo se activan 6 de la totalidad de los expertos (expertos de enrutamiento) y 1 (experto compartido). Los parámetros que realmente se leen son apenas 13,17B(el 4,6% del total)4. Al reducir la cantidad de datos que se deben leer, también se alivia el cuello de botella del ancho de banda. En el caso del modelo Nemotron-3.5, cuyos parámetros activos son de 3B, solo se necesitan leer aproximadamente 1,8GB por token, lo que permite teóricamente alcanzar hasta 41,6 tokens por segundo3.
No obstante, 'leer menos' no es lo mismo que 'almacenar menos'. Aunque disminuya la cantidad de datos leídos, en el momento de cargar el archivo en la RAM se necesita la capacidad de almacenamiento completa. El proceso es finalizado por el asesino de OOM antes de que siquiera pueda leer adecuadamente los datos de un archivo de 76,87GiB. Por lo tanto, llama-modchip tuvo que resolver dos problemas simultáneamente: ① Comprimir el bloque de pesos almacenados en sí mismos a menos de 64GB, y ② Maximizar la velocidad a la que la CPU lee los datos.
Las matemáticas de la compresión que redujo el tamaño de los pesos en 20GiB
Para reducir el tamaño del archivo de 76,87GiB a 56,56GiB, llama-modchip combinó dos técnicas propias de conversión12.
1. Compresión basada en Hessian (SwiGLU-H2)
Los pesos de los expertos de MoE se comprimen mediante un método de 'Hessian analítico de segundo orden'. La matriz Hessian es información diferencial de segundo orden que indica la sensibilidad del modelo a los cambios en la entrada. Según los documentos del proyecto, al analizar mediante descomposición en valores singulares (SVD) la matriz wo_b × wo_a utilizada en el mecanismo de atención, se logró mantener una similitud de coseno del 99,82% con la dirección de salida del original, incluso tras eliminar el 25% del rango total4. Al establecer criterios computacionales que demuestran que los valores eliminados tienen una influencia casi nula en la salida real, se determinaron qué componentes podían descartarse, y basándose en ello, los pesos de los expertos de MoE se comprimieron a nivel IQ1_S.
2. Conversión de formato de tensores (Fractal-64) Los tensores de Multi-head Latent Attention (MLA) se convierten al formato 'Q2_0 basado en código Gray' (promedio de 3,75 bits por peso, bpw)124. Este es un formato dedicado que utiliza un tamaño de bloque de 64 y escalas BF16. Tras este doble proceso, se produce una reducción total de 20,31GiB, el tamaño final del archivo desciende por debajo de 64GB y la carga se vuelve posible.
También se aplicó la técnica de mosaico en cuatro etapas, que aprovecha una jerarquía de memoria de cuatro niveles (registros ZMM → L1D 32KB → L2 1MB → L3 64MB) incluyendo registros ZMM con AVX-512BW, para que los datos comprimidos se procesen rápidamente dentro de la CPU. Esta optimización aumentó la velocidad de prellenado (procesamiento de entrada) para 512 tokens simultáneos de 25,0 a 44,36 tokens por segundo, una mejora de aproximadamente el 77%12.
Percepción de la velocidad de respuesta: ¿Qué representa 9 tokens por segundo?
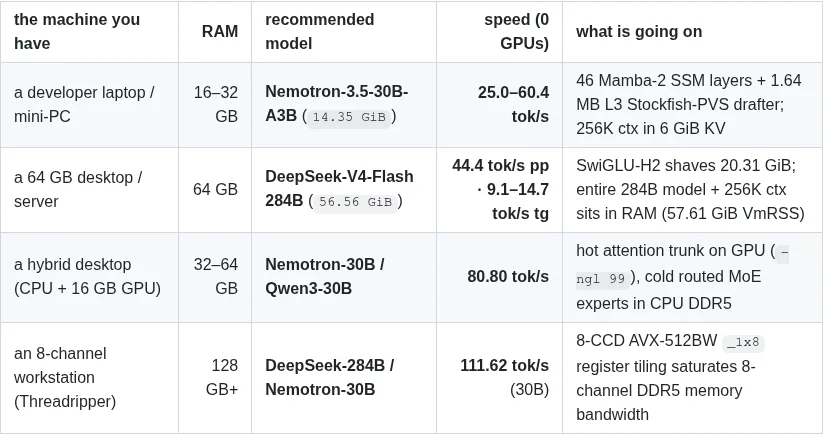
Traducido a una experiencia real de uso, la cifra representa lo siguiente:
- Modo de poda Top-5: 9,68~9,87 tokens puros(llegando hasta 10,15 tokens cuando se combina con Gate-First SwiGLU) Al aplicar la poda L₂ Top-5 en las capas posteriores a la tercera, el indicador de evaluación de calidad simulada, la perplejidad (PPL), aumenta un 0,42%, pero la tasa de coincidencia con el token de mayor ranking se mantiene alta en el 95,8%124.
Como referencia, el modelo Nemotron, con parámetros activos de 3B, registra una velocidad básica de generación de aproximadamente 25 tokens por segundo en la misma CPU, con una media de 48 tokens (máximo 60 tokens) al aplicar decodificación por inferencia, lo que permite una conversación realista en tiempo real1. Un modelo de la categoría DeepSeek-V4-Flash es el resultado de un compromiso entre la 'inteligencia de un modelo grande' y el 'límite de 64GB de RAM'.
Restricciones: Binario dedicado obligatorio y debate sobre la calidad
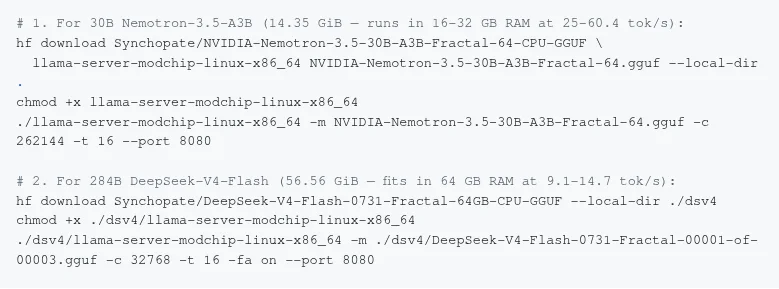
Para utilizar esta tecnología se deben considerar varias restricciones.
- Problemas de compatibilidad: Fractal-64 utiliza un formato de tensor dedicado (ID de tipo 40). Por lo tanto, en los ejecutores estándar sin modificaciones (llama.cpp, Ollama, LM Studio, etc.) se produce un error
unknown tensor type 40y el archivo no puede abrirse. Es obligatorio ejecutarlo con el binario único proporcionado por llama-modchip (Linux x86_64)12. - Debate sobre la calidad: La calidad real en relación con la tasa de compresión (3,75bpw) es motivo de controversia en la comunidad. Algunos señalan que el rendimiento se desploma al cuantizar por debajo de 4 bits (según ciertos artículos), pero otros usuarios reportan que 'en su entorno, DeepSeek con 2 bits fue suficientemente práctico'5. Debe distinguirse entre los valores de divergencia KL (similitud de distribución) o similitud de coseno publicados por el proyecto, que representan la 'proximidad matemática con el original', y la calidad de conversación realmente percibida por el usuario, que no está garantizada por dichos valores45.
Conclusión: El resultado de combinar la estructura MoE y las técnicas de compresión
El caso de llama-modchip demuestra que existe una ruta concreta para ejecutar modelos grandes de la categoría de 284B con 64GB de RAM. La clave radica en el cálculo resultante de la reducción de la lectura por token gracias a la estructura MoE(13,17B, el 4,6% del total) combinada con la compresión de la capacidad de almacenamiento (76,87GiB → 56,56GiB).
Solo cuando se cumplen ambas condiciones (reducción de la lectura por token y compresión de la capacidad de almacenamiento) son posibles simultáneamente la 'carga exitosa' y las 'respuestas de 9~15 tokens por segundo'. Eso sí, esta tecnología requiere un archivo ejecutor dedicado (produce un error de tipo de tensor desconocido 40 en llama.cpp·Ollama·LM Studio sin parches)12, y la calidad varía según la configuración. El modo base Top-6 Lossless registra 9,06~9,95 tokens/s con el archivo comprimido (11,5~14,7 tokens/s con PVS aplicado), manteniendo una divergencia KL de 0 y 'exactitud de bits del 0,00%' en comparación con el archivo original12. En el modo de poda Top-5 la perplejidad aumenta aproximadamente un 0,42%, y en el modo Top-4, con los expertos reducidos a cuatro, el incremento alcanza aproximadamente el 2,85%14. Ante la necesidad de operar una IA gigante sin una tarjeta gráfica, la combinación de modelos MoE y herramientas de optimización puede constituir una alternativa práctica.
Referencias
- Llama-modchip: GPU 없이 64GB RAM에서 284B DeepSeek 실행 | GeekNews · news.hada.io↩
- ↩
- ↩
- ↩
- Llama-modchip: 284B DeepSeek on 64GB RAM, no GPU | Hacker News · news.ycombinator.com↩



