같은 컴퓨터 환경에서 파일 크기 차이만으로 '실행 불가'와 '사용 가능'이 갈리는 상황이 존재합니다. GitHub 사용자 synchopate가 공개한 프로젝트 llama-modchip v2.4.0이 이 경계를 구체적으로 입증했습니다. 총 파라미터 284.33B(약 2,843억 개) 규모의 DeepSeek-V4-Flash 모델을 표준 양자화 파일(76.87GiB) 그대로 AMD Ryzen 9 9955HX + 64GB RAM 환경의 Linux 머신에 올리면, 운영체제는 메모리 부족(OOM, Out of Memory) 오류를 내고 프로세스를 종료합니다.
하지만 이 프로젝트는 같은 모델의 가중치를 56.56GiB로 재조립한 파일을 제공했습니다. 이 파일을 전용 바이너리로 실행하면 상주 메모리(VmRSS) 57.61~58.9GiB 수준에 머무르며, NVMe 스왑 없이도 초당 9~15토큰(AI가 문장을 처리하는 기본 단위로, 단어 또는 단어의 일부에 해당)을 생성합니다12. 약 20GiB의 차이가 로딩 여부를 해결한 것입니다. 아래에서 이 기술이 64GB 램의 물리적 한계를 어떻게 넘었는지, 그리고 일반 사용자가 체감할 수 있는 성능 수준이 어느 정도인지 프로젝트가 공개한 수치를 바탕으로 설명합니다.
MoE 구조가 64GB 램의 벽을 넘긴 물리적 근거
대형 언어 모델(LLM)을 CPU로 실행할 때 병목이 되는 것은 연산 속도가 아니라 메모리 대역폭입니다. CPU가 데이터를 연산하는 시간보다, RAM에서 데이터를 불러오는 시간이 훨씬 오래 걸리기 때문입니다. llama-modchip의 기술 문서(ARCHITECTURE.md)는 이 현상을 구체적인 수치로 설명합니다.
일반적인 '밀집형(dense)' 30B 모델을 Q4_0(4비트급) 양자화로 올리면 토큰 하나를 생성할 때마다 전체 가중치인 약 17GB를 RAM에서 읽어야 합니다. DDR5 듀얼채널의 실사용 읽기 속도가 초당 75GB 수준이므로, 75(대역폭) ÷ 17(데이터량) = 초당 4.4토큰이 물리적 상한이 됩니다. CPU 성능이 아무리 좋아도 이 한계는 넘기 어렵습니다3.
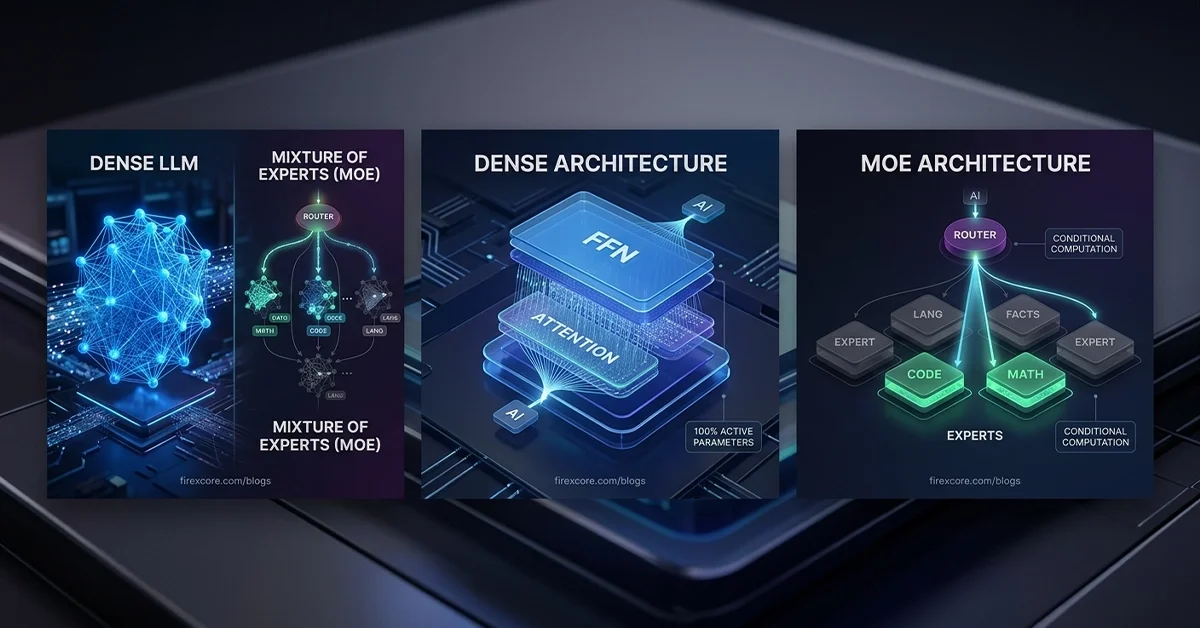
여기서 MoE(Mixture of Experts, 혼합 전문가) 구조가 해답이 됩니다. DeepSeek-V4-Flash는 43개 계층으로 이루어진 MoE 모델인데, 토큰 하나를 처리할 때 전체 전문가 중 6개(라우팅 전문가)와 1개(공유 전문가)만 활성화됩니다. 실제로 읽어드리는 파라미터는 **13.17B(**전체의 4.6%)에 불과합니다4. 읽어야 할 데이터량이 줄면 대역폭 병목도 함께 해소됩니다. 활성 파라미터가 3B인 Nemotron-3.5 모델의 경우 토큰당 약 1.8GB만 읽으면 되므로, 이론상 초당 41.6토큰까지 가능합니다3.
다만 '적게 읽는다'는 것과 '적게 저장한다'는 것은 다릅니다. 읽는 양이 줄어도 파일을 RAM에 올리는 순간에는 전체 저장 용량이 필요합니다. 76.87GiB짜리 파일은 데이터를 제대로 읽기도 전에 OOM 킬러가 프로세스를 종료시킵니다. 따라서 llama-modchip은 두 가지 문제를 동시에 해결해야 했습니다. ① 저장된 가중치 덩어리 자체를 64GB 이하로 압축하기, ② CPU가 데이터를 읽는 속도를 극대화하기.
가중치 크기를 20GiB 줄인 압축 수학
llama-modchip은 파일 크기를 76.87GiB에서 56.56GiB로 줄이기 위해 두 가지 자체 변환 기법을 결합했습니다12.
1. 헤시안 기반 압축 (SwiGLU-H2)
MoE 전문가 가중치를 '해석적 2차 헤시안' 방식으로 압축합니다. 헤시안 행렬은 모델이 입력 변화에 얼마나 민감한지를 나타내는 2차 미분 정보입니다. 프로젝트 문서에 따르면, 주의 기제(Attention)에서 사용하는 행렬 wo_b × wo_a를 특이값분해(SVD)로 분석한 결과, 전체 랭크의 25%를 잘라내도 원본과 출력 방향의 유사성(코사인 유사도)이 **99.82%**로 유지되었습니다4. 잘라낸 수치가 실제 출력에 거의 영향을 주지 않는다는 계산적 근거를 확보해 어떤 성분을 버려도 되는지 가렸고, 이를 바탕으로 MoE 전문가 가중치는 IQ1_S 급으로 압축했습니다.
2. 텐서 형식 변환 (Fractal-64) Multi-head Latent Attention(MLA) 텐서를 '그레이코드 기반 Q2_0' 형식(가중치당 평균 3.75비트, bpw)으로 변환합니다124. 이는 블록 크기 64, BF16 스케일을 사용하는 전용 형식입니다. 이 두 과정을 거치면 총 20.31GiB이 감소하며, 최종 파일 크기가 64GB 이하로 내려와 로딩이 가능해집니다.
압축된 데이터가 CPU 내부에서 빠르게 처리되도록 AVX-512BW ZMM 레지스터를 포함한 4단계 메모리 계층(ZMM 레지스터 → L1D 32KB → L2 1MB → L3 64MB)을 활용하는 4단계 타일링 기술도 적용했습니다. 이 최적화로 512개 토큰을 한 번에 처리하는 프리필(입력 처리) 속도는 초당 25.0토큰에서 44.36토큰으로 약 77% 향상되었습니다12.
응답 속도 체감: 초당 9토큰은 어느 정도인가
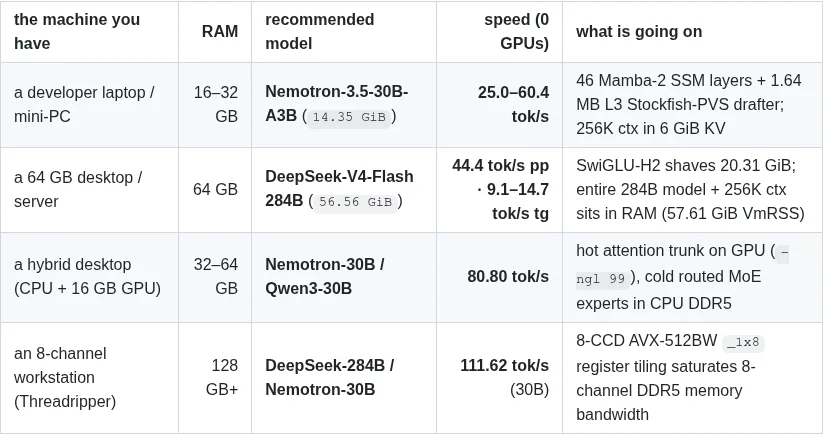
숫자를 실제 사용 경험으로 환산하면 다음과 같습니다.
- **Top-5 가지치기 모드: 순수 9.68~9.87토큰(**Gate-First SwiGLU 병용 시 10.15토큰까지 도달) 세 번째 이후 계층에 Top-5 L₂ 가지치기를 적용하면 모의 품질 평가 지표인 퍼플렉서티(PPL)가 0.42% 증가하지만, 상위 1개 토큰 일치율은 95.8%로 높은 편입니다124.
참고로 활성 파라미터가 3B인 Nemotron 모델은 같은 CPU에서 기본 생성 속도가 초당 약 25토큰, 추측 디코딩 적용 시 평균 48토큰(최대 60토큰)으로 집계되어, 실질적인 실시간 대화가 가능합니다1. DeepSeek-V4-Flash급 모델은 '대형 모델의 지능'과 '64GB 램의 한계' 사이에서 타협한 결과물입니다.
제약 사항: 전용 바이너리 필수와 품질 논쟁
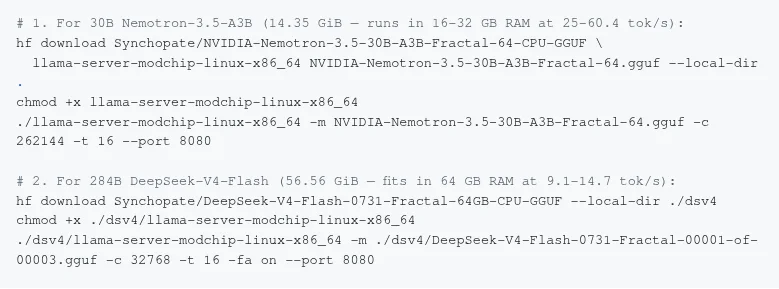
이 기술을 사용하려면 몇 가지 제약 사항을 고려해야 합니다.
- 호환성 문제: Fractal-64는 전용 텐서 형식(타입 ID 40)을 사용합니다. 따라서 수정되지 않은 표준 실행기(llama.cpp, Ollama, LM Studio 등)에서는
unknown tensor type 40오류가 발생하며 파일을 열 수 없습니다. 반드시 llama-modchip이 제공하는 단일 바이너리(Linux x86_64)로 실행해야 합니다12. - 품질 논쟁: 압축률(3.75bpw)에 대한 실제 품질은 커뮤니티에서 논쟁 중입니다. 일부는 4비트 이하 양자화 시 성능이 급격히 저하된다고 지적하지만(특정 논문 기준), 다른 사용자는 "내 환경에서는 2비트 DeepSeek이 충분히 실용적이었다"고 보고합니다5. 프로젝트 측이 공개한 KL 발산(분포 유사도)이나 코사인 유사도 수치가 '원본과의 수학적인 근접성'을 나타내는 반면, 사용자가 체감하는 대화 품질까지 보증하지는 않는다는 점을 구별해야 합니다45.
결론: MoE 구조와 압축 기술의 결합이 만들어낸 결과
llama-modchip의 사례는 284B급 대형 모델을 64GB 램에서 구동할 수 있는 구체적인 경로가 존재함을 보여줍니다. 핵심은 **MoE 구조로 인한 토큰당 읽기량 감소(**13.17B, 전체의 4.6%)와 저장 용량 압축(76.87GiB → 56.56GiB)이 결합된 계산에 있습니다.
이 두 조건(토큰당 읽기량 감소와 저장 용량 압축)이 충족되어야만 '로딩 성공'과 '초당 9~15토큰 응답'이 동시에 가능합니다. 다만 이 기술은 전용 실행 파일을 요구하며(unpatched llama.cpp·Ollama·LM Studio에서는 unknown tensor type 40 오류)12, 품질은 설정에 따라 다릅니다. 기본 Top-6 Lossless 모드는 압축 파일로 9.06~9.95토큰/초(PVS 적용 시 11.5~14.7토큰/초)를 기록하면서도 원본 파일 대비 KL 발산 0·'0.00% Bit-Exact'를 유지하지만12, Top-5 가지치기 모드는 퍼플렉서티가 약 0.42% 증가하고, 전문가를 4개로 줄인 Top-4 모드는 증가 폭이 약 2.85%로 더 큽니다14. '그래픽 카드 없이 거대 AI를 돌려야 하는 상황'이라면, MoE 모델과 최적화 도구의 조합은 실질적인 대안이 될 수 있습니다.
참고자료
- Llama-modchip: GPU 없이 64GB RAM에서 284B DeepSeek 실행 | GeekNews · news.hada.io↩
- ↩
- ↩
- ↩
- Llama-modchip: 284B DeepSeek on 64GB RAM, no GPU | Hacker News · news.ycombinator.com↩