同一のコンピュータ環境において、ファイルサイズの差だけで「実行不能」と「使用可能」が分かれるケースが存在します。GitHubユーザー synchopateが公開したプロジェクト llama-modchip v2.4.0は、この境界を具体的に実証しました。総パラメータ284.33B(約2,843億個)規模の DeepSeek-V4-Flash モデルを、標準的な量子化ファイル(76.87GiB)のまま AMD Ryzen 9 9955HX + 64GB RAM 環境の Linux マシンに読み込ませると、オペレーティングシステムはメモリ不足(OOM、Out of Memory)エラーを発生させ、プロセスを終了させます。
しかし、このプロジェクトは同じモデルの重みを56.56GiBに再構成したファイルを提供しました。このファイルを専用バイナリで実行すると、常駐メモリ(VmRSS)は57.61〜58.9GiBレベルに留まり、NVMeスワップなしで1秒あたり9〜15トークン(AIが文を処理する基本単位であり、単語または単語の一部に相当)を生成します12。約20GiBの差が、読み込み可否の問題を解決したのです。以下では、この技術がどのように64GB RAMの物理的な限界を乗り越えたのか、そして一般ユーザーが体感できる性能レベルはどの程度なのかについて、プロジェクトが公開した数値に基づいて解説します。
MoE構造が64GB RAMの壁を越えた物理的な根拠
大規模言語モデル(LLM)をCPUで実行する場合、ボトルネックとなるのは演算速度ではなくメモリ帯域幅です。CPUがデータを演算する時間よりも、RAMからデータを読み出す時間の方がはるかに長くかかるためです。llama-modchipの技術ドキュメント(ARCHITECTURE.md)は、この現象を具体的な数値で説明しています。
一般的な「密(dense)」型の30BモデルをQ4_0(4ビット級)量子化で読み込むと、トークンを1つ生成するごとに、約17GBの全重みデータをRAMから読み出す必要があります。DDR5デュアルチャネルの実効読み取り速度が1秒あたり75GB程度であるため、75(帯域幅) ÷ 17(データ量) = 1秒あたり4.4トークンが物理的な上限となります。CPU性能がいくら向上しても、この限界を超えることは困難です3。
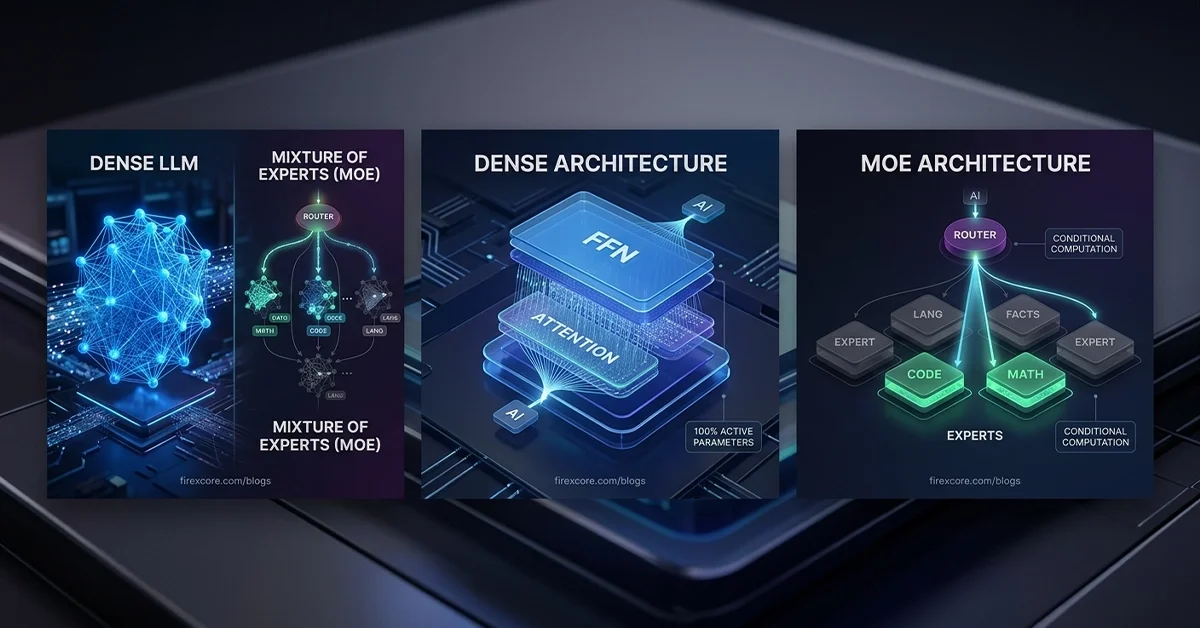
ここでMoE(Mixture of Experts、混合専門家)構造が解決策となります。DeepSeek-V4-Flashは43階層で構成されたMoEモデルであり、トークンを1つ処理する際、全体の専門家の中から6個(ルーティング専門家)と1個(共有専門家)のみが有効化されます。実際に読み出されるパラメータは13.17B(全体の4.6%)に過ぎません4。読み出すデータ量が減少すれば、帯域幅のボトルネックも同時に解消されます。アクティブパラメータが3BであるNemotron-3.5モデルの場合、トークンあたり約1.8GBのみを読み出せばよいため、理論上は1秒あたり41.6トークンまで可能となります3。
ただし、「少なく読み出すこと」と「少なく保存すること」は異なります。読み出し量が減少しても、ファイルをRAMに読み込む時点では、全体の保存容量が必要となります。76.87GiBのファイルでは、データを正しく読み出す前にOOMキラーがプロセスを終了させてしまいます。したがって、llama-modchipは次の2つの問題を同時に解決する必要がありました。① 保存された重みデータ自体を64GB以下に圧縮すること、② CPUがデータを読み出す速度を最大化すること。
重みサイズを20GiB削減した圧縮数学
llama-modchipは、ファイルサイズを76.87GiBから56.56GiBへ削減するために、2つの独自変換手法を組み合わせました12。
1. ヘシアンベースの圧縮(SwiGLU-H2)
MoE専門家の重みを「解析的な2次ヘシアン」方式で圧縮します。ヘシアン行列は、モデルが入力の変化に対してどれだけ敏感であるかを示す2次微分情報です。プロジェクトのドキュメントによると、注意機構(Attention)で使用される行列 wo_b × wo_a を固有値分解(SVD)で分析した結果、全体のランクの25%を削除しても、出力方向との類似性(コサイン類似度)は99.82% 維持されました4。削除した数値が実際の出力にほとんど影響を与えないという計算上の根拠を確保することで、どの成分を破棄してもよいかを判断し、これを基にMoE専門家の重みをIQ1_S級に圧縮しました。
2. テンソル形式変換(Fractal-64) Multi-head Latent Attention(MLA)テンソルを「グレイコードベースのQ2_0形式」(重みあたり平均3.75ビット、bpw)に変換します124。これはブロックサイズ64、BF16スケールを使用する専用形式です。これら2つの工程を経ることで、合計20.31GiBが削減され、最終的なファイルサイズは64GB以下に収まり、読み込みが可能となります。
圧縮されたデータがCPU内部で高速に処理されるよう、AVX-512BW ZMMレジスタを含む4段階のメモリ階層(ZMMレジスタ → L1D 32KB → L2 1MB → L3 64MB)を活用する4段階タイル化技術も適用しました。この最適化により、512トークンを一括して処理するプリフィル(入力処理)速度は、1秒あたり25.0トークンから44.36トークンへと約77%向上しました12。
応答速度の体感:1秒あたり9トークンとはどの程度か
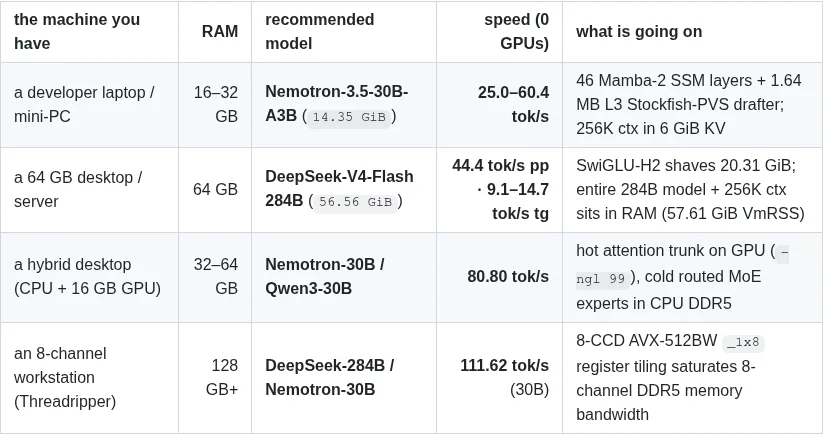
数値を実際の使用経験に換算すると、以下のようになります。
- Top-5 プルーニングモード:純粋に9.68〜9.87トークン(Gate-First SwiGLU併用時は最大10.15トークンまで到達)。第3層以降にTop-5 L₂プルーニングを適用すると、模擬品質評価指標であるパープレキシティ(PPL)が0.42%増加しますが、上位1トークンの一致率は95.8%と比較的高い水準です124。
参考までに、アクティブパラメータが3BであるNemotronモデルは、同じCPUにおいて基本生成速度が1秒あたり約25トークン、推測デコーディング適用時は平均48トークン(最大60トークン)と集計されており、実質的なリアルタイム対話が可能となっています1。DeepSeek-V4-Flash級のモデルは、「大規模モデルの知能」と「64GB RAMの限界」との間で妥協した結果と言えます。
制約事項:専用バイナリの必須性と品質に関する議論
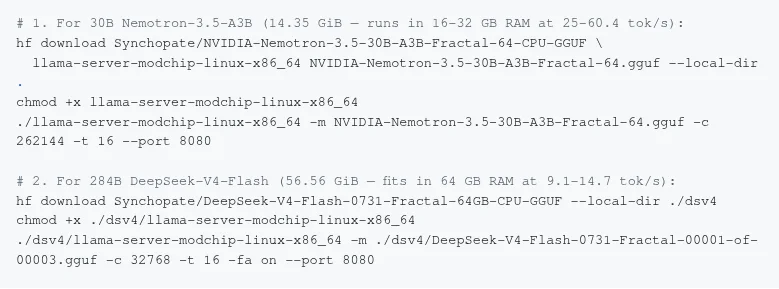
この技術を使用するには、いくつかの制約事項を考慮する必要があります。
- 互換性の問題:Fractal-64は専用テンソル形式(タイプID 40)を使用します。そのため、修正されていない標準的なランタイム(llama.cpp、Ollama、LM Studioなど)では、
unknown tensor type 40エラーが発生し、ファイルを開くことができません。必ず llama-modchip が提供する単一バイナリ(Linux x86_64)で実行する必要があります12。 - 品質に関する議論:圧縮率(3.75bpw)に対する実際の品質は、コミュニティ内で議論が続いています。一部からは、4ビット以下の量子化では性能が急激に低下するとの指摘がありますが(特定論文の基準)、他のユーザーからは「自分の環境では、2ビットのDeepSeekも十分に実用的だった」と報告されています5。プロジェクト側が公開しているKLダイバージェンス(分布の類似度)やコサイン類似度の数値は、「元データとの数学的な近接性」を示している一方で、ユーザーが体感する対話品質までは保証しない点に留意する必要があります45。
結論:MoE構造と圧縮技術の組み合わせが生み出した結果
llama-modchipの事例は、284B級の大規模モデルを64GB RAMで動作させる具体的な経路が存在することを示しています。その核心は、**MoE構造によるトークンあたりの読み出し量削減(13.17B、全体の4.6%)と保存容量の圧縮(76.87GiB → 56.56GiB)**が組み合わさった計算にあります。
これらの2つの条件(トークンあたりの読み出し量削減と保存容量の圧縮)が満たされて初めて、「読み込みの成功」と「1秒あたり9〜15トークンの応答」が同時に可能となります。ただし、この技術は専用実行ファイルを必要とし(unpatched llama.cpp・Ollama・LM Studio では unknown tensor type 40 エラーが発生する)12、品質は設定により異なります。デフォルトのTop-6 Losslessモードでは、圧縮ファイルで9.06〜9.95トークン/秒(PVS適用時は11.5〜14.7トークン/秒)を記録しつつ、元ファイルとの比較でKLダイバージェンス 0・「0.00% Bit-Exact」を維持していますが12、Top-5プルーニングモードではパープレキシティが約0.42%増加し、専門家の数を4に削減したTop-4モードでは増加幅が約2.85%とさらに大きくなります14。「GPUなしで巨大AIを稼働させる必要がある状況」であれば、MoEモデルと最適化ツールの組み合わせは、現実的な代替手段となり得ます。
参考文献
- Llama-modchip: GPU 없이 64GB RAM에서 284B DeepSeek 실행 | GeekNews · news.hada.io↩
- ↩
- ↩
- ↩
- Llama-modchip: 284B DeepSeek on 64GB RAM, no GPU | Hacker News · news.ycombinator.com↩



