只需输入一行提示词,便能在60至120秒内生成时长5至10秒的视频片段。用户仅需输入文本,AI便能自动创作视频,因此无需复杂的剪辑技巧或昂贵的设备,任何人都可以尝试制作短片动画。然而,以动画为目标时,关键在于选择“哪种工具”。大多数AI视频模型默认倾向于生成逼真的照片级视频,因此难以保留手绘般的“绘画质感”。
AI视频生成:从文本到画面的演变过程
将文本转换为视频的AI采用一种称为“扩散(Diffusion)”的过程。最初,整个画面充满了随机噪声,随后AI根据输入的文本描述逐步去除并细化这些噪声,从而生成完整的帧1。
在此过程中,AI首先生成多帧图像,随后确保前后帧之间物体的形态与动作连贯流畅,实现自然衔接。这被称为强制施加“时间一致性”。最后,AI将画面提升至1080p等高分辨率,使其更加清晰,并生成时长为5至10秒的视频文件1。
其特点是无需用户具备额外的视频剪辑知识。唯一的“技术”在于在提示词中具体明确场景的主体(人物或物体)、动作(行为)、视觉氛围(风格)、视角(相机)以及时间(光线)。描述越具体,预期的结果越接近目标。例如,相较于“行走的女性”,描述为“黄金时刻,在碎石路上穿过落叶行走的红衣女性,跟踪镜头”能带来更佳的效果1。
动画为何对AI而言困难:丢失线条的模型
即便随意选择一款AI视频工具,也未必能生成相同的动画效果。动画是AI最难处理的风格之一。根据OpenArt团队在2026年针对动画特性对主流视频生成工具进行的测试结果,大多数模型本能地追求写实渲染(Photoreal),从而丢失了“绘画质感”2。
真实的动画以清晰的轮廓线和扁平的填色为特征。然而,AI视频模型倾向于默认生成光线在表面反射的写实照明以及3D质感。其结果是,仅输入文本便会使画面呈现出类似“3D Cosplay”或游戏过场动画的光滑感,而手绘般的平面感则荡然无存2。因此,在制作动画时,必须明确区分并选择那些能始终维持“绘画质感”的模型,以及那些虽然动作表现良好但风格容易崩塌的模型。
结果随模型而异:保持线条与色彩的选择方案
当通过输入具体的提示词来生成时长5至10秒的短片时,选择不同的引擎会使动画作品的风格截然不同。
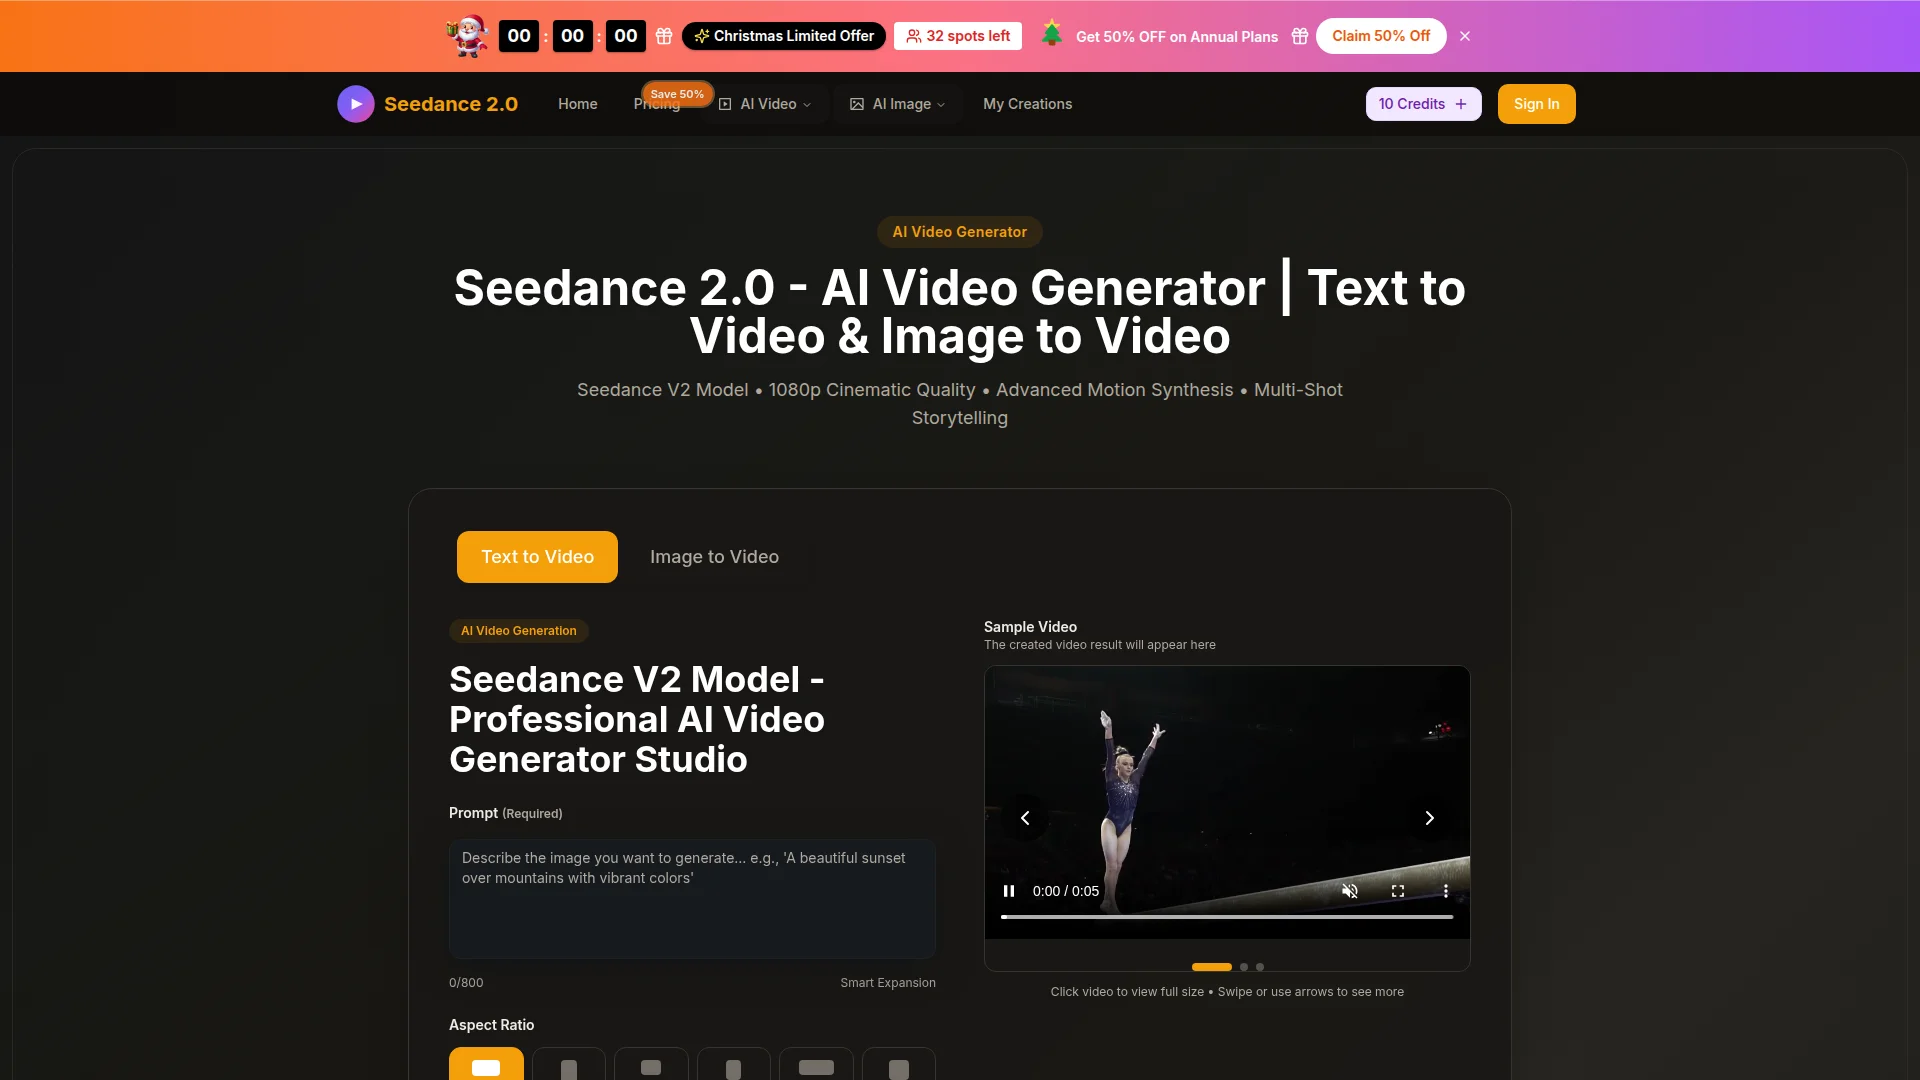
如果希望呈现线条清晰、填色扁平的“原画质感”,Wan模型是实用的选择。这款由阿里巴巴开发的模型(开源)被誉为在角色运动过程中也能最稳定地维持轮廓线和扁平填色2, 3。在如Seedance平台这样可以在同一界面中选择多种AI模型的环境中选用Wan,适合用于制作以静态对话或氛围为主的短片,有望获得理想的风格。
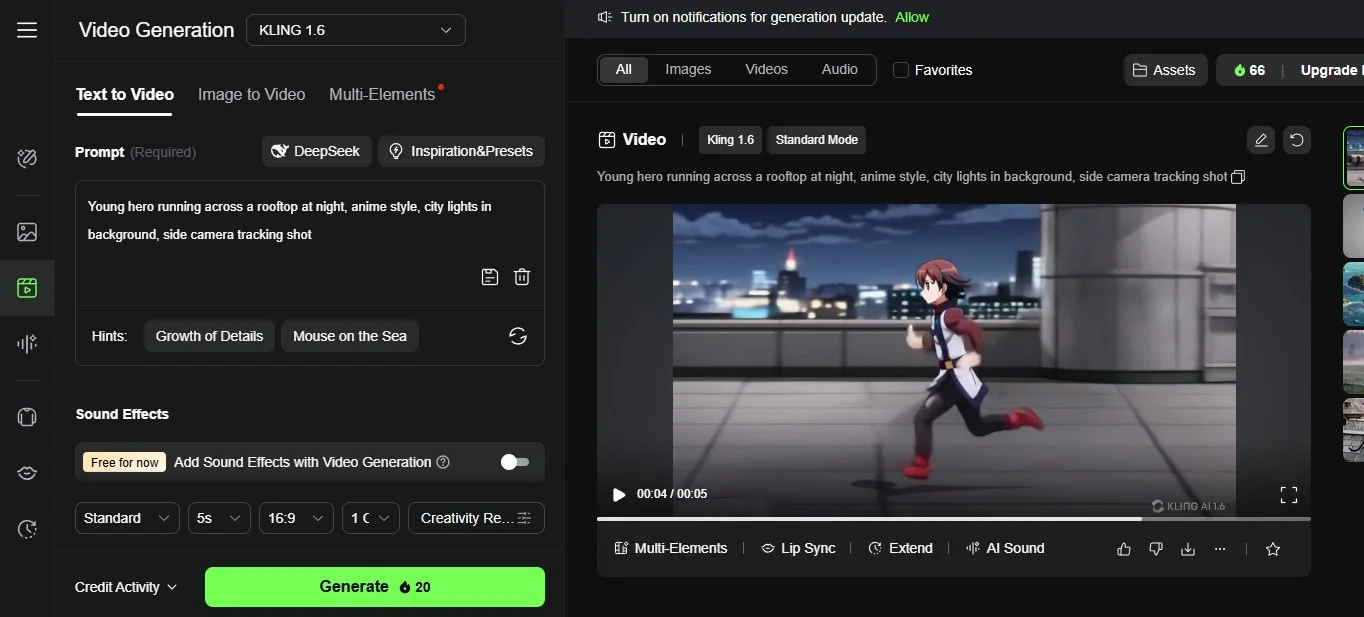
反之,如果重点在于激烈的动作场景,则可以选择Kling。在OpenArt的测试中,Kling在遵循物理规律的同时,能够最流畅地实现动态镜头运动以及动画特有的“冲击帧”(画面仿佛定格般的强调效果)2。尽管其在动作表现方面的优势得到认可,但其平面化风格的维持程度可能不如Wan。
如果需要快速生成并包含音频,Seedance是合适的选择;如果专注于快速实验,则可以使用Pika。字节跳动的Seedance擅长批量生成短片,并在视频生成时同步生成原生音频(如伴随视频产生的音效、音乐等)2。Pika等工具适合在短时间内添加华丽的变形效果以进行快速实验,但在精细动画风格的维持方面存在局限性1, 2。
| 类别 | 特点及推荐用途 |
|---|---|
| Wan 2.7 | 在运动中最能维持线条(线稿)和扁平填色。适用于优先考虑风格维持的场景2, 3 |
| Kling | 擅长动态动作及符合物理规律的流畅运动。有利于战斗场景等2 |
| Seedance | 特点是生成速度快且可同步生成原生音频。有利于社交媒体短片的大批量生产2 |
通过免费积分访问的方式也因工具而异。Seedance平台即使对免费用户也支持每日3至5个视频生成积分、1080p画质以及无水印输出1。相比之下,Pika每月仅提供约10个积分,Runway在注册时仅一次性赠送125积分,因此在反复测试和动画生成方面存在限制1。
制作复杂动画时需知晓的“一致性”壁垒
利用免费积分仅通过文本生成5秒短片的工作现在即可开始。然而,当需要将多个场景拼接成故事,而非处理单一场景时,“角色一致性”问题便会浮现。
许多AI视频模型会对每个场景进行概率性重新生成4。即使提示词中写道“短发、身穿棕色夹克的女性”,AI也会每次都即兴解读并绘制符合该类别的全新人物或服装。因此,第一场景中的角色与第二场景中的角色在面部轮廓、服装细节描绘或身体比例上会出现差异4。
为解决这一问题,开发者建议采用“图生视频”(Image-to-Video)工作流程,即先生成静帧图像(静止画面),再将其转换为视频。相比于直接将文本转换为视频,先确定静帧图像再赋予其动作,能更有效地防止风格崩塌3。此外,最新的工具允许输入多张参考图像,使同一人物在不同画面中重复出现。例如,Seedance在生成单个画面时,可同时输入最多9张参考图像以及视频和音频文件,从而确保角色一致性3。
如果希望立即尝试制作动画,建议访问仅通过输入提示词即可生成视频的平台,选择Wan模型,输入明确指定主题、动作、风格、相机和光线的语句,然后选择9:16比例进行生成。仅通过两三次的快速迭代,即可确认“绘画质感”恢复的程度。不过,若需将作品扩展为系列,应当意识到除了文本输入外,还需提前指定角色图像。
参考资料
- 텍스트 투 비디오 AI 무료: 텍스트로 동영상 만드는 완벽 가이드 · seedance.tv↩
- ↩
- ↩
- ↩



