프롬프트 한 줄을 입력하면 60~120초 안에 5~10초 분량의 영상 클립이 나오는 시대입니다. 텍스트만 입력하면 AI가 영상을 만들어주므로 복잡한 편집 기술이나 비싼 장비 없이도 누구나 짧은 애니메이션을 시도할 수 있습니다. 다만 애니메이션을 목표로 할 때 중요한 것은 ‘어떤 도구’를 쓰느냐입니다. 대부분의 AI 영상 모델은 사진처럼 리얼한 영상을 선호하는 기본 성향이 있어, 손으로 그린 듯한 ‘그려진 느낌’을 유지하기 어렵기 때문입니다.
AI 영상 생성, 텍스트가 화면으로 변하는 과정
텍스트를 영상으로 바꾸는 AI는 ‘확산(Diffusion)’이라는 과정을 사용합니다. 처음에는 화면 전체가 무작위 잡음(노이즈)으로 가득 차 있다가, AI가 입력된 텍스트 설명에 맞춰 이를 조금씩 지우고 다듬어 완성된 프레임을 만들어내는 방식입니다 1.
이 과정에서 AI는 여러 장의 프레임을 만든 뒤, 앞뒤 프레임이 자연스럽게 이어지도록 물체의 형태와 움직임이 끊기지 않게 연결합니다. 이를 ‘시간적 일관성’을 강제한다고 표현합니다. 최종적으로 화면을 1080p 같은 고해상도로 선명하게 끌어올려 5~10초 분량의 영상 파일을 생성합니다 1.
사용자가 별도의 영상 편집 지식을 요구하지 않는 것이 특징입니다. 프롬프트에는 장면의 인물이나 사물(주제), 행동(동작), 시각적 분위기(스타일), 시점(카메라)과 시간대(조명)를 구체적으로 명시하는 것이 유일한 ‘기술’입니다. “걷는 여성”보다 “황금 시간에 자갈길에서 낙엽 사이를 걷는 빨간 코트의 여성, 추적 샷”처럼 구체적으로 쓸수록 기대한 결과물이 나옵니다 1.
애니메이션이 AI에게 어려운 이유: 선을 잃어버리는 모델들
AI 영상 도구를 아무거나 선택해서 써도 똑같은 애니메이션이 나오지는 않습니다. 애니메이션은 AI가 가장 다루기 까다로운 스타일 중 하나입니다. OpenArt 팀이 2026년 주요 영상 생성 도구들을 애니메이션 특성에 맞춰 테스트한 결과, 대부분의 모델이 본능적으로 사실적인 렌더링(Photoreal)을 추구하여 ‘그려진 느낌’을 잃어버린다는 사실이 확인되었습니다 2.
실제 애니메이션은 선명한 윤곽선과 평평한 채색을 특징으로 합니다. 하지만 AI 영상 모델은 빛이 표면에 반사되는 사실적인 조명과 3D 질감을 기본값으로 생성하는 경향이 강합니다. 그 결과 텍스트만 입력하면 화면이 ‘3D 코스프레’나 게임 컷신처럼 매끄러워져 버리고, 손으로 그린 듯한 평면적인 느낌은 사라집니다 2. 따라서 애니메이션을 만들려 할 때는 이 ‘그려진 느낌’을 끝까지 유지하는 모델과, 움직임은 좋지만 스타일이 무너져 버리는 모델을 명확히 구분해서 선택해야 합니다.
모델에 따라 달라지는 결과물: 선과 색을 유지하는 선택지
구체적인 프롬프트를 입력해 5~10초의 짧은 클립을 뽑아낼 때, 어떤 엔진을 고르느냐에 따라 애니메이션 결과물의 성격이 완전히 달라집니다.
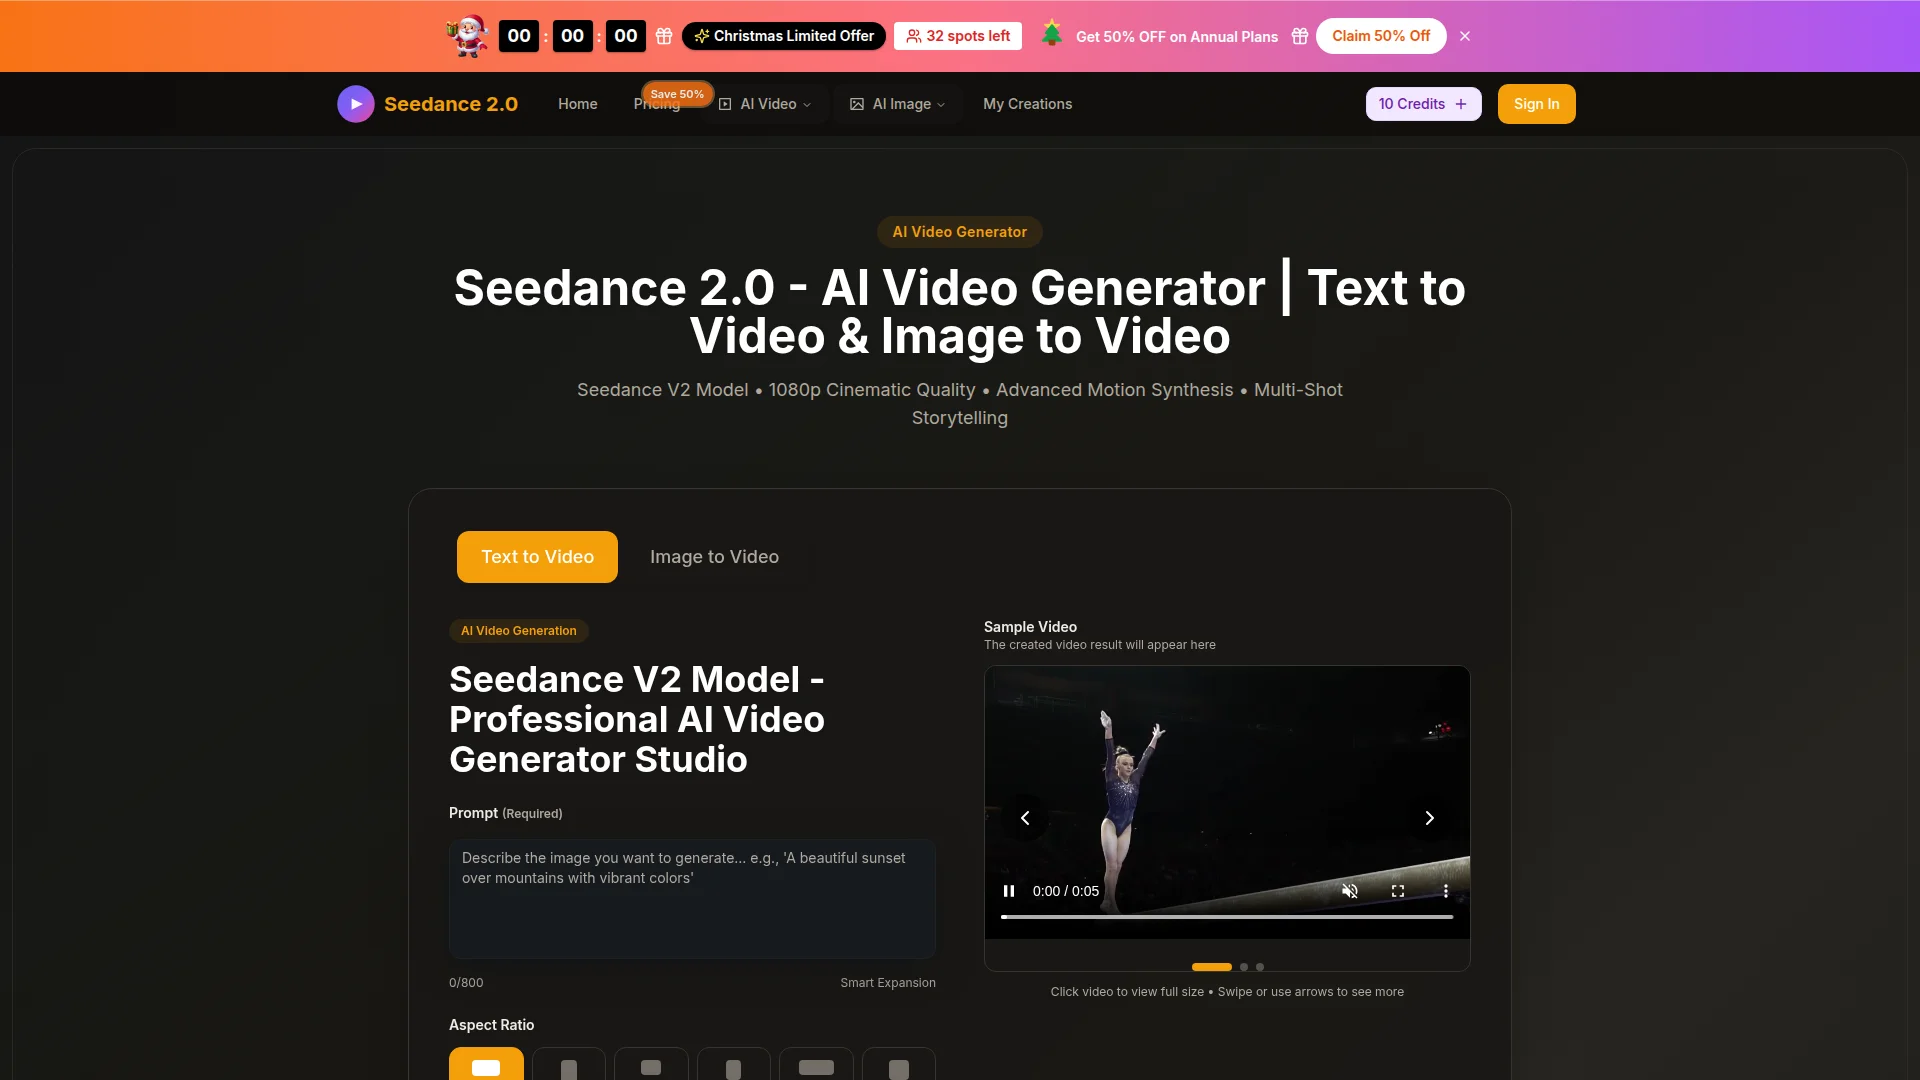
선이 뚜렷하고 채색이 평평한 ‘원화의 느낌’을 원한다면 Wan 모델이 유용합니다. Alibaba가 개발한 이 모델(오픈소스)은 캐릭터가 움직이는 와중에도 윤곽선과 평평한 채색을 가장 안정적으로 유지한다고 평가받습니다 2, 3. Seedance 플랫폼처럼 여러 AI 모델을 하나의 화면에서 고를 수 있는 곳에서 Wan을 선택하여, 정적인 대화나 분위기 위주의 짧은 클립을 만들 때 좋은 스타일을 기대할 수 있습니다.
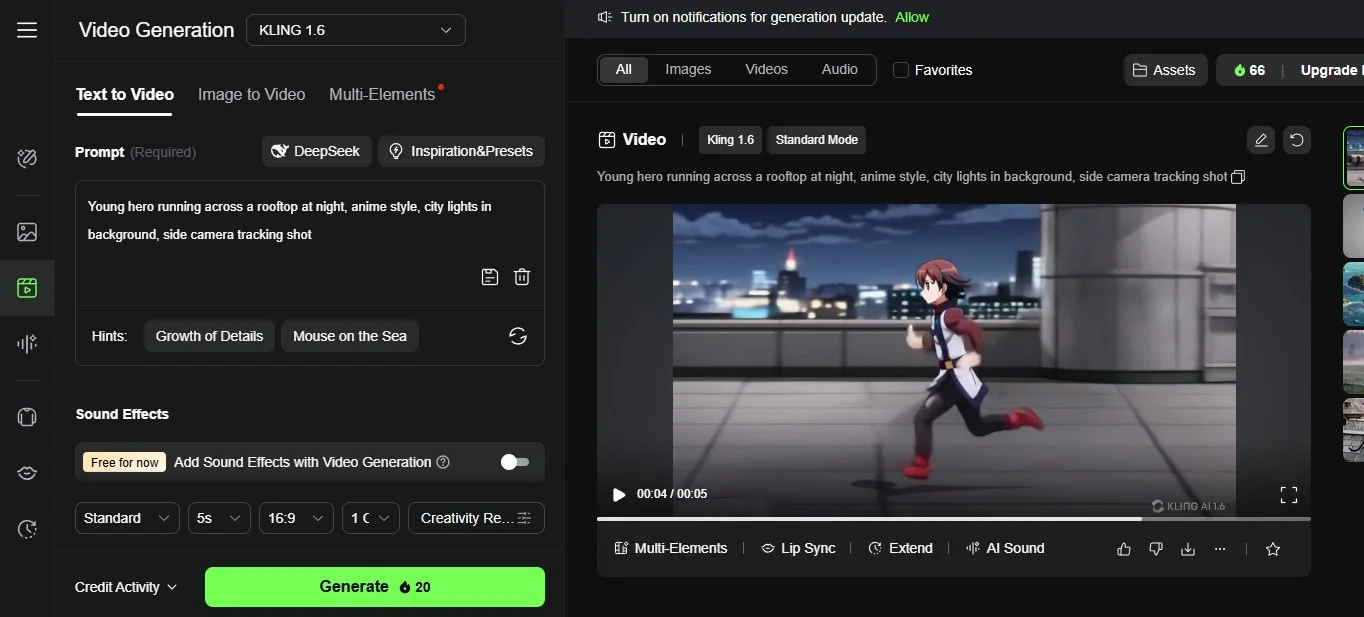
반대로 격렬한 움직임이 중요한 짧은 액션 장면이라면 Kling을 고를 수 있습니다. OpenArt의 테스트에서 Kling은 물리 법칙을 따르면서도 역동적인 카메라 움직임과 애니메이션 특유의 ‘임팩트 프레임(화면이 멈추듯 강조되는 효과)’을 가장 매끄럽게 구현해 냈습니다 2. 움직임에 대한 강점은 인정받지만, Wan만큼 스타일이 평면적으로 유지되지는 않을 수 있습니다.
빠른 속도와 소리를 함께 원한다면 Seedance가 적합하고, 빠른 실험에 집중한다면 Pika를 쓸 수 있습니다. ByteDance의 Seedance는 짧은 클립을 대량으로 뽑아내는 데 유리하고, 영상 생성 시 네이티브 오디오(영상과 함께 생성되는 효과음·음악 등)를 함께 만들어냅니다 2. Pika 같은 도구는 짧은 시간에 화려한 변형 효과를 넣어 빠른 실험을 하기에 적합하지만, 정교한 애니메이션 스타일 유지에는 한계가 있습니다 1, 2.
| 구분 | 특징 및 추천 용도 |
|---|---|
| Wan 2.7 | 선(선화)과 평평한 채색을 움직여도 가장 잘 유지함. 스타일 유지가 우선인 장면 2, 3 |
| Kling | 역동적인 액션, 물리 법칙을 따르는 부드러운 움직임에 강함. 전투 장면 등에 유리 2 |
| Seedance | 빠른 생성 속도와 영상과 함께 나오는 네이티브 오디오 생성이 특징. SNS용 짧은 클립 대량 생산에 유리 2 |
무료 크레딧으로 접근하는 방식도 도구에 따라 다릅니다. Seedance 플랫폼은 무료 사용자에게도 매일 3~5개의 영상 생성 크레딧과 1080p 화질, 워터마크 없는 출력을 지원합니다 1. 반면 Pika는 월 약 10개, Runway는 가입 시 125 크레딧만 일회성으로 주어 반복적인 테스트 및 애니메이션 생성에는 제약이 있습니다 1.
복잡한 애니메이션을 원할 때 알아야 할 ‘일관성’의 장벽
무료 크레딧을 활용해 텍스트만으로 5초짜리 클립을 뽑아내는 일은 지금 바로 시작할 수 있습니다. 하지만 하나의 장면이 아니라 여러 장면을 이어붙여 이야기를 만들어야 할 때면 ‘캐릭터 일관성’ 문제가 나타납니다.
많은 AI 영상 모델은 각 장면을 확률적으로 새로 만들어냅니다 4. 프롬프트에 “짧은 검은머리에 갈색 재킷을 입은 여성”이라고 적어도 AI는 이 범주에 해당하는 새로운 인물이나 옷을 매번 즉석에서 해석해서 그립니다. 따라서 첫 번째 장면의 캐릭터와 두 번째 장면의 캐릭터가 얼굴 윤곽이나 옷의 세부 묘사, 몸 비례가 달라지는 현상이 나타납니다 4.
이 문제를 해결하기 위해 개발자들은 스틸 이미지(정지된 그림)를 먼저 만들어 영상으로 변환하는 ‘Image-to-Video’ 워크플로우를 권고합니다. 텍스트를 영상으로 한 번에 바꾸는 것보다 정지된 그림을 먼저 확정 짓고 여기에 움직임을 입히면, 스타일이 무너지는 것을 훨씬 잘 막을 수 있습니다 3. 또한 최신 도구들은 여러 장의 참조 이미지를 입력받아 한 인물을 여러 화면에서 반복해서 사용하게 해 줍니다. 예를 들어 Seedance는 한 화면 생성 시 참조 이미지 최대 9장과 영상, 소리 파일을 함께 넣어 캐릭터 일관성을 확보할 수 있습니다 3.
지금 당장 애니메이션을 만들어 보고 싶다면, 프롬프트 입력만으로 영상을 생성하는 플랫폼에 접속해 Wan을 고르고, 주제·동작·스타일·카메라·조명을 명시한 문장을 입력한 뒤 9:16 비율로 생성을 눌러보기를 권합니다. 두세 번의 빠른 반복만으로도 ‘그려진 느낌’이 얼마나 살아나는지 확인할 수 있습니다. 다만 결과물을 시리즈로 확장해야 한다면, 텍스트 입력을 넘어 캐릭터 이미지를 미리 지정하는 단계가 필요하다는 점은 염두에 두어야 합니다.
참고자료
- 텍스트 투 비디오 AI 무료: 텍스트로 동영상 만드는 완벽 가이드 · seedance.tv↩
- ↩
- ↩
- ↩