在输入问题后,您或许经历过这样的场景:画面停滞三十至六十秒,随后突然以正常速度逐字输出回答。这并非人工智能深度思考所需的时间,而是等待数据到达所造成的“瓶颈”现象。Betelgeuse 项目开发者公布的一个案例揭示了这一沉默的真相:GPU 运算单元处于闲置状态,正在等待通过 PCIe 总线逐一加载存储在磁盘上的专家权重。通过仅调整数据加载顺序与加载单位这三项修改,开发者在未更换任何硬件的情况下将预热状态下的提示词处理速度从每秒三至六 token 提升至每秒六十点八零 token。1
首字延迟三十至六十秒的原因
在低配 PC 上运行超大型 AI 模型时,往往存在明显的答案延迟阶段。问题并不出现在 AI 逐字输出答案的解码阶段,而是出现在先处理全部输入提问并将其载入内存的预填充阶段。预填充是指并行处理提示词中的全部 token 以构建 KV 缓存,并计算第一个回复字的过程,该过程需要充足的 GPU 运算资源方可快速完成。业界通常使用首 token 生成时间来衡量这一延迟。23
Betelgeuse 部署的 DeepSeek V4.1 Flash 模型拥有七千四百八十亿参数,包含四十个层级以及 Engram 表,总规模达四百一十六 GB。由于十二 GB 显存与十六 GB 内存无法容纳全部模型,绝大部分权重必须存储于 NVMe SSD 中,并仅将必要部分通过 PCIe 总线载入。在标准方式下,每处理一个问题都需要调用四十个层级中的几乎所有专家,导致 GPU 在传输等待期间无法进行任何计算。由此导致五百 token 提问的预填充速度仅为一至三 token/s。1
让 GPU 保持忙碌的三项修改
Betelgeuse 开发者没有采用模型裁剪或权重重量化策略,而是改变了数据搬运方式。这一基于 llama.cpp 的实验性分支保留了全部路由专家的原始精度。
第一,位置不变缓存分区。每个层级固定设置二十个常驻槽位,其中五个分配至显存热区,另外十五个分配至主机内存区。核心在于不改变路由路径:排名第一的专家在二十个完整槽位中评估,而第二至五名的专家仅在常驻池内评估。这样即可确保模型选择路径不受缓存状态影响,从而保证结果一致性。此外,Engram 表仅在层级一与层级十四激活,每 token 仅占用约一百九十二 KB 内存,借此特性直接将其载入二 MB 显存缓冲区,几乎不占用主机内存。14
第二,单遍层级优先预填充。若沿用传统三 token 微型批次处理提示词,GPU 张量核心占用率将偏低。开发者改为十六 token 单位一次性处理,并将主机内存中的专家经 PCIe 载入的过程与 GPU 计算重叠执行。通过实现数据移动与计算并行,可显著降低 GPU 等待时间。
第三,遍历结束时的显存提升。首轮遍历结束后,系统将实际高频使用的五个专家物理迁移至显存热槽。由于逻辑路由未变,从后续遍历开始即可在不产生 PCIe 传输开销的情况下直接进行计算。
相同硬件下由每秒六点八三 token 提升至每秒六十点八零 token
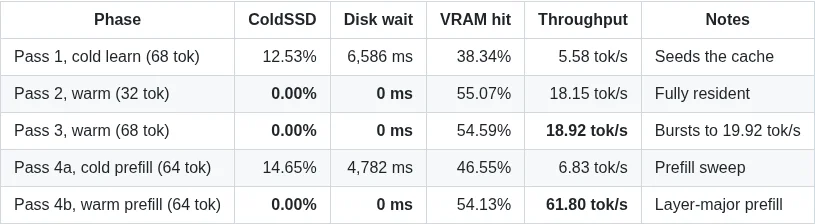
三项更改的效果可从两个数值中得到验证。首先,开发者报告称,在标准实现中预热状态下的提示词处理速度已由每秒三至六 token 提升至每秒六十点八零 token。此外,在相同 PC 上以六十四 token 的提示词反复执行优化后的引擎时,缓存为空的初始遍历与专家完全常驻之后的遍历之间存在明显差异。测试环境为 RTX 3060 十二 GB、十六 GB 单通道 DDR4-3200、PCIe 4.0 NVMe SSD,并禁用交换空间将内存使用量限制在十二 GiB。14
| 遍历 | 状态 | 预填充速度 | 磁盘读取 | 磁盘等待 |
|---|---|---|---|---|
| 4a | 冷启动 | 6.83 tok/s | 14.65% | 4,782 ms |
| 4b | 预热 | 61.80 tok/s | 0.00% | 0 ms |
上述两项数据来自 Betelgeuse GitHub 文档中的结果表。4
开发者表示,在缓存已预热的状态下,标准提示词的首 token 等待时间已基本消失。此过程中解码速度保持为每秒十八点一五至十八点九二 token,显存峰值使用量为十一千三百九十六 MiB,运行在十二 GiB 限额内。14
改进原因与适用范围
开发者指出,预填充性能的提升并非源于模型参数减少,而是来自对 PCIe 传输单位、批次方式以及缓存策略的调整所实现的 I/O 与调度优化。这说明,即使在低配 PC 上,只要具备足够的磁盘容量与 PCIe 带宽,超大型 MoE 模型也能以实用速度运行。不过,作者同时提到,若将单通道 DDR4 更换为双通道配置,预填充速度有可能翻倍,但这仅为估算值,尚未得到验证。
与同样使用 RTX 3060 十二 GB 的其他项目相比,该实验的预填充速度较低,但解码速度更高。由于两项实验在模型选择、量化方案、提示词长度及系统内存配置等方面均不相同,因此不能视作纯粹基于硬件的性能比较。14
最终,这一案例表明,与“模型太大导致运行缓慢”的普遍认知不同,MoE 模型首个答案的延迟源于专家加载顺序与加载单位与 PCIe 带宽不匹配。只要根据硬件特性调整数据加载策略,即便依靠十二 GB 显存与十六 GB 内存,也能有效消除七千四百八十亿参数模型的初始沉默延迟。但需强调,该结论来自单一 GPU 与存储配置下的实验性验证结果,无法自动推广至其他环境并保证获得相同指标。