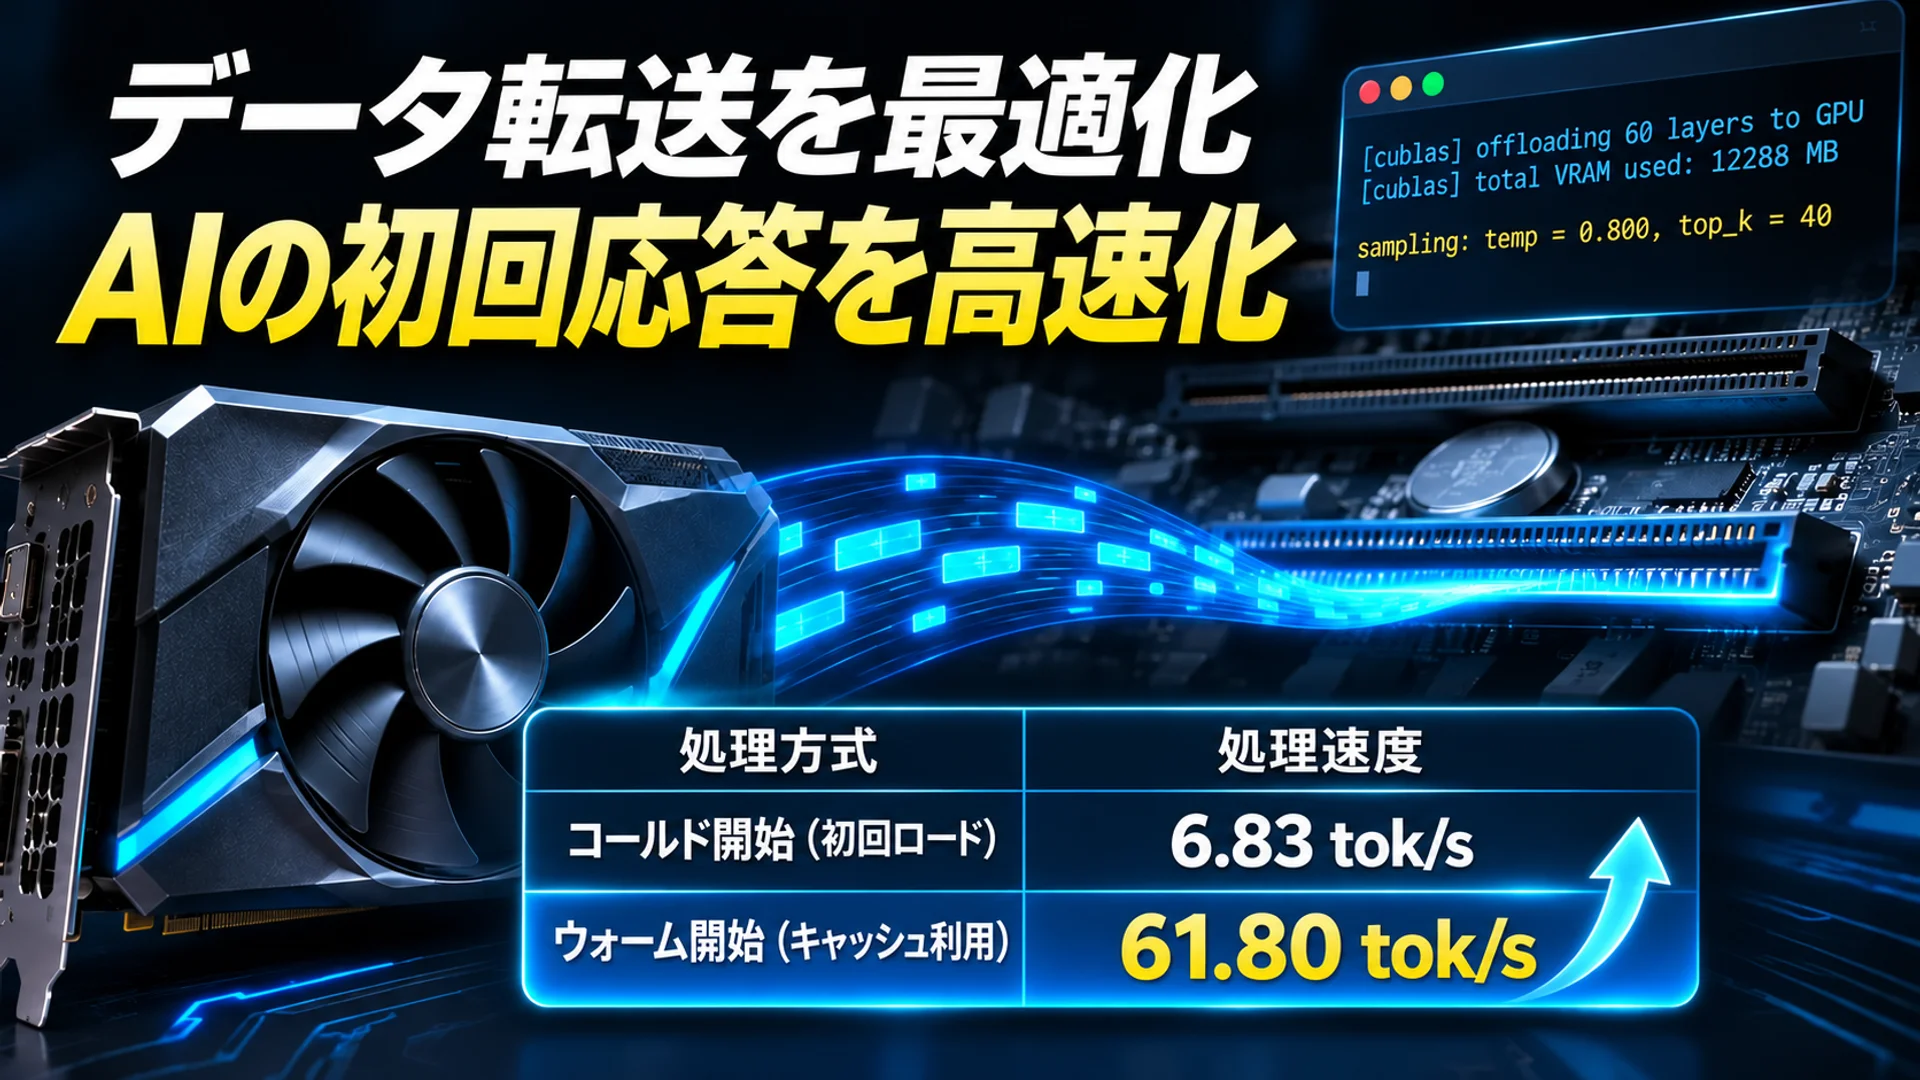
質問を入力すると、画面が30秒から60秒ほどフリーズし、突然通常の速度で回答のタイピングが始まるという経験をしたことがあるかもしれません。これはAIが深く考え込んでいる時間ではなく、データが届くのを待つ「ボトルネック」現象です。Betelgeuseプロジェクトの開発者が公開した事例によると、この沈黙の原因は明確でした。GPUの演算ユニットは遊休状態にあり、ディスクに保存された専門家(expert)重みをPCIeバス経由で一つずつ読み込む作業を待っていたのです。ハードウェアを変更せず、データ読み込みの順序と単位だけを変える3つの修正により、開発者はウォームアップ済みの状態でプロンプト処理速度が3〜6 tok/sから61.80 tok/sに向上したと明かしています。1
最初の文字が出るまでに30〜60秒停止する理由
低スペックなPCで超大型AIモデルを実行する場合、特に応答が遅くなる区間があります。それはAIが回答を一文字ずつ出力するデコード(Decoding)段階ではなく、入力した質問全体を先に処理してメモリに格納するプリフィル(Prefill)段階です。プリフィルはプロンプトのすべてのトークンを同時に処理してKVキャッシュを作成し、最初の回答文字を計算するプロセスであり、GPUの演算リソース(FLOPs)が十分であれば高速に進行します。業界では、この遅延時間をTTFT(Time To First Token:最初のトークン生成までの時間)として測定しています。23
Betelgeuseが実行したDeepSeek V4.1 Flash(748Bパラメータ)は、40層とEngramテーブルを含めて合計416GBの規模です。12GBのVRAMと16GBのRAMではすべてを格納できないため、大部分をNVMe SSDに置き、必要なものだけをPCIeバス経由で読み込む必要があります。標準的な方式では、質問一件を処理する間に40層のほぼすべての専門家が呼び出されるため、GPUは計算を行えず転送のみを待つことになります。その結果、500トークンの質問に対するプリフィル速度は1〜3 tok/sに過ぎませんでした。1
GPUを遊ばせない3つの修正
Betelgeuseの開発者は、モデルを切り詰めたり重みを再量子化したりする代わりに、データ転送の方法自体を変更しました。llama.cppをベースにしたこの実験的なフォークでは、すべてのルーティングされた専門家が元の精度で保持されます。
第一に、位置不変キャッシュ分割です。各層に20個の常駐スロットを固定しますが、5個はVRAM(ホットゾーン)、15個はホストRAM(Host-RAMゾーン)に割り当てます。重要なのは、ルーティングパスを変更しないことです。優先度0の専門家は全20スロットのプールから、優先度1〜5の専門家は常駐プール内でのみ評価されます。これにより、キャッシュの状態に関わらずモデルの選択パスが一致し、結果の一貫性が保証されます。また、Engramテーブルは層1と層14でのみ有効化され、トークンあたり約192KBのみを参照するという特性を活用し、RAMをほとんど使用せずに2MBのVRAMバッファへ直接ロードします。14
第二に、シングルパスレイヤーメジャープリフィルです。従来通りプロンプトを3トークン単位のマイクロバッチで処理すると、GPUテンサーコアの占有率が低くなります。開発者は代わりに16トークン単位で一度に処理し、ホストRAMにある専門家たちをPCIe経由で読み込む作業とGPU計算をオーバーラップさせます。データ転送と計算が並行して行われるため、GPUの待機時間が短縮されます。
第三に、パス終了時のVRAM昇格です。最初のパスが完了すると、実際に頻繁に使用された5つの専門家をVRAMホットスロットへ物理的に移動させます。論理的なルーティングは変化しないため、次のパス以降はPCIe転送コストなしで即時に計算が可能になります。
同じハードウェアで6.83 tok/sから61.80 tok/sへ
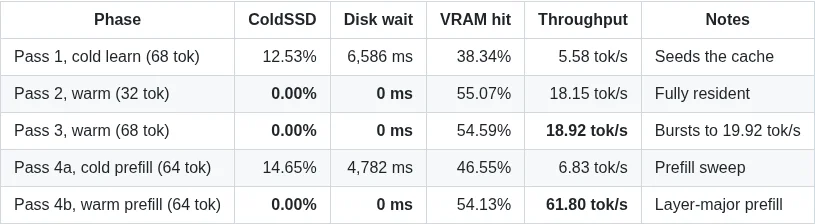
3つの変更の効果は、2つの数値で確認できます。まず、開発者は標準実装において、ウォームアップ状態のプロンプト処理速度が3〜6 tok/sから61.80 tok/sに改善されたと報告しています。また、改善されたエンジンを同一のPC上で64トークンのプロンプトを用いて繰り返し実行すると、キャッシュが空の最初のパスと、専門家がすべて常駐した後のパスとの差が現れます。テスト環境はRTX 3060 12GB(200W制限)、16GBシングルチャネルDDR4-3200、PCIe 4.0 NVMe SSDであり、スワップを無効にした状態でメモリ使用量を12GiBに制限しています。14
| パス | 状態 | プリフィル速度 | ディスク読み取り | ディスク待機 |
|---|---|---|---|---|
| 4a | コールド(プリフィルスイープ) | 6.83 tok/s | 14.65% | 4,782 ms |
| 4b | ウォーム(フル常駐) | 61.80 tok/s | 0.00% | 0 ms |
これらの数値は、Betelgeuse GitHubドキュメントの結果表に記載されているものです。4
開発者は、このようにキャッシュがウォームアップされた状態では、標準的なプロンプトに対する最初のトークン待ち時間(TTFT)は事実上なくなったと説明しています。この過程においても、デコード(回答生成)速度は18.15〜18.92 tok/sで維持され、VRAMのピーク使用量は11,396 MiBで12GiBの制限内で動作しました。14
改善の原因と適用範囲
開発者は、プリフィル改善の原因がモデルパラメータの削減ではなく、PCIe転送単位、バッチ方式、キャッシュポリシーの変更によるI/Oおよびスケジューリング最適化に由来すると説明しました。低スペックなPCであっても、ディスク容量とPCIe帯域幅が確保されていれば、超大型MoEモデルも実用的な速度で稼働できることを示唆しています。ただし、著者はシングルチャネルDDR4をデュアルチャネルに交換した場合、プリフィル速度が2倍に増加する可能性があると言及しましたが、これは推定値であり、検証された数値ではありません。
同じRTX 3060 12GBを使用した別プロジェクト(Strata、IQ2_XS量子化)と比較すると、本実験のプリフィル速度は低いものの、デコード速度はより高く現れます。しかし、両実験はモデル、量子化、プロンプト長さ、システムRAM構成が異なるため、純粋なハードウェア比較ではありません。14
結局のところ、本事例は「モデルが大きすぎて遅い」という通念とは異なり、MoEモデルにおける最初の回答遅延は、専門家ロードの順序と単位がPCIe帯域幅と整合しない場合に発生することを示しています。データロード戦略をハードウェアに合わせて調整すれば、12GBのVRAMと16GBのRAMでも748Bモデルにおける最初の沈黙を解消できます。ただし、これは一つのGPUとストレージ構成で検証された実験的な結果であるため、他の環境で同じ数値が自動的に保証されるわけではありません。