Después de enviar una pregunta, probablemente haya experimentado la pantalla deteniéndose entre 30 y 60 segundos antes de que, de repente, las respuestas comiencen a escribirse a velocidad normal. Esto no se debe al tiempo que la IA tarda en "pensar profundamente", sino a un fenómeno de 'cuello de botella' mientras espera la llegada de los datos. Según el caso publicado por el desarrollador del proyecto Betelgeuse, la causa de este silencio era clara: las unidades de cómputo de la GPU permanecían inactivas, a la espera de que los pesos de los expertos almacenados en el disco se cargaran uno a uno a través del bus PCIe. Mediante tres modificaciones que solo cambiaron el orden y la unidad de carga de los datos, sin modificar el hardware, el desarrollador indicó que la velocidad de procesamiento de prompts en estado precalentado (warmed) pasó de 3-6 tok/s a 61.80 tok/s. 1
La razón de las pausas de 30 a 60 segundos antes de la primera palabra
Al ejecutar modelos de IA ultra grandes en PCs de gama baja, existen intervalos específicos donde las respuestas son especialmente lentas. Esto no ocurre en la etapa de decodificación, donde la IA genera la respuesta carácter por carácter, sino en la etapa de prellenado (prefill), que procesa primero la pregunta completa y la carga en la memoria. El prellenado es el proceso que procesa simultáneamente todos los tokens del prompt para crear la caché KV y calcular el primer carácter de la respuesta; para que se realice rápidamente, se requieren recursos de cómputo de GPU (FLOPs) suficientes. La industria mide este tiempo de latencia como TTFT (Time To First Token, tiempo hasta la generación del primer token). 23
El modelo DeepSeek V4.1 Flash (748B de parámetros) ejecutado por Betelgeuse tiene un tamaño total de 416GB, incluyendo 40 capas y tablas Engram. Con 12GB de VRAM y 16GB de RAM, no es posible almacenar todo en la memoria rápida, por lo que la mayor parte se mantiene en la unidad SSD NVMe y solo se cargan los elementos necesarios a través del bus PCIe. En el método estándar, casi todos los expertos de las 40 capas se invocan durante el procesamiento de una sola pregunta, lo que obliga a la GPU a esperar las transferencias sin poder realizar cálculos. Como resultado, la velocidad de prellenado para una pregunta de 500 tokens era apenas de 1-3 tok/s. 1
Tres modificaciones que mantienen la GPU ocupada
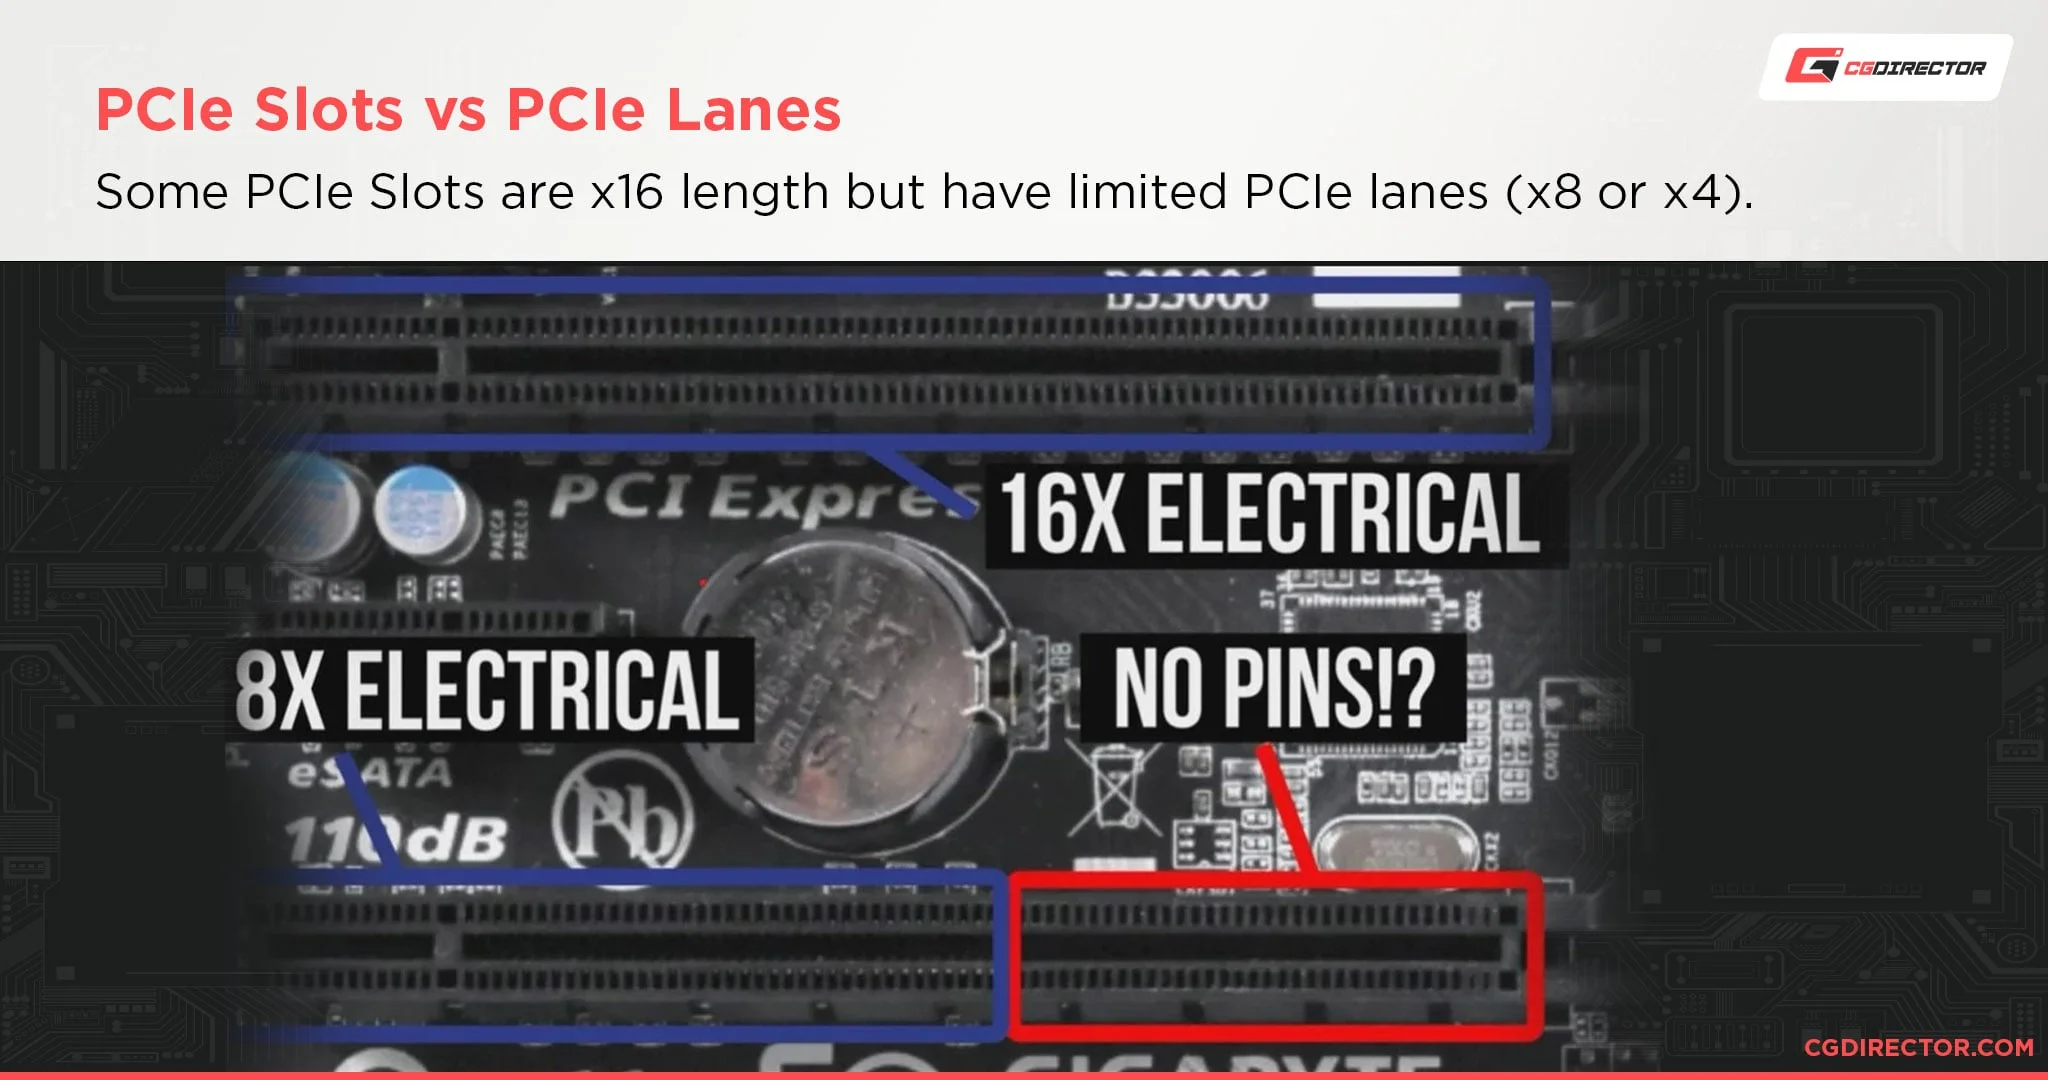
En lugar de recortar el modelo o requantizar los pesos, el desarrollador de Betelgeuse cambió el propio método de movimiento de datos. Este fork experimental, basado en llama.cpp, mantiene todos los expertos enrutados a su precisión original.
Primero, la división de caché independiente de la posición. Se asignan 20 slots residuales fijos por capa, de los cuales 5 se destinan a la VRAM (zona caliente) y 15 a la RAM del host (zona Host-RAM). La clave es no alterar la ruta de enrutamiento. Los expertos de orden 0 se evalúan desde el pool completo de 20 slots, mientras que los de orden 1-5 se evalúan solo dentro del pool residual. Esto garantiza que la ruta de selección del modelo sea consistente independientemente del estado de la caché, asegurando resultados coherentes. Además, aprovechando que las tablas Engram solo se activan en las capas 1 y 14 y referencian aproximadamente 192KB por token, se cargan directamente en un búfer de VRAM de 2MB sin consumir apenas RAM. 14
Segundo, el prellenado por capa con un solo paso. Al procesar el prompts en micro-lotes de 3 tokens como era habitual, la utilización de los núcleos tensoriales de la GPU es baja. El desarrollador optó por procesar bloques de 16 tokens a la vez, superponiendo la carga de expertos desde la RAM del host vía PCIe con los cálculos de la GPU. Al ejecutarse paralelamente la transferencia de datos y el cómputo, se reduce el tiempo de espera de la GPU.
Tercero, la promoción a VRAM al finalizar el paso. Una vez concluido el primer paso, los 5 expertos utilizados con mayor frecuencia se mueven físicamente a los slots calientes de la VRAM. Dado que el enrutamiento lógico no cambia, los pasos siguientes permiten cálculos instantáneos sin el coste de transferencia vía PCIe.
De 6.83 tok/s a 61.80 tok/s en el mismo hardware
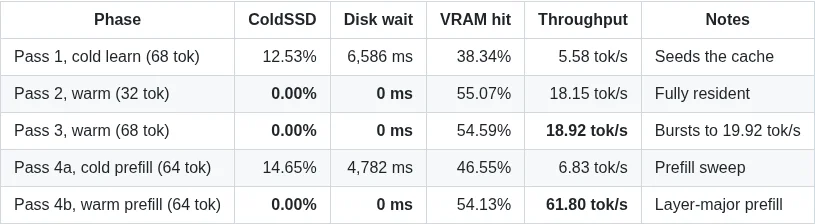
El efecto de los tres cambios se verifica mediante dos métricas. En primer lugar, el desarrollador reportó que la velocidad de procesamiento de prompts en estado precalentado mejoró de 3-6 tok/s a 61.80 tok/s en la implementación estándar. Además, al ejecutar repetidamente el motor mejorado en el mismo PC con un prompt de 64 tokens, se observa la diferencia entre el primer paso (caché vacía) y los pasos posteriores (expertos totalmente residuales). El entorno de prueba consistió en una RTX 3060 de 12GB (limitada a 200W), 16GB de DDR4-3200 en un solo canal y un SSD NVMe PCIe 4.0, con el uso de memoria limitado a 12GiB y el swapping desactivado. 14
| Paso | Estado | Velocidad de prellenado | Lectura de disco | Espera de disco |
|---|---|---|---|---|
| 4a | Frío (barrido de prellenado) | 6.83 tok/s | 14.65% | 4,782 ms |
| 4b | Precalentado (totalmente residual) | 61.80 tok/s | 0.00% | 0 ms |
Estos valores son los reportados en la tabla de resultados de la documentación de Betelgeuse en GitHub. 4
El desarrollador explica que, con la caché en estado precalentado, la espera del primer token (TTFT) para un prompt estándar desaparece prácticamente. Durante este proceso, la velocidad de decodificación (generación de respuesta) se mantuvo entre 18.15 y 18.92 tok/s, y el uso pico de VRAM fue de 11,396 MiB, dentro del límite de 12GiB. 14
Causas y alcance de la mejora
El desarrollador explicó que la mejora en el prellenado no se debió a una reducción de los parámetros del modelo, sino a optimizaciones de E/S y de programación derivadas del cambio en las unidades de transferencia PCIe, la modalidad de lote y las políticas de caché. Esto sugiere que, incluso en PCs de gama baja, si se dispone de capacidad de disco y ancho de banda PCIe, los modelos MoE ultra grandes pueden funcionar a velocidades prácticas. No obstante, aunque el autor mencionó que cambiar la DDR4 de un solo canal a doble canal podría duplicar la velocidad de prellenado, esta es solo una estimación y no una cifra verificada.
Al comparar con otros proyectos que utilizan la misma RTX 3060 de 12GB (Strata, cuantización IQ2_XS), se observa que, aunque la velocidad de prellenado de este experimento es menor, la velocidad de decodificación es superior. Sin embargo, esto no constituye una comparación pura de hardware, ya que los dos experimentos difieren en el modelo, la cuantización, la longitud del prompt y la configuración de RAM del sistema. 14
En definitiva, este caso demuestra que, contrariamente a la creencia de que "el modelo es demasiado grande y por eso es lento", la latencia de la primera respuesta en los modelos MoE ocurre cuando el orden y la unidad de carga de los expertos no se alinean con el ancho de banda del PCIe. Al ajustar la estrategia de carga de datos al hardware disponible, es posible eliminar el silencio inicial de un modelo de 748B incluso con 12GB de VRAM y 16GB de RAM. Sin embargo, dado que estos son resultados experimentales verificados en una configuración específica de GPU y almacenamiento, no se garantiza automáticamente que los mismos números se reproduzcan en otros entornos.