질문을 입력한 뒤 화면이 30초에서 60초 동안 멈춰 있다가 갑자기 정상 속도로 답을 타이핑하는 경험을 해보셨을 것입니다. 이는 AI가 깊이 생각하는 시간이 아니라, 데이터가 도착하길 기다리는 '병목' 현상입니다. Betelgeuse 프로젝트 개발자가 공개한 사례에 따르면 이 침묵의 정체는 명확했습니다. GPU 연산 유닛은 놀고 있었고, 디스크에 저장된 전문가(expert) 가중치를 PCIe 버스로 하나씩 불러오는 작업을 기다리고 있었기 때문입니다. 하드웨어를 바꾸지 않고 데이터를 불러오는 순서와 단위만 바꾸는 세 가지 수정으로, 개발자는 워밍된 상태의 프롬프트 처리 속도가 3~6 tok/s에서 61.80 tok/s가 되었다고 밝혔습니다. 1
첫 글자까지 30~60초를 멈추는 이유
저사양 PC에서 초대형 AI 모델을 실행할 때 유독 답이 늦은 구간이 있습니다. AI가 답을 한 글자씩 뽑아내는 디코딩(Decoding) 단계가 아니라, 입력한 질문 전체를 먼저 처리해 메모리에 담는 프리필(Prefill) 단계입니다. 프리필은 프롬프트의 모든 토큰을 동시에 처리해 KV 캐시를 만들고 첫 번째 답변 글자를 계산하는 과정으로, GPU 연산 자원(FLOPs)이 충분해야 빠르게 진행됩니다. 업계에서는 이 지연 시간을 TTFT(Time To First Token, 첫 토큰 생성까지의 시간)로 측정합니다. 23
Betelgeuse가 실행한 DeepSeek V4.1 Flash(748B 파라미터)는 40개 레이어와 Engram 테이블을 포함해 총 416GB 규모입니다. 12GB VRAM과 16GB RAM으로는 전부 담을 수 없어 대부분을 NVMe SSD에 두고 필요한 것만 PCIe 버스로 불러와야 합니다. 표준 방식에서는 질문 하나를 처리하는 동안 40개 레이어의 거의 모든 전문가가 호출되므로, GPU가 계산을 하지 못한 채 전송만 기다리게 됩니다. 그 결과 500토큰 질문의 프리필 속도는 1~3 tok/s에 불과했습니다. 1
GPU를 쉬지 않게 만드는 세 가지 수정
Betelgeuse 개발자는 모델을 잘라내거나 가중치를 재양자화하는 대신, 데이터를 옮기는 방식 자체를 변경했습니다. llama.cpp를 기반으로 한 이 실험적 포크는 모든 라우팅된 전문가를 원래 정밀도로 유지합니다.
첫째, 위치 불변 캐시 분할입니다. 각 레이어마다 20개의 상주 슬롯을 고정하되, 5개는 VRAM(핫 존), 15개는 호스트 RAM(Host-RAM 존)에 배정합니다. 핵심은 라우팅 경로를 변경하지 않는 것입니다. 0순위 전문가는 전체 20슬롯 풀에서, 1~5순위는 상주 풀 내에서만 평가됩니다. 이를 통해 캐시 상태와 무관하게 모델 선택 경로가 일치하며, 결과의 일관성이 보장됩니다. 또한 Engram 테이블은 레이어 1과 14에서만 활성화되어 토큰당 약 192KB만 참조한다는 특성을 활용해, RAM을 거의 사용하지 않고 2MB VRAM 버퍼에 직접 로드합니다. 14
둘째, 단일 패스 레이어-메이저 프리필입니다. 기존처럼 프롬프트를 3토큰짜리 마이크로배치로 처리하면 GPU 텐서 코어 점유율이 낮아집니다. 개발자는 대신 16토큰 단위로 한 번에 처리하며, 호스트 RAM에 있는 전문가들을 PCIe로 불러오는 작업과 GPU 계산을 겹칩니다. 데이터 이동과 계산이 병행되므로 GPU 대기 시간이 줄어듭니다.
셋째, 패스 종료 시 VRAM 승격입니다. 첫 패스가 끝나면 실제로 빈번하게 사용된 전문가 5개를 VRAM 핫 슬롯으로 물리적으로 이동시킵니다. 논리적 라우팅은 변하지 않으므로, 다음 패스부터는 PCIe 전송 비용 없이 즉각 계산이 가능합니다.
같은 하드웨어에서 6.83 tok/s에서 61.80 tok/s로
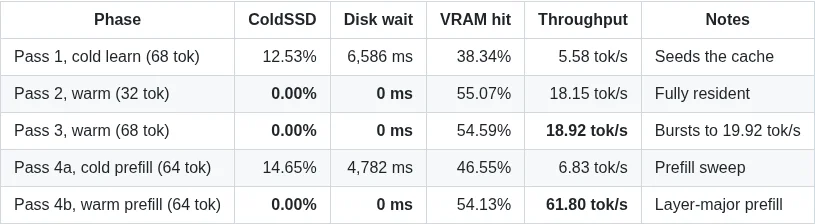
세 가지 변경의 효과는 두 가지 수치로 확인됩니다. 먼저 개발자는 표준 구현에서 워밍 상태의 프롬프트 처리 속도가 3~6 tok/s에서 61.80 tok/s로 개선됐다고 보고했습니다. 또한 개선된 엔진을 동일한 PC에서 64토큰 프롬프트로 반복 실행하면, 캐시가 비어 있는 첫 패스와 전문가가 모두 상주한 이후 패스의 차이가 나타납니다. 테스트 환경은 RTX 3060 12GB(200W 제한), 16GB 단채널 DDR4-3200, PCIe 4.0 NVMe SSD이며, 스왑을 꺼둔 상태에서 메모리 사용량을 12GiB로 제한했습니다. 14
| 패스 | 상태 | 프리필 속도 | 디스크 읽기 | 디스크 대기 |
|---|---|---|---|---|
| 4a | 콜드 (프리필 스윕) | 6.83 tok/s | 14.65% | 4,782 ms |
| 4b | 워름 (풀 상주) | 61.80 tok/s | 0.00% | 0 ms |
두 수치는 Betelgeuse GitHub 문서의 결과 표에 보고된 값입니다. 4
개발자는 이렇게 캐시가 워밍된 상태에서 표준 프롬프트의 첫 토큰 대기(TTFT)는 사실상 없어졌다고 설명합니다. 이 과정에서도 디코딩(답변 생성) 속도는 18.15~18.92 tok/s로 유지되었으며, VRAM 피크 사용량은 11,396 MiB로 12GiB 한도 내에서 작동했습니다. 14
개선의 원인과 적용 범위
개발자는 프리필 개선의 원인이 모델 파라미터 감소가 아니라, PCIe 전송 단위와 배치 방식, 캐시 정책 변경에서 비롯된 I/O 및 스케줄링 최적화라고 설명했습니다. 저사양 PC라 하더라도 디스크 용량과 PCIe 대역폭이 확보된다면 초대형 MoE 모델도 실용적인 속도로 구동할 수 있음을 시사합니다. 단, 저자는 단채널 DDR4를 듀얼채널로 교체할 경우 프리필 속도가 두 배로 증가할 수 있다고 언급했으나, 이는 추정치일 뿐 검증된 수치는 아닙니다.
같은 RTX 3060 12GB를 쓴 다른 프로젝트(Strata, IQ2_XS 양자화)와 비교하면 이 실험의 프리필 속도는 낮지만 디코딩 속도는 더 높게 나타나는데, 두 실험은 모델과 양자화, 프롬프트 길이, 시스템 RAM 구성이 서로 달라 순수한 하드웨어 비교는 아닙니다. 14
결국 이 사례는 '모델이 너무 커서 느리다'는 통념과 달리, MoE 모델의 첫 답변 지연은 전문가 로드 순서와 단위가 PCIe 대역폭과 어긋날 때 발생한다는 점을 보여줍니다. 데이터 로드 전략을 하드웨어에 맞게 조정하면 12GB VRAM과 16GB RAM으로도 748B 모델의 첫 침묵을 해소할 수 있습니다. 다만 이는 한 GPU와 저장 구성에서 검증된 실험적 결과이므로, 다른 환경에서 동일 수치가 자동으로 보장되지는 않습니다.