2025年8月的某个夜晚,只要在谷歌搜索框中输入指令“site:chatgpt.com/share”,他人的ChatGPT对话便会未经过滤地出现在搜索结果中。这些链接原本是为了展示给对话对象而创建的,但由于用户无意间点击了“允许搜索引擎索引”选项,导致健康状况、性生活、药物服用等私人信息变成了全球公开的文档。据Scoopie博客报道的原始事件指出,当时OpenAI通过联席首席信息安全官Dane Sturkey宣布彻底删除该功能,但已经传播到谷歌的敏感信息已无法挽回。1
这一事故引发了一个根本性的疑问:我们向AI提出的问题流向了何处,以及AI给出的回答是否属实。先说结论,如果妥善调整设置,可以防止对话内容泄露至外部。但是,AI听取症状后“貌似”地推断出“中毒”或特定疾病,这一行为本身并非经过事实核查的结果,因此需要谨慎对待。对话的流向可以通过设置由用户控制,但回答的真实性必须通过单独的验证过程来确认。
谷歌上显示的私人对话,泄露到了哪里
2025年8月3日发生的ChatGPT对话曝光事故,并非黑客攻击,而是源于设置的陷阱。当用户为了与他人分享内容而创建链接时,如果同意了“允许搜索引擎索引”,谷歌便会将该链接作为可搜索状态进行登记。这一事故揭示了AI服务处理数据的基本方式。输入ChatGPT的对话内容默认存储在服务器上,如果“改善模型以供所有人使用(Improve the model for everyone)”的开关处于开启状态,这些数据将被用作未来AI的学习数据。
这意味着数据可能在用户未察觉的时刻被存储并暴露于外部。幸运的是,已有阻止此类外部泄露和训练数据使用的设置。当前立即可以构建的最可靠的两道防线如下。
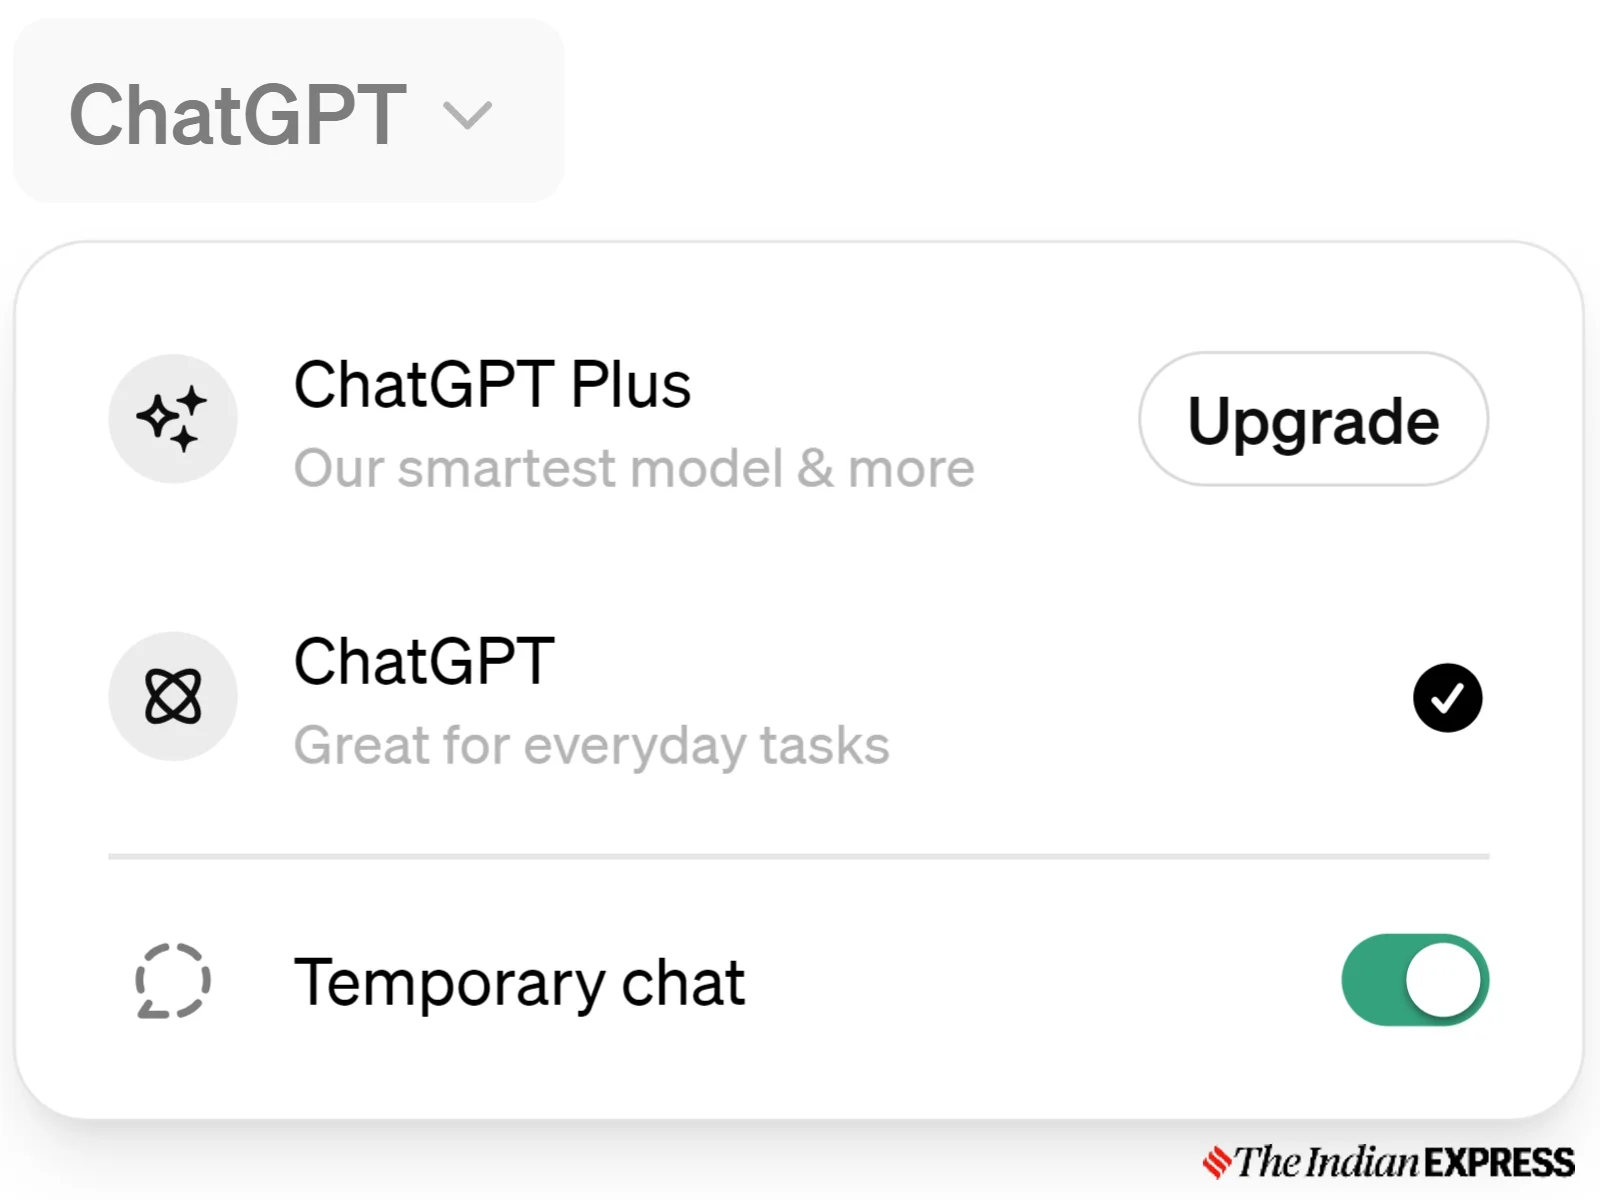
第一,在设置的“数据控制”菜单中关闭“改善模型以供所有人使用”。这样,您的对话将不会被用于AI学习。不过,关闭此开关意味着AI无法参考此前的对话记录,且对话也不会被保存,需承担这一权衡代价。第二,利用“临时聊天(Temporary Chat)”功能。在临时聊天模式下,对话完全不会存储在服务器上,也不会用作训练数据。在进行身体状况等敏感私人对话时,开启临时聊天模式是明智之举。1
为什么AI会编造不存在的判例和疾病
即使设置了确保对话内容安全地保留在服务器且不外泄,也不意味着可以全盘接受AI的回答。当因腹痛、恶心而询问“是否被下毒?”时,如果AI动用专业医学术语,貌似合理地主张“中毒”的可能性,可以信任这一回答吗?这里需要理解“幻觉(Hallucination)”这一现象。幻觉是指AI生成看似合理但实际上不存在的事实现象,并将其表述为事实。
根据Callus公司博客的解释,生成式AI并非学习“事实”,而是通过“概率预测语言模式”的模型。也就是说,它生成的是输入句子后续词汇中统计上最自然延续的句子。因此,AI具有为了完善语法和逻辑完整性,将自己未知的空白用貌似合理的推测填补的特征。由于AI只是“生成”句子而非“验证”,无论是中毒还是其他疾病,即使回答是编造的,它也会以仿佛知情的自信语气输出。2
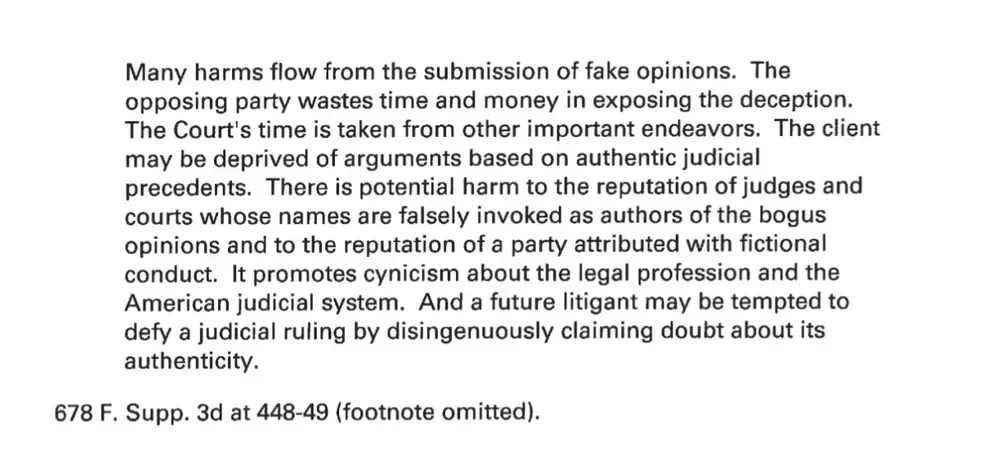
自信的语调与客观事实截然不同,这在现实世界中有时会导致巨大代价。京畿道AI市民讲师洪慧珍在2025年12月的YouTube讲座中提及的2023年美国纽约“阿比安卡(Avianca)事件”便是典型代表。当时律师们将法律研究任务交给ChatGPT,并直接提交了AI生成的6个判例。然而,这6个判例均为世界上并不存在的虚拟判例。最终,这些律师被处以5,000美元罚款及暂停执业处分。3
在医疗和研究领域,幻觉带来的风险也有所报道。据洪慧珍讲师称,在医疗领域,有因AI提供错误诊断信息导致患者治疗延误的案例;讲师本人也曾将数十篇论文的研究文件整理为Markdown格式后请求提供出处,结果发现AI在列表中包含了并不存在的论文。这意味着不存在的疾病或处方可能会以貌似合理的医疗诊断书形式出现。3
与AI安全对话和使用信息的四项原则
向AI吐露症状和隐私是否因危险而需要避免?未必如此。如果通过控制环境防止对话泄露,并将AI生成的回答不视为既定事实,而是作为“验证的起点”,则可作为有用的工具使用。
首先,需确立输入个人信息时的原则。安全指南建议,应避免直接在聊天窗口中输入实名、具体卡号、内部项目名等识别信息。应养成习惯,不写“我是洪吉童,负责ABC项目”,而是将问题改为“某人的健康状况”或“某家公司”等匿名化、一般化的情况。对于敏感症状或个人秘密,在切换到临时聊天模式的同时,从提问内容本身删除识别信息或姓名,是最安全的预防措施。1
第二项原则是对AI提出的具体“事实主张”应用检查清单。请检查:▲引用来源是否明确 ▲原文内容是否一致 ▲是否提供了具体数值或依据 ▲是否与其他信息源或其他AI模型一致。完成此过程后,需要进行与该领域专家(医生、律师等)的交叉验证程序。3
第三是掌握要求AI自我反驳或询问确信度的“多重验证例程”。不要只问“诊断我的症状”,而应反问:“你确信刚才的诊断是事实吗?”或“是否有反对该诊断的意见或替代方案?”专家指出,向AI询问确信度或要求提供反对意见,有助于捕捉幻觉。3
第四是理解RAG(检索增强生成)概念。RAG是一种技术结构,旨在防止AI仅通过概率推测填补空白,而是先检索已验证的数据库或公司文档,并基于其内容回答。虽然这主要在企业环境中使用,但对普通用户而言,可以将其理解为“习惯直接在网络可靠原文或医学论文网站搜索并确认AI回答”的原理。
正如我们在2025年8月谷歌搜索结果中看到他人隐私时所意识到的,通过细致地开启或关闭设置来控制对话流向,是我能守护的领域。相反,AI看似合理的诊断是否在现实中发生,并非由AI决定,而是需要我亲自前往医院或寻找专家进行验证的领域。如果对AI自信满满的答案放松警惕,撤去最后的安全保障,生成式AI便能在妥善保管个人隐私的同时,充当有用的顾问角色。
参考资料
- ↩
- 할루시네이션(Hallucination)이란? 개념부터 발생 원인, 주의사항까지 · calluscompany.com↩
- [인공지능_도민강사]홍혜진_ 생성형 AI 할루시네이션 이해와 대응전략 · youtube.com↩



