2025年8月のある夜、Googleの検索窓に「site:chatgpt.com/share」というコマンドを入れるだけで、他人のChatGPT会話がフィルタリングされずに検索結果として表示されていました。これは会話相手に見せるために作成したリンクでしたが、「検索エンジンへのインデックス許可」オプションを無意識にクリックしたせいで、健康状態や性生活、服薬情報などのプライベートな話題が世界中に公開された文書となってしまったのです。Scoopyブログが報じた元の事例によれば、当時OpenAIは共同最高情報セキュリティ責任者(CISO)のデイン・スターキーを通じて、この機能を完全に削除すると発表しましたが、すでにGoogleに広まった機密情報は取り返しがつかない状況でした。1
この事故は、私たちがAIに投げかける質問がどこへ向かうのか、そしてその回答は果たして事実なのかという根本的な疑問を投げかけます。結論から申し上げますと、設定を適切に変更すれば、自分の会話内容が外部へ漏洩する事態は防ぐことができます。しかし、AIが自分の症状を聞いて「毒殺」や特定の疾患をもっともらしく診断する行為自体は、事実検証を経た結果ではないため注意が必要です。会話がどこへ向かうかは自分で設定により管理できますが、その回答が真実であるかどうかは、別途確認手続きが不可欠であるためです。
Googleに表示された個人会話、どこへ漏れているのか
2025年8月3日に発生したChatGPT会話の露出事故は、ハッキングではなく設定の落とし穴から始まりました。ユーザーが会話内容を他者と共有するためにリンクを生成する際、「検索エンジンへのインデックス許可」に同意した場合、Googleがそのリンクをそのまま検索可能な状態で登録してしまったのです。この事故が示す重要点は、AIサービスがデータを扱う基本的なアプローチです。ChatGPTに入力した会話内容は基本的にサーバーに保存され、「すべての人のためのモデル改善(Improve the model for everyone)」のトグルがオンになっている場合、将来のAIの学習データとして活用されます。
これは、ユーザーが意図しない瞬間にデータが保存され、外部へ露出する可能性があることを意味します。幸いにも、こうした外部への露出や学習データとしての活用を遮断するための設定が用意されています。今すぐ変更できる最も確実な防御策は2つあります。
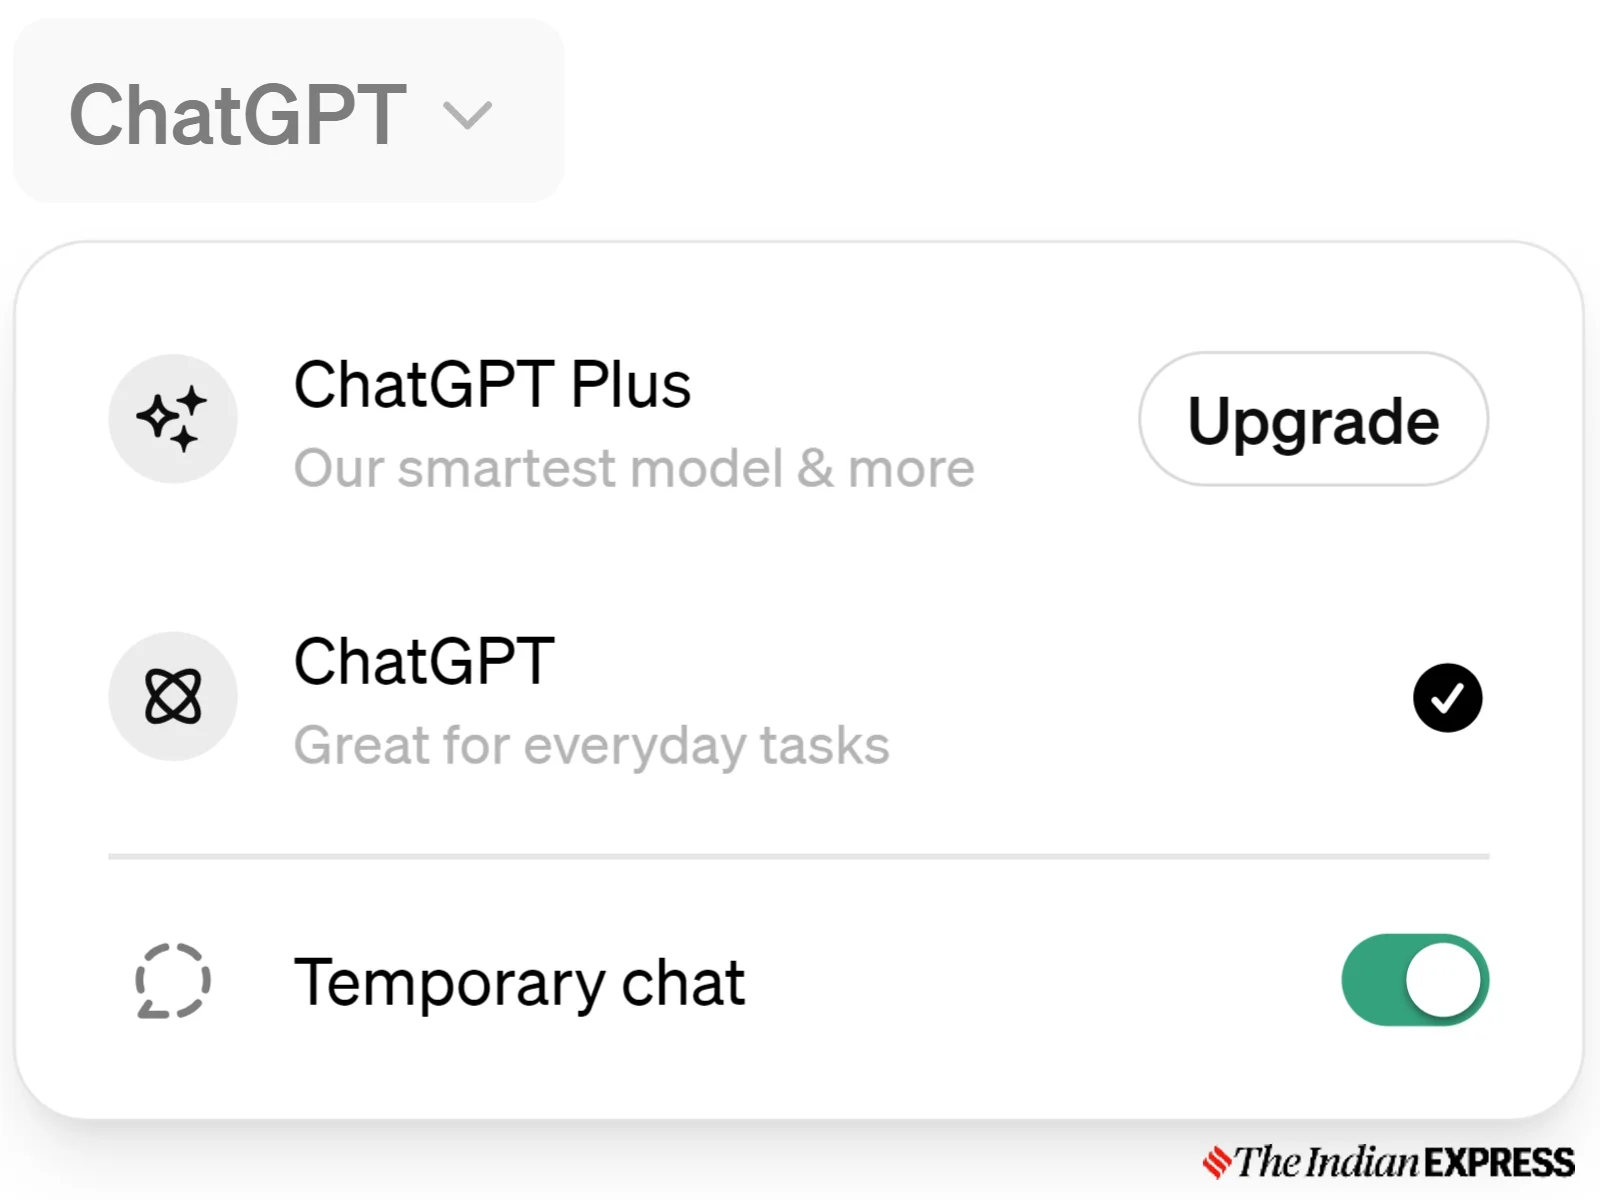
1つ目は、設定の「データ制御」メニューで「すべての人のためのモデル改善」をオフにすることです。こうすることで、自分の会話がAIの学習に使用されなくなります。ただし、このトグルをオフにすると、AIが過去の会話履歴を参照できなくなり、保存もされないというトレードオフを受け入れる必要があります。2つ目は、「一時チャット(Temporary Chat)」機能を活用することです。一時チャットモードでは、会話はサーバーに一切保存されず、学習データとしても使用されません。体調に関するような機密性の高い個人会話を交わす際は、一時チャットモードをオンにするのが賢明です。1
なぜAIは存在しない判例や病気を創作して語るのか
自分の会話内容が安全にサーバーに残らないよう設定を整えたからといって、AIの回答をそのまま信じてよいわけではありません。腹痛や吐き気があり、「もしかして毒殺されたのだろうか?」と尋ねた際、AIが専門的な医学用語を駆使してもっともらしく「毒殺」の可能性を主張する場合、それを信頼してもよいのでしょうか。ここでは「ハルシネーション(Hallucination、幻覚)」という現象を理解する必要があります。ハルシネーションとは、AIがもっともらしいが存在しない事実を、事実であるかのように生成する現象です。
Calus社のブログの説明によれば、生成AIは「事実」を学習するのではなく、「言語パターンを確率的に予測」するモデルです。つまり、入力された文の後に続く単語群の中から、統計的に最も自然に接続する文を生成している 셈です。したがって、AIは文法を完璧に合わせ、論理的な整合性を保つために、自分が知らない空白をもっともらしい推測で埋める特性を持っています。AIは文を「生成」するだけで「検証」は行わないため、毒殺であれ他の病気であれ、作り出した回答でもまるで知っているかのような自信満々なトーンで提示してしまうのです。2
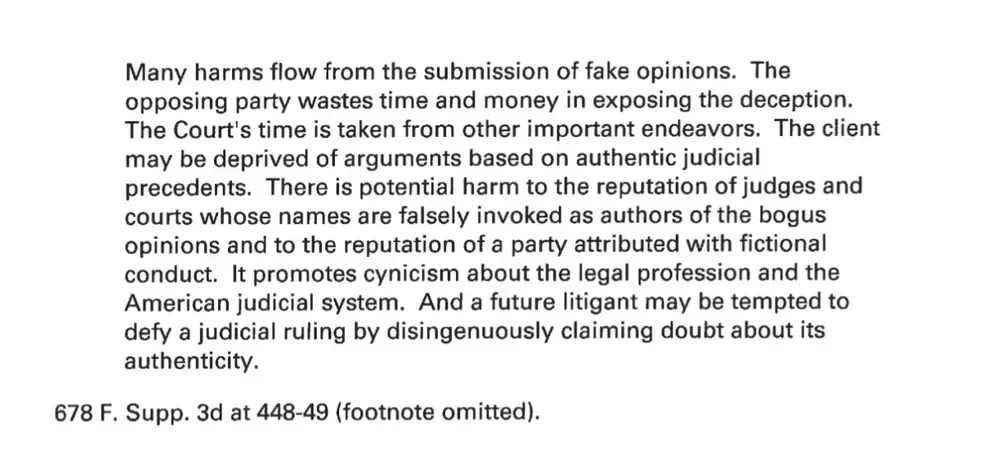
自信に満ちたトーンと実際の事実は別物であるという点は、現実世界において大きな代償を払うことにもつながります。京畿道のAI住民講師であるホン・ヘジン講師が2025年12月のYouTube講義で言及した、2023年の米国ニューヨークの「アビアンカ事件」がその代表的な事例です。当時、弁護士たちはChatGPTに法的調査を依頼し、AIが生成した6件の判例をそのまま法廷に提出しました。しかし、この6件はすべて世の中に存在しない架空の判例でした。結果として、これらの弁護士は5,000ドルの罰金と資格停止処分を受けました。3
医療および研究分野においても、ハルシネーションによるリスクが報告されています。ホン・ヘジン講師によれば、医療分野でAIが誤った診断情報を提供し、患者の治療が遅れる事例があること、また講師自身も数十本の論文リサーチファイルをMarkdown形式に整理した後、出典を依頼したところ、AIが存在しない論文をリストに含めて列挙していることを確認したと明かしています。存在しない疾患や処方箋が、もっともらしい医療診断書の形式で出力される可能性があるということです。3
AIと安全に対話するための4つの原則
AIに自分の症状やプライバシーを打ち明けることは危険で避けるべきでしょうか。必ずしもそうとは限りません。会話が漏れないように自分の環境を制御し、AIが作成した回答をそのまま事実として受け入れるのではなく、「検証の出発点」として扱うのであれば、有用なツールとして活用できます。
まず、個人情報を入力する際の原則を確立する必要があります。セキュリティガイドラインでは、氏名や具体的なカード番号、社内のプロジェクト名などの識別情報を直接チャットウィンドウに入力すること自体を避けるよう推奨しています。「私の名前はホン・ギルドンで、ABCプロジェクトを担当しています」と書くよりも、「ある人の健康状態」や「ある会社」というように仮名処理し、一般的な状況として質問を変える習慣を身につけるべきです。機密性の高い症状や個人的な秘密は一時チャットモードに切り替えることですが、質問内容そのものから識別情報や名前を削除することが最も安全な予防策です。1
2つ目の原則は、AIが提示した具体的な「事実主張」に対してチェックリストを適用することです。▲引用元が明確か ▲原文の内容と一致するか ▲具体的な数値や根拠が提示されているか ▲他の情報源や他のAIモデルと一致するか、を確認してください。このプロセスが終わった後、その分野の専門家(医師、弁護士など)によるクロスレビューの手続きが必要です。3
3つ目は、AI自身に対して反論や確信度を要求する「多重検証ルーティン」を習得することです。単に「私の症状を診断して」と聞くんではなく、「あなたがたった今した診断が事実だと確信していますか?」や、「この診断に対する反対意見や代替案はありますか?」と問い返す方法です。AIに確信度を尋ねたり、反対意見を求めたりすることが、ハルシネーションを検出するのに効果的だと専門家は指摘しています。3
4つ目は、RAG(Retrieval-Augmented Generation、検索拡張生成)の概念を理解することです。RAGとは、AIが一人で確率的推測によって空白を埋めるのではなく、事前に検証されたデータベースや社内文書を検索し、その内容に基づいて回答させる技術的な構造です。主に企業環境で使用される概念ですが、一般ユーザーの立場では、「AIの回答をウェブ上の信頼できる原文や医学論文サイトから直接検索して確認する習慣」と同じ理屈で捉えることができます。
2025年8月のGoogle検索結果に表示された他人のプライバシーを見て気づいたように、自分の会話がどこへ流れていくのか、設定をオン・オフする細やかな配慮は、自分が守れる領域です。一方で、AIが吐き出すもっともらしい診断が、実際に自分の身体で起きていることなのか否かは、AIではなく自分が直接病院へ行くか、専門家を尋ねて検証すべき領域です。AIが出力した自信満々な回答に安心し、最後の安全装置を外してしまわない限り、生成AIは自分の個人情報を適切に管理したまま、有用なアドバイザーとしての役割を果たしてくれるでしょう。
参考文献
- ↩
- 할루시네이션(Hallucination)이란? 개념부터 발생 원인, 주의사항까지 · calluscompany.com↩
- [인공지능_도민강사]홍혜진_ 생성형 AI 할루시네이션 이해와 대응전략 · youtube.com↩



