Una noche de agosto de 2025, bastaba con escribir únicamente el comando 'site:chatgpt.com/share' en el buscador de Google para que las conversaciones de ChatGPT de otras personas aparecieran sin filtro en los resultados de búsqueda. Aunque los enlaces habían sido creados para mostrar la conversación a un interlocutor concreto, debido a que se hizo clic sin atención en la opción «Permitir la indexación por buscadores», historias íntimas como el estado de salud, la vida sexual o la medicación se convirtieron en documentos públicos accesibles en todo el mundo. Según el informe original publicado por el blog Scoopy, en ese momento OpenAI, a través de Dane Stuckey, su entonces co-director de seguridad de la información (CISO), anunció la eliminación completa de esta función; sin embargo, la información sensible que ya se había propagado por Google resultaba imposible de recuperar. 1
Este incidente plantea dudas fundamentales sobre a dónde van las preguntas que formulamos a la IA y si sus respuestas son realmente ciertos hechos. Para concluir: es posible impedir que el contenido de nuestras conversaciones se filtre al exterior cambiando adecuadamente la configuración. No obstante, el acto en sí de que una IA, tras escuchar nuestros síntomas, diagnostique de manera verosímil «envenenamiento» o una enfermedad específica no es el resultado de una verificación de hechos, por lo que se debe proceder con cautela. Mientras que el destino de nuestras conversaciones se puede controlar mediante la configuración, su veracidad exige un proceso de comprobación independiente.
Las conversaciones privadas que aparecen en Google, ¿hacia dónde se filtran?
El incidente de exposición de conversaciones de ChatGPT ocurrido el 3 de agosto de 2025 no fue producto de un pirateo, sino de una trampa en la configuración. Cuando un usuario genera un enlace para compartir el contenido de una conversación con terceros y acepta la opción «Permitir la indexación por buscadores», Google registra dicho enlace tal cual, dejándolo disponible para su búsqueda. Lo que este incidente ilustra de manera importante es la forma básica en que los servicios de IA gestionan los datos. Las conversaciones introducidas en ChatGPT se almacenan por defecto en los servidores y, si el interruptor de «Mejora del modelo para todos» («Improve the model for everyone») está activado, dicho contenido se utiliza como dato de entrenamiento futuro para la IA.
Esto significa que los datos pueden almacenarse y exponerse al exterior en momentos en que el usuario no lo prevé. Afortunadamente, existen configuraciones para bloquear esta exposición externa y el uso de los datos como material de entrenamiento. Las dos líneas de defensa más sólidas que se pueden activar de inmediato son las siguientes:
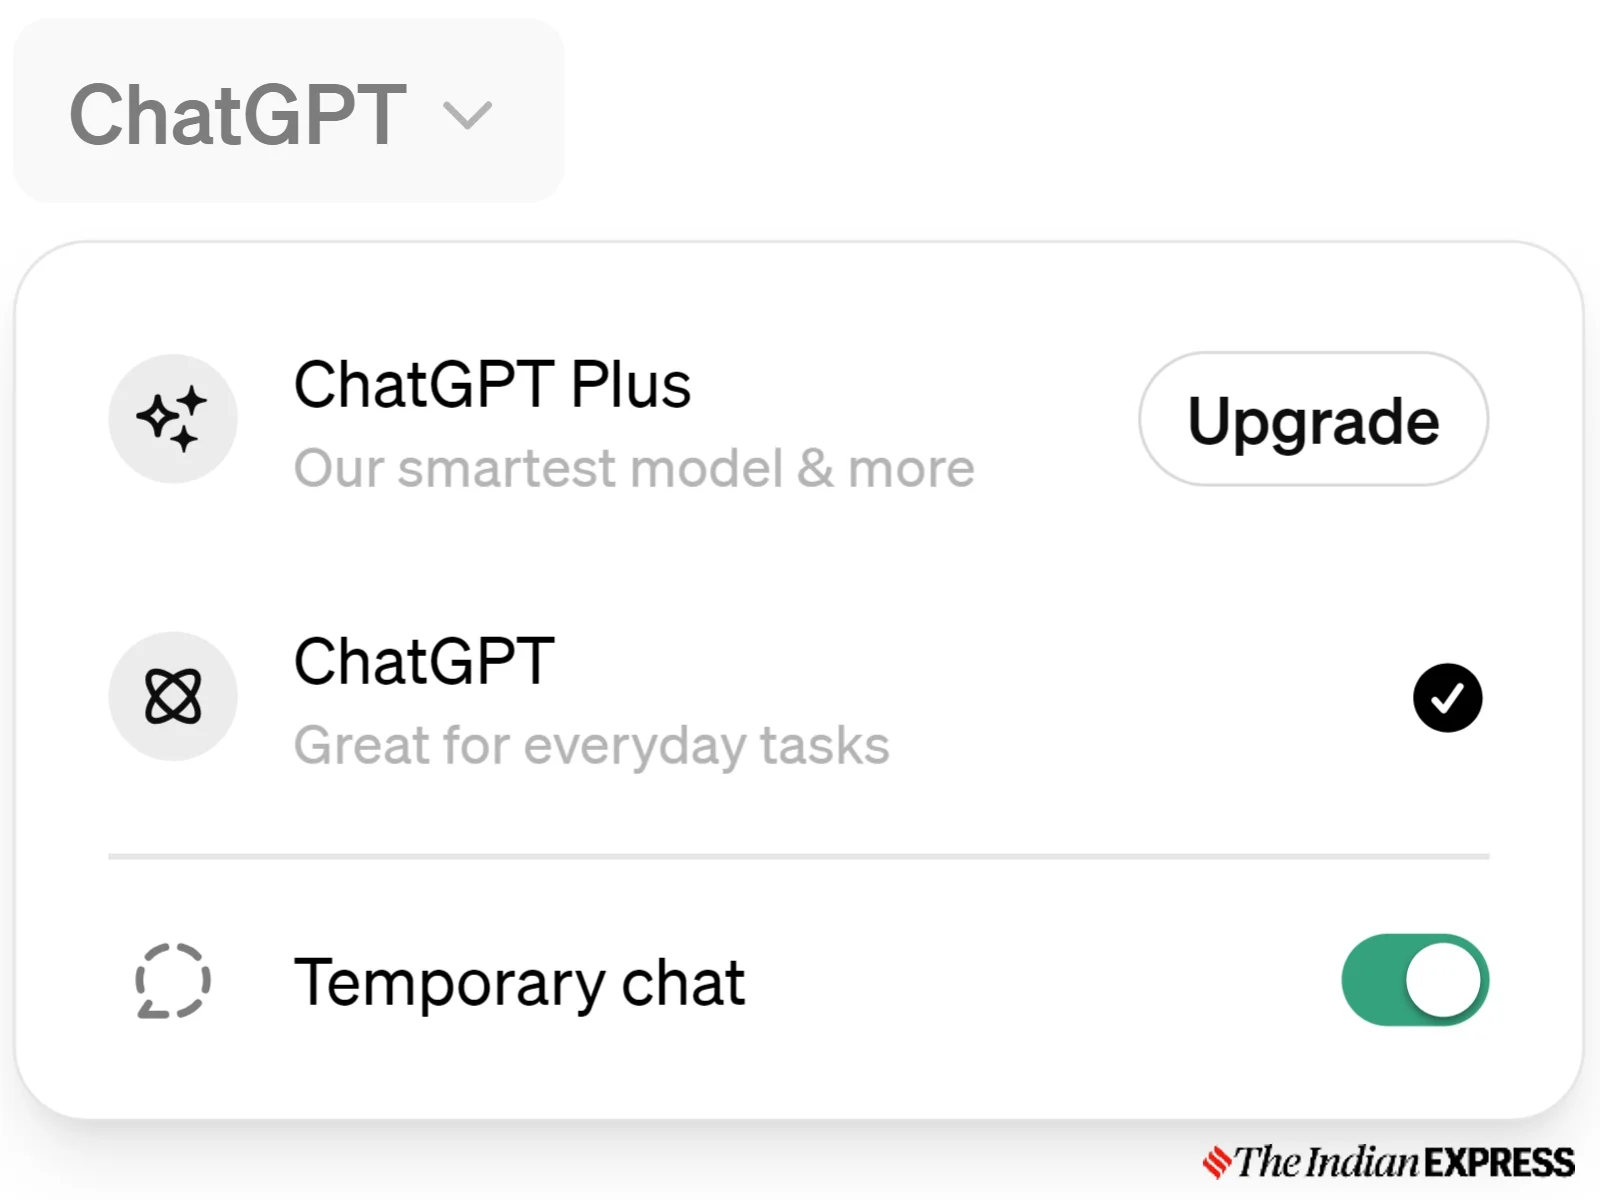
La primera es desactivar la opción «Mejora del modelo para todos» en el menú «Control de datos» de los ajustes. Al hacer esto, las conversaciones propias no se utilizarán para el entrenamiento de la IA. No obstante, debe aceptarse la compensación (trade-off) de que, con este interruptor desactivado, la IA no podrá consultar el historial de conversaciones anteriores ni tampoco guardará los nuevos intercambios. La segunda es utilizar la función de «Chat temporal» («Temporary Chat»). En el modo de chat temporal, las conversaciones no se almacenan en absoluto en los servidores y tampoco se emplean como datos de entrenamiento. Cuando se traten temas sensibles o íntimos, como el estado de salud, lo más prudente es activar el modo de chat temporal. 1
¿Por qué la IA inventa y menciona jurisprudencia y enfermedades inexistentes?
El hecho de haber configurado el entorno para que el contenido de nuestras conversaciones no quede registrado de forma insegura en los servidores no implica que debamos aceptar acriticamente las respuestas de la IA. Si se siente dolor abdominal y náuseas y pregunta «¿Tal vez fue un envenenamiento?», y la IA alega de manera verosímil la posibilidad de un «envenenamiento» recurriendo a terminología médica especializada, ¿podemos confiar en ello? Aquí es necesario comprender el fenómeno de la «alucinación» («Hallucination»). La alucinación es el fenómeno por el cual la IA genera hechos plausibles pero inexistentes, presentándolos como si fueran verdaderos.
Según la explicación del blog de la empresa Callus, la IA generativa no aprende «hechos», sino que es un modelo que «predice probabilísticamente patrones lingüísticos». Es decir, genera la oración estadísticamente más natural entre las palabras que siguen a la entrada recibida. Por ello, la IA presenta la característica de rellenar los vacíos desconocidos con suposiciones verosímiles con tal de lograr una gramática perfecta y una coherencia lógica. Dado que la IA simplemente «genera» oraciones, no las «verifica», proporciona respuestas inventadas, ya se trate de un envenenamiento o de otra enfermedad, en un tono seguro como si realmente supiera de qué habla. 2
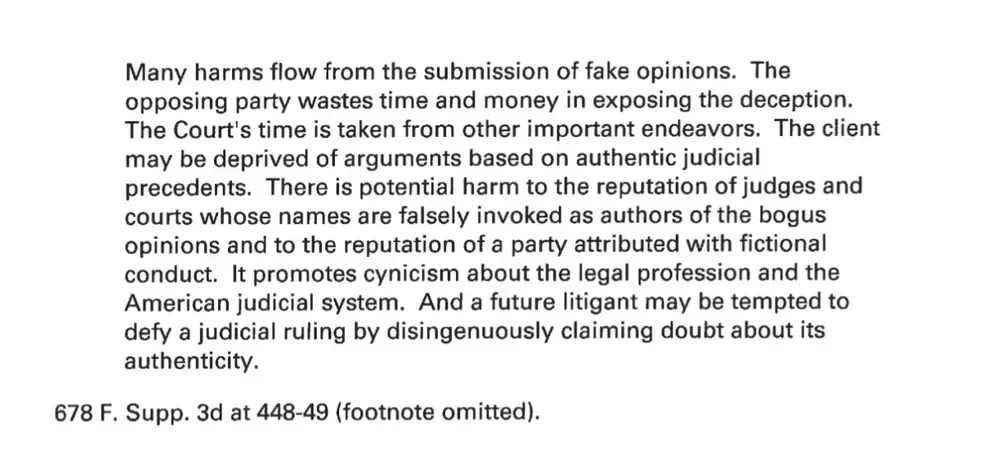
La distinción entre un tono de confianza y los hechos reales puede acarrear consecuencias graves en el mundo real. Un caso emblemático es la «sentencia Avianca» en Nueva York (EE. UU.) en 2023, mencionada por la instructora de IA ciudadana de la provincia de Gyeonggi, Hong Hye-jin, en una clase en YouTube en diciembre de 2025. En aquel momento, unos abogados encargaron a ChatGPT la investigación jurídica y presentaron en el tribunal las 6 jurisprudencias generadas por la IA. Sin embargo, dichas 6 jurisprudencias resultaron ser sentencias imaginarias que no existían. Como resultado, los abogados fueron multados con 5.000 dólares y suspendidos en el ejercicio de su profesión. 3
En los campos médico y de investigación, también se han reportado riesgos derivados de las alucinaciones. Según la instructora Hong Hye-jin, existen casos en los que la IA ha proporcionado información diagnóstica incorrecta en el ámbito médico, provocando retrasos en el tratamiento de pacientes. La propia instructora declaró que, tras organizar en formato Markdown archivos de investigación sobre decenas de artículos, solicitó las fuentes y comprobó que la IA incluía en la lista artículos que no existían. Esto significa que enfermedades inexistentes o prescripciones erróneas pueden presentarse en el formato verosímil de un informe médico. 3
Cuatro principios para conversar con la IA y utilizar la información con seguridad
¿Debemos evitar contar nuestros síntomas e intimidades a la IA por ser peligroso? No necesariamente. Si controlamos nuestro entorno para impedir que las conversaciones se filtren y tratamos las respuestas generadas por la IA no como hechos aceptados sin más, sino como un «punto de partida para la verificación», podemos usarla como una herramienta útil.
En primer lugar, hay que establecer principios para la introducción de datos personales. Las guías de seguridad recomiendan evitar ingresar directamente en la ventana de chat datos identificativos como el nombre real, números concretos de tarjetas o nombres internos de proyectos. En lugar de escribir «Mi nombre es Hong Gil-dong y estoy a cargo del proyecto ABC», conviene habitualizar la práctica de anonimizar y reformular las preguntas hacia situaciones genéricas, como «el estado de salud de una persona» o «una empresa cualquiera». La medida preventiva más segura es cambiar al modo de chat temporal para los síntomas sensibles o los secretos personales, eliminando al mismo tiempo del contenido de la pregunta cualquier dato identificativo o nombre propio. 1
El segundo principio consiste en aplicar una lista de comprobación a las «afirmaciones fácticas» concretas que la IA haya formulado. Compruebe: ▲¿La fuente citada es clara? ▲¿El contenido coincide con el original? ▲¿Se presentan cifras o evidencias específicas? ▲¿Coincide con otras fuentes o con otros modelos de IA? Una vez completado este proceso, es necesario someter la información a una revisión cruzada con un experto en la materia (médico, abogado, etc.). 3
El tercero es familiarizarse con una «rutina de verificación múltiple», que consiste en exigir a la propia IA una refutación o declarar su nivel de certeza. En lugar de preguntar simplemente «Diagnostica mis síntomas», se recomienda contrapreguntar: «¿Estás seguro de que el diagnóstico que acabas de realizar es cierto?» o «¿Existen opiniones contrarias o alternativas a este diagnóstico?». Los expertos señalan que preguntar a la IA por su nivel de certeza o solicitarle opiniones contrarias es eficaz para detectar alucinaciones. 3
El cuarto es comprender el concepto de RAG (Generación Aumentada por Recuperación / Retrieval-Augmented Generation). RAG es una arquitectura técnica que, en lugar de dejar que la IA complete vacíos mediante suposiciones probabilísticas por sí sola, le hace buscar primero en bases de datos verificadas o en documentos internos para responder basándose en esos contenidos. Aunque es un concepto utilizado principalmente en entornos empresariales, desde la perspectiva de un usuario común puede entenderse bajo la misma lógica que adquirir el «hábito de buscar y verificar directamente las respuestas de la IA en fuentes originales fiables de la web o en sitios de artículos médicos».
Como comprendimos al ver la privacidad ajena que aparecía en los resultados de búsqueda de Google en agosto de 2025, la atención meticulosa a activar y desactivar ajustes para controlar hacia dónde fluyen nuestras conversaciones es un ámbito que podemos salvaguardar nosotros mismos. Por el contrario, si el diagnóstico verosímil que emite la IA corresponde realmente a lo que sucede en nuestro cuerpo es un ámbito en el que debemos acudir directamente al hospital o consultar con expertos para verificarlo, en lugar de depender de la IA. Si no bajamos la guardia confiando excesivamente en las respuestas seguras de la IA, los modelos generativos podrán seguir ejerciendo como asesores útiles, preservando adecuadamente nuestros datos personales.
Referencias
- ↩
- 할루시네이션(Hallucination)이란? 개념부터 발생 원인, 주의사항까지 · calluscompany.com↩
- [인공지능_도민강사]홍혜진_ 생성형 AI 할루시네이션 이해와 대응전략 · youtube.com↩



