工程团队最偏好的开发节奏,是可预测的冲刺和沉稳的发布。然而,随着生成式AI发现安全漏洞的速度呈指数级加快,现有的开发计划正遭受剧烈冲击。AI在瞬间揭示了资深开发者此前未能察觉的、存在于已有数十年历史的代码库中的缺陷,导致原本用于新功能开发的资源大量转向紧急安全补丁。最终,LLM发现漏洞速度的提升已不再只是安全团队的课题,而是演变为导致项目发布延期和部署周期扭曲的结构性开发进度风险。本文将以具体案例为基础,深入分析这一变化在实际项目中的表现,以及如何在流程与流水线层面进行应对,以防止进度崩盘。
“黄金时间”的终结与开发资源的强制切换
漏洞发现速度的急剧加速,正在压缩传统软件开发生命周期(SDLC)的时间缓冲。过去,在漏洞被发现后,存在一段用于分析并准备补丁的“黄金时间”。然而,目前AI仅需10至15分钟即可发现漏洞并生成利用程序(Exploit),而企业平均补丁应用周期却从2024年的32天延长至2026年的43天 1。发现与补丁之间的这段“暴露窗口(Exposure Window)”本身已成为攻击者的主要入侵路径(占初始入侵路径的31%) 1。微软在2026年7月的例行安全补丁中公布了史上最多的570余个漏洞,加剧了系统负担,这也折射出补丁数量激增的一个侧面 1。
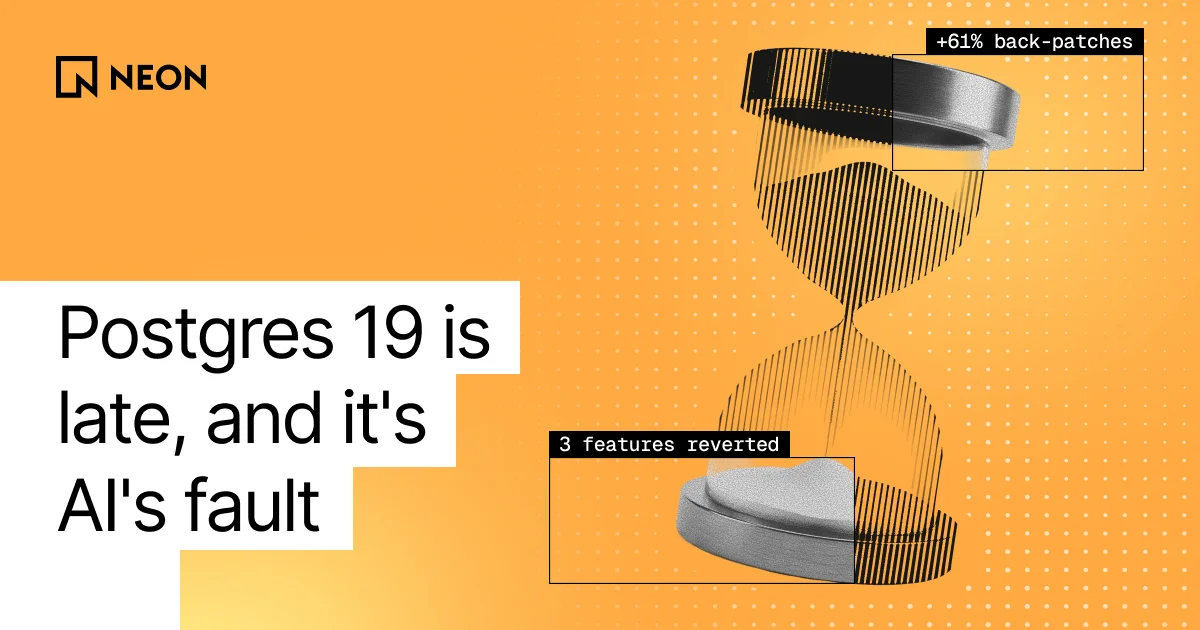
这种压力直接导致了大型开源项目发布的延迟。PostgreSQL项目在通过LLM发现大量存在了40年的隐藏bug后,合并至Master分支及稳定分支的修复(Backporting)提交数量呈爆炸式增长 2。其中,REL_19_STABLE分支从2025年4月至9月的724件激增至2026年同期的1,169件,增长超过60%;REL_18_STABLE分支则从248件激增至433件,增长超过74% 2。
| 分支 | 2025年4月至9月提交数 | 2026年4月至9月提交数 | 变化趋势 |
|---|---|---|---|
| master | 1,037 | 1,443 | 小幅增加 |
| REL_19_STABLE | 724 | 1,169 | 增长超过60% |
| REL_18_STABLE | 248 | 433 | 增长超过74% |
各PostgreSQL分支Backporting提交数对比 2
这些数据所揭示的开发进度上的致命问题在于“资源的强制切换” 2。原本应分配给v19发布版中纳入的新功能审查与测试的工程资源,被大量投入至LLM发现的既有发布版安全问题和bug修复(应对40年代码库的缺陷)中。结果,PostgreSQL 19打破了以往模式(9月至10月),延期至11月以后,并经历了主要功能(如UPDATE/DELETE FOR PORTION OF或SQL/PGQ)在8月27日至9月15日这一较晚时间点被回退的混乱局面 2。即便LLM生成了修复草案,由于像PostgreSQL这样严格遵循标准的项目,必须由人类开发者亲自审查其合规性与准确性,从而产生验证瓶颈,导致验证时间大幅增加 2。
分流(Triage)瓶颈与数据不一致
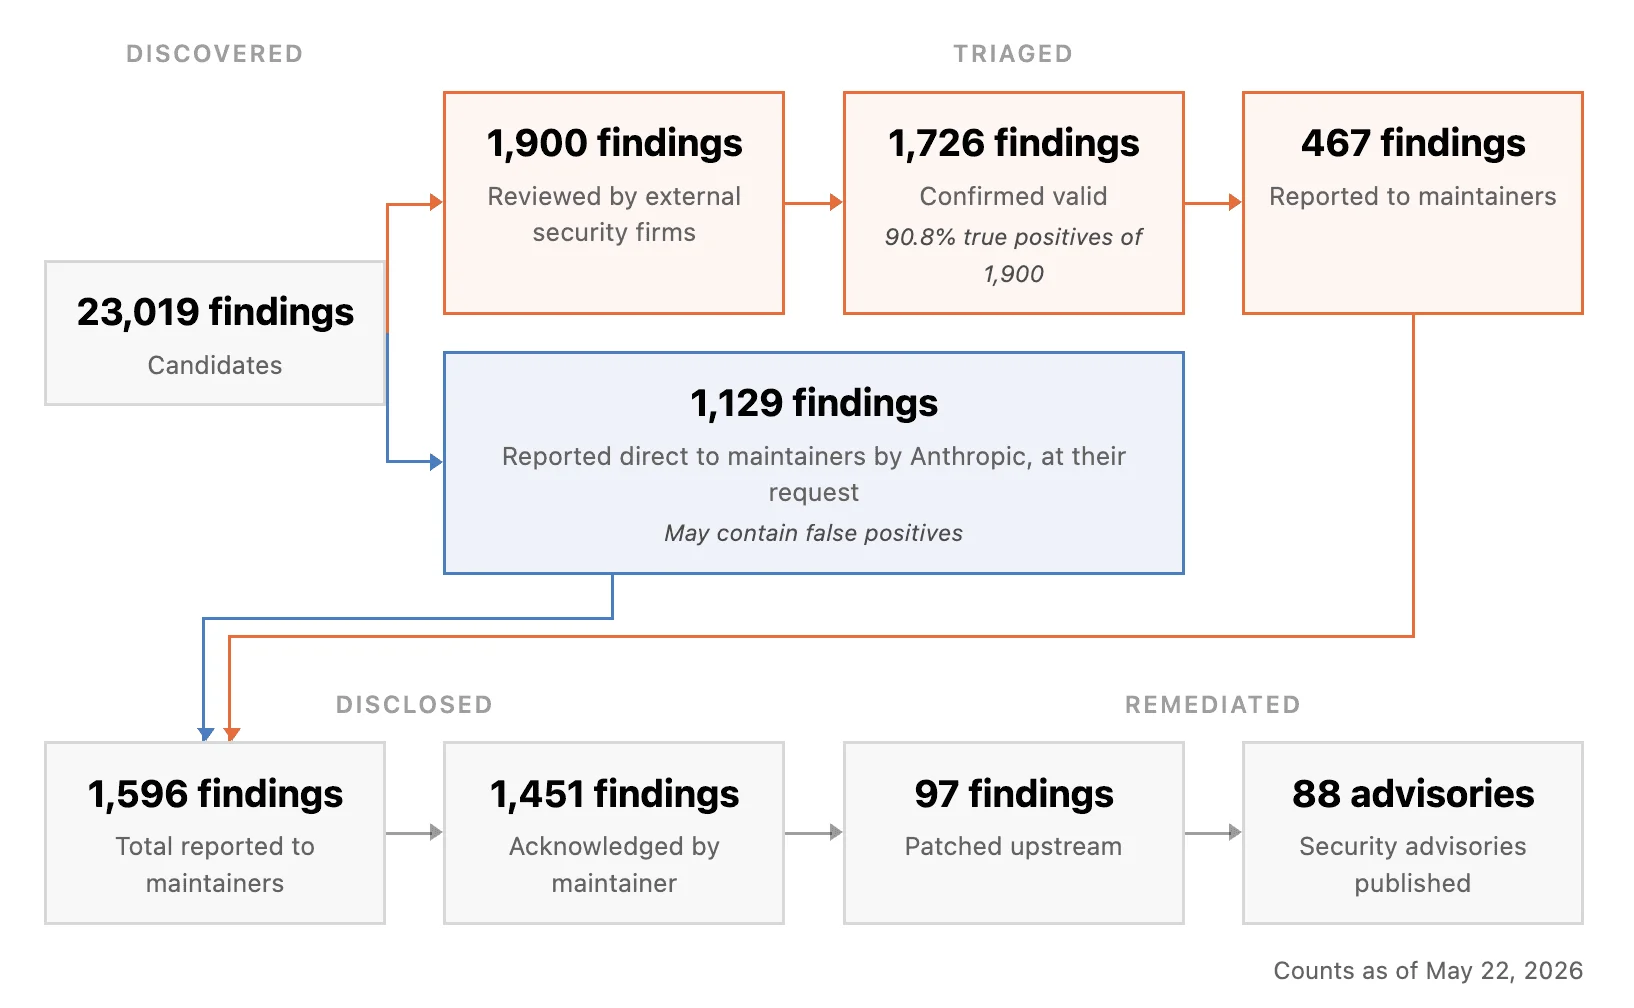
LLM发现漏洞破坏开发进度的第二个原因在于,人类判定“先修复哪个”的分流过程无法跟上自动化速度。Anthropic的Project Glasswing案例清晰地证明了这一点。在该项目中,AI在数周内自主发现了1万余个高危漏洞,但在所有发现项中,仅有9.8%能够最终传达给实际的维护人员 3。登记在册的漏洞仅占总声称数量(26,153件)的10.5%,而最终完成修复的比例仅为0.8%(202件) 3。
AI模型提出的漏洞准确度和严重性评估存在过度期待,与现场实际数据之间存在巨大差距。AI模型将91.5%的漏洞评估为“严重或高”,但实际维护人员认可的严重性比例仅为51.3% 3。在curl创始人Daniel Stenberg的案例中,AI报告的5个问题中,只有1个是实际漏洞,其余包含大量误报和非安全类bug 3。
如此这般,若将AI生成的大量未提炼漏洞报告直接投入开发进度中,工程团队将消耗既有工作资源来处理误报和非安全类bug。当出现后续数据完整性问题(如AI登记表中的上游补丁数(421件)与主登记表实际记录数(202件)不一致)时,开发者因补丁验证和重复报告处理,冲刺速度不可避免地显著降低 3。
构建验证闭环(Validation Loop)基础设施
基于AI代理的漏洞发现并非只有导致发布延期的负面。若能提前构建合适的过滤验证基础设施,反而能在保持开发团队生产力的同时,突破传统静态分析的局限。Anthropic的AI模型Claude在Mozilla Firefox中发现14个漏洞的案例印证了这一点。这是在短短两周内发现的,相当于2025年全年修复的火狐高危bug总数的约20% 4。这一成果并非单纯的演示,而是作为在实际运行环境中的成功先例载入史册。
| 测试方法 | 特点 | 深度与上下文理解能力 | 与基于AI代理的对比 |
|---|---|---|---|
| 传统Fuzzing | 覆盖范围广 | 深度较浅 | 不易发现逻辑错误 |
| 人工审查 (Manual Review) | 准确度高 | 上下文理解优异 | 速度极慢 |
| 基于代理的测试 | 速度快 | 发现逻辑/状态机错误 | 同时兼具速度与上下文理解 4 |
安全测试方法对比
传统Fuzzing虽然覆盖范围广,但深度较浅,容易遗漏逻辑错误。相比之下,基于代理的测试通过分析源代码和过往CVE数据,既能理解上下文(如识别IPC边界或Parser逻辑等攻击面),又具备快速响应能力 4。
但是,要将其吸收进开发进度中,必须经过必要的预先准备期。由于误报率处于中等水平,需构建“验证闭环(Validation Loop)”基础设施,在AddressSanitizer(ASAN)等沙箱环境中运行LLM生成的概念验证代码(PoC),自动验证是否真正产生崩溃或违规 4。误报过滤与严重性评分逻辑的调整需要2至4周的预先资源投入,若缺乏此准备,工程团队的速度将因处理误报(False Positive)而受阻 4。将初期校准期的资源投入纳入开发计划,是AI导入成功与否的关键。
将漏洞响应时间从数周缩短至48小时:自动化分流流水线
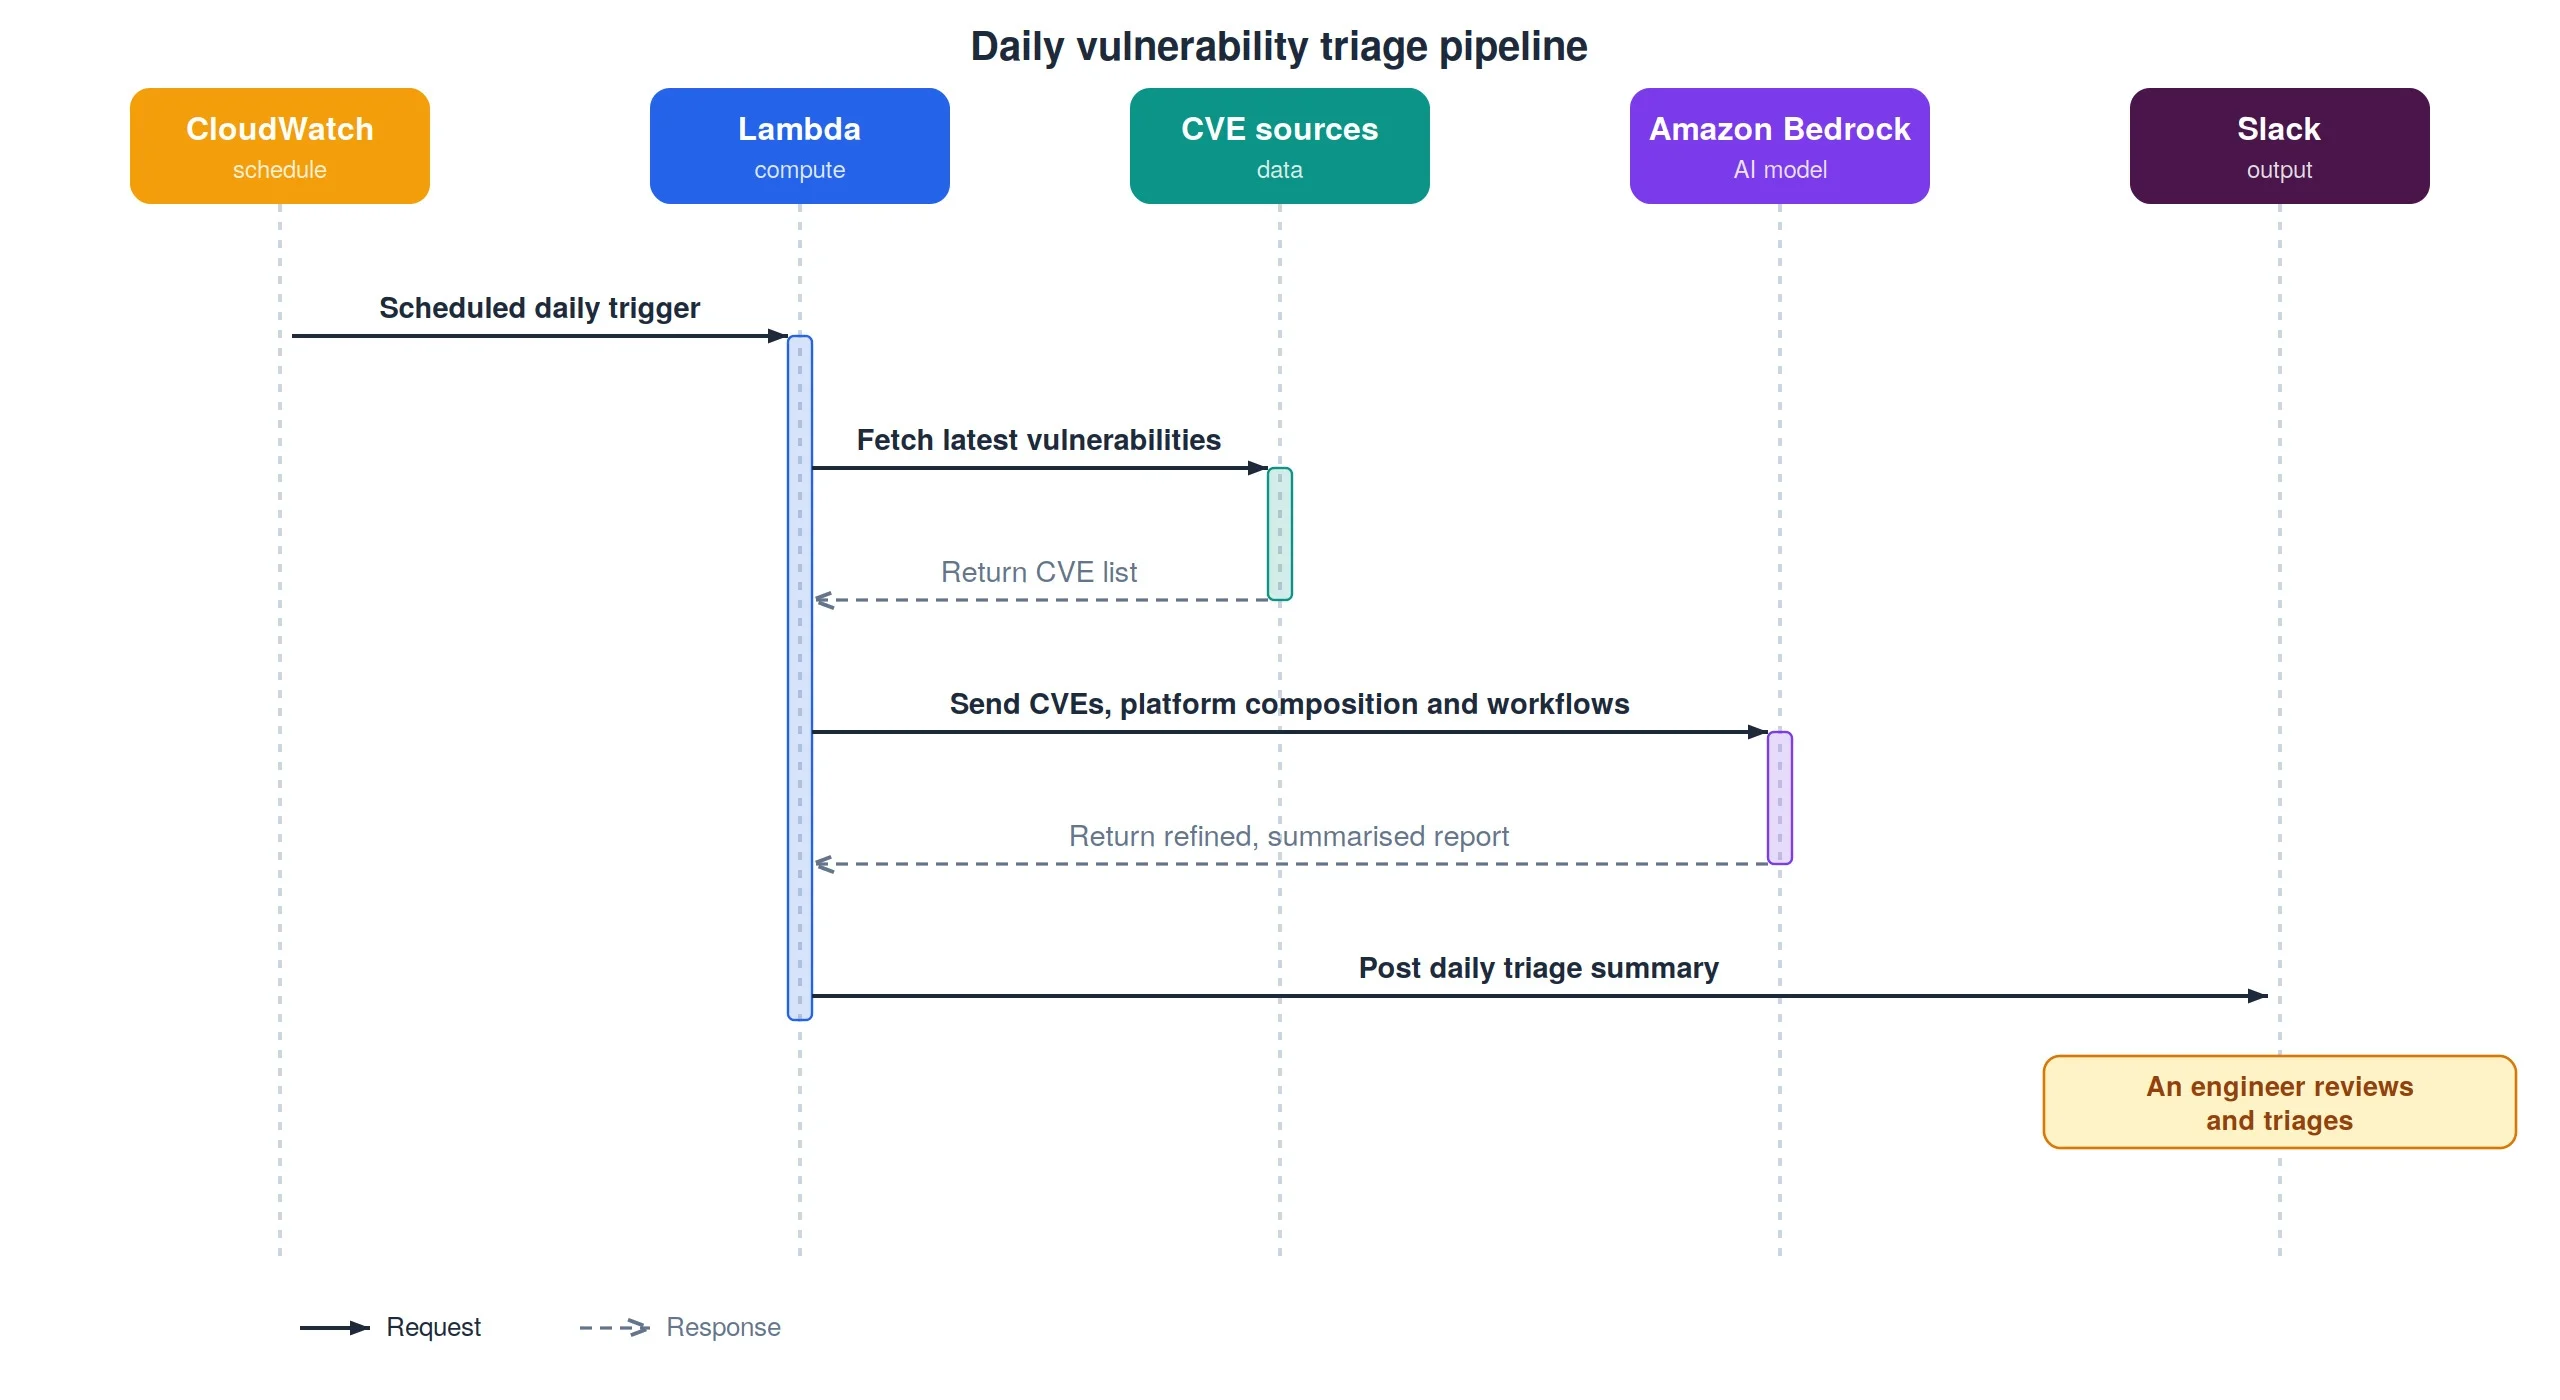
为遵守开发进度而采取的实际应对策略,是建立一种将LLM漏洞报告自动转化为“可复现的CI测试代码”而非简单Issue Ticket的流水线。某中型SaaS企业自动化AI驱动漏洞分流流水线的案例,证明了其效果。
该流水线由8个阶段构成:报告接收、规范化与去重、风险评分、CI/CD触发、自动修复、反馈闭环。特别是在利用语义嵌入与指纹哈希进行去重的阶段,重复报告减少了65% 5。在计算风险评分时,除了CVSS评分(35%)外,还将资产重要性(30%)、利用成熟度(20%)等纳入权重考量 5。
一旦计算出评分,立即会对开发进度产生影响的自动路由随之启动。当发生Critical(85分及以上)问题时,即刻生成Hotfix票单,CI/CD流水线创建 vuln-{id} 分支,注入失败的测试用例,并触发SAST/DAST及依赖扫描 5。应用该工作流的结果是,自动化引入前以“周”为单位计算的“严重问题中位修复时间”被大幅缩短至48至72小时 5。在仅让模糊或危险项接受人工审查的同时,对破坏性测试并行采用沙箱和合成数据等规则,实现了这种提速 5。
实现可持续发布的风险管理框架
LLM漏洞发现速度的提升,从根本上动摇了“完美防御”与“稳定发布”这两项开发前提。尽管发现漏洞的AI速度已达到仅需10至15分钟即可制作利用程序的水平,但企业实际补丁周期却延长至43天的现实说明,无法用人类为中心的旧流程来应对这种新型威胁 1。
工程团队负责人必须将这种新的开发节奏反映在冲刺和发布计划中。首要之举是针对Backporting提交激增导致的新功能审查延迟(如PostgreSQL 19案例),在开发日程中确保“AI分流专用资源缓冲区” 2。同时,必须将自动化的验证闭环(ASAN、沙箱)纳入CI/CD流水线,并留出2至4周的预调整期进行建设 4。对于LLM发现漏洞的严重性,不应完全依赖AI提出的评分(91.5%评估为严重),而是要通过反映资产重要性和利用成熟度的综合评分体系,构建将Critical问题的响应时间从“按月”压缩至“48至72小时”的流水线,这一时刻已经到来 315。
参考资料
- AI 보안 취약점 발견 속도, 기업 대응 시스템 추월... ‘안전 마진’ 붕괴 위기 · aeiai.net↩
- Postgres 19 is late, and it's AI's fault · rhaas.blogspot.com↩
- ↩
- ↩
- Automating Vulnerability Triage: Pipeline to Fixes · wecloud.pro↩