エンジニアリングチームが最も好む開発リズムは、予測可能なスプリントと落ち着いたリリースです。しかし、生成AIによるセキュリティ脆弱性の発見速度が飛躍的に加速するにつれ、既存の開発スケジュールは大きく揺らいでいます。AIが既存の開発者には見つけられなかった数十年分のコードベースの欠陥を一瞬で明らかにし、新機能開発に割かれていたリソースが緊急セキュリティパッチ対応へ大量にシフトする現象が生じています。結局、LLMによる脆弱性発見速度の増加は単なるセキュリティチームの課題ではなく、プロジェクトのリリース遅延やデプロイサイクルの歪みにつながる構造的な開発スケジュール上のリスクとなりました。この変化が実際のプロジェクトでどのような様相を呈するのか、そしてスケジュールの崩壊を防ぐためにワークフローやパイプラインの観点でどう対応できるかを、具体的な事例をもとに考察します。
ゴールデンタイムの消滅と開発リソースの強制転換
脆弱性発見速度の飛躍的な加速化は、従来のソフトウェア開発ライフサイクル(SDLC)における時間的余裕を圧縮しています。かつては脆弱性が発見された後、その分析やパッチ準備を行ういわゆる「ゴールデンタイム」が存在しました。しかし現在、AIは10〜15分で脆弱性を発見しエクスプロイトを生成する一方、企業の平均パッチ適用周期は2024年の32日から2026年時点で43日へとむしろ長くなる傾向にあります1。発見とパッチ適用の間に生じるこの「露出ウィンドウ(Exposure Window)」自体が、攻撃者にとっての主要な侵入経路(初期侵入経路の31%)となっているのです1。マイクロソフトが2026年7月の定例セキュリティパッチで過去最多となる570件以上の脆弱性を公開しシステム負荷を加重させたことも、こうしたパッチの爆発的増加の一端を示しています1。
こうした圧力は、実際の大型オープンソースプロジェクトのリリース遅延に直結しました。PostgreSQLプロジェクトでは、LLMを通じて40年間存在し続けてきた隠れたバグが大量に発見され、マスターブランチや安定化ブランチへマージされる修正(バックポート)コミット数が爆発的に増加しました2。REL_19_STABLEブランチの場合、2025年4〜9月の724件から2026年同期間は1,169件へと60%以上、REL_18_STABLEブランチは248件から433件へと74%以上急増しました2。
| ブランチ | 2025年4〜9月のコミット数 | 2026年4〜9月のコミット数 | 変化の傾向 |
|---|---|---|---|
| master | 1,037 | 1,443 | 小幅な増加 |
| REL_19_STABLE | 724 | 1,169 | 60%以上の急増 |
| REL_18_STABLE | 248 | 433 | 74%以上の急増 |
PostgreSQLブランチ別バックポートコミット数比較 2
こうしたデータが示す開発スケジュール上の致命的な問題は、「リソースの強制転換」です2。元来v19リリースに含まれる新機能のレビューやテストに割り当てられるべきであったエンジニアリングリソースが、LLMが発見した既存リリースのセキュリティ問題およびバグ修正(40年分のコードベースの欠陥対応)に投入されてしまったのです。その結果、PostgreSQL 19は従来のパターン(9〜10月)から外れ11月以降へ遅延し、UPDATE/DELETE FOR PORTION OFやSQL/PGQといった主要機能が8月27日〜9月15日という遅い時期に巻き戻るという混乱を招きました2。LLMによる修正ドラフトが出ても、PostgreSQLのような標準準拠性の有無や正確性については人間開発者が直接検証する必要があり、検証時間に大幅なボトルネックが生じているためです2。
トライアージ(Triage)のボトルネックとデータ不整合
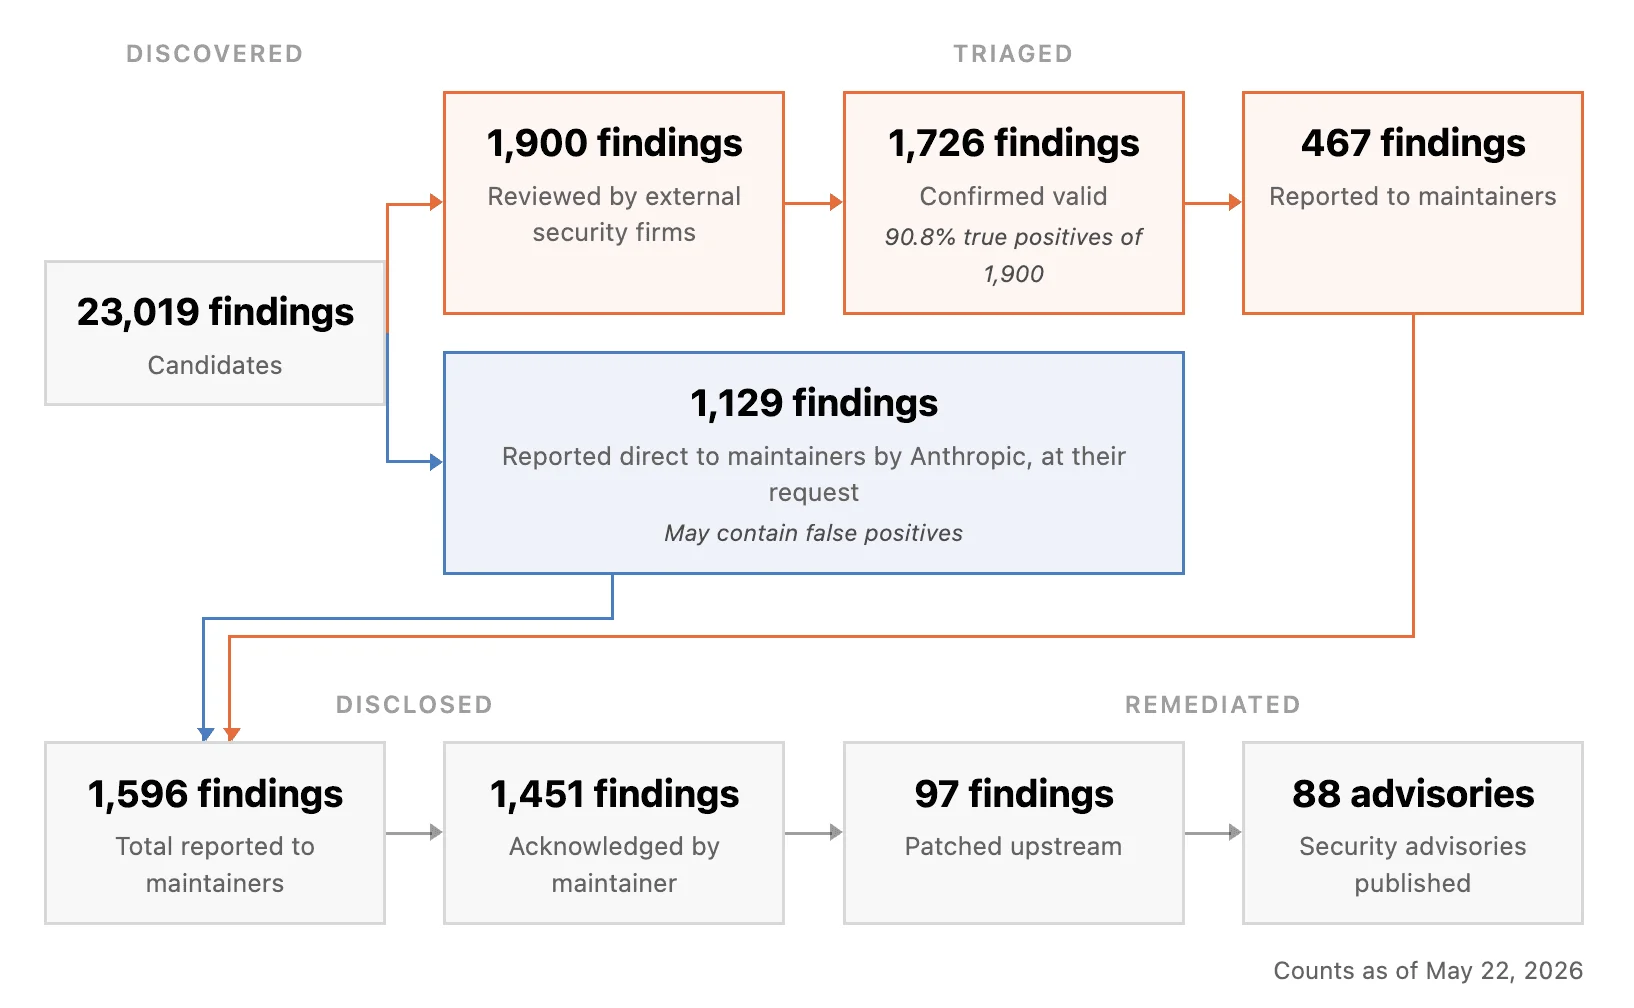
LLMによる脆弱性発見が開発スケジュールを崩壊させる2つ目の理由は、発見された脆弱性を「どこから手をつけるべきか」を見極める人間のトライアージ工程が、自動化のスピードに追いついていないためです。AnthropicのProject Glasswingの事例がこれを明確に示しています。このプロジェクトでは、AIが数週間で1万件以上の高リスク脆弱性を自律的に発見しましたが、全発見件数のうちわずか9.8%のみが実際のメンテナンス担当者に渡すことができました3。台帳に登録された脆弱性は全主張件数(2万6153件)に対し10.5%にとどまり、最終的に修正まで完了した割合はわずか0.8%(202件)でした3。
AIモデルが提示する脆弱性の精度や深刻度の評価に対する過剰な期待と、実際の現場のデータとの間にも大きな不整合が存在します。AIモデルは脆弱性の91.5%を「致命的または高」と評価した一方、実際のメンテナンス担当者が同意した深刻度の割合は51.3%にとどまりました3。curlの創始者Daniel Stenbergの事例では、AIが報告した5件のうち実際の脆弱性は1件だけで、多数の誤検知や非セキュリティバグが含まれる傾向が見られました3。
このように、AIが生成した大量の脆弱性レポートを未精製のまま開発スケジュールに投入すると、エンジニアリングチームは誤検知や非セキュリティバグの処理に既存の業務リソースを費やすことになります。AI台帳データのアップストリームパッチ件数(421件)と実際のメイン台帳記録(202件)が一致しないといった後続のデータ整合性問題が生じると、開発者はパッチ検証や重複レポート処理によりスプリントの速度が顕著に低下せざるを得ません3。
検証ループ(Validation Loop)インフラの構築
AIエージェントによる脆弱性発見は、リリース遅延の原因だけではありません。これを適切にフィルタリングできる検証インフラを事前に構築すれば、むしろ開発チームの生産性を維持しつつ、既存の静的分析の限界を突破できます。AnthropicのAIモデルClaudeがMozilla Firefoxの脆弱性14件を発見した事例がこれを証明しています。これはわずか2週間で発見されたもので、2025年1年間で修正されたFirefoxの高危険度バグ全体の約20%に相当する量です4。単なるデモではなく、実際の運用環境での成功事例として記録されました。
| テスト手法 | 特徴 | 深さ / コンテキスト理解力 | AIエージェントベースとの比較 |
|---|---|---|---|
| 従来型ファジング(Fuzzing) | 範囲が広い | 深さが浅い | ロジックエラー検知に弱い |
| 手動レビュー(Manual Review) | 精度が高い | コンテキスト理解に優れる | 速度が非常に遅い |
| エージェントベーステスト | 速度が速い | ロジック / ステートマシンエラーの発見 | 速度とコンテキストの同時確保4 |
セキュリティテストのアプローチ比較
従来型ファジングは範囲が広いために深さが浅くなり、ロジックエラーを見逃しがちです。一方、エージェントベーステストはソースコードと過去のCVEデータを分析してIPC境界やパーサーロジックといった攻撃表面を識別するコンテキスト理解力と、迅速な速度を同時に提供します4。
ただし、これを開発スケジュールに吸収するためには、不可欠な事前準備期間が求められます。中程度の誤検知率が見られるため、LLMが生成した概念実証コード(PoC)をAddressSanitizer(ASAN)などのサンドボックス環境で実行し、実際のクラッシュや違反が発生するかを自動検証する「検証ループ(Validation Loop)」インフラの構築が必要です4。この誤検知フィルタリングや深刻度スコアリングロジックのチューニングには、事前に2〜4週間のリソース投入が必要であり、これを用意しないと誤検知(false positive)処理でエンジニアリングチームの速度が制約されてしまいます4。初期校正期間のリソース投資を開発スケジュールに組み込むことが、AI導入の成否を分ける鍵となります。
脆弱性対応時間を数週間から48時間に:自動化されたトライアージパイプライン
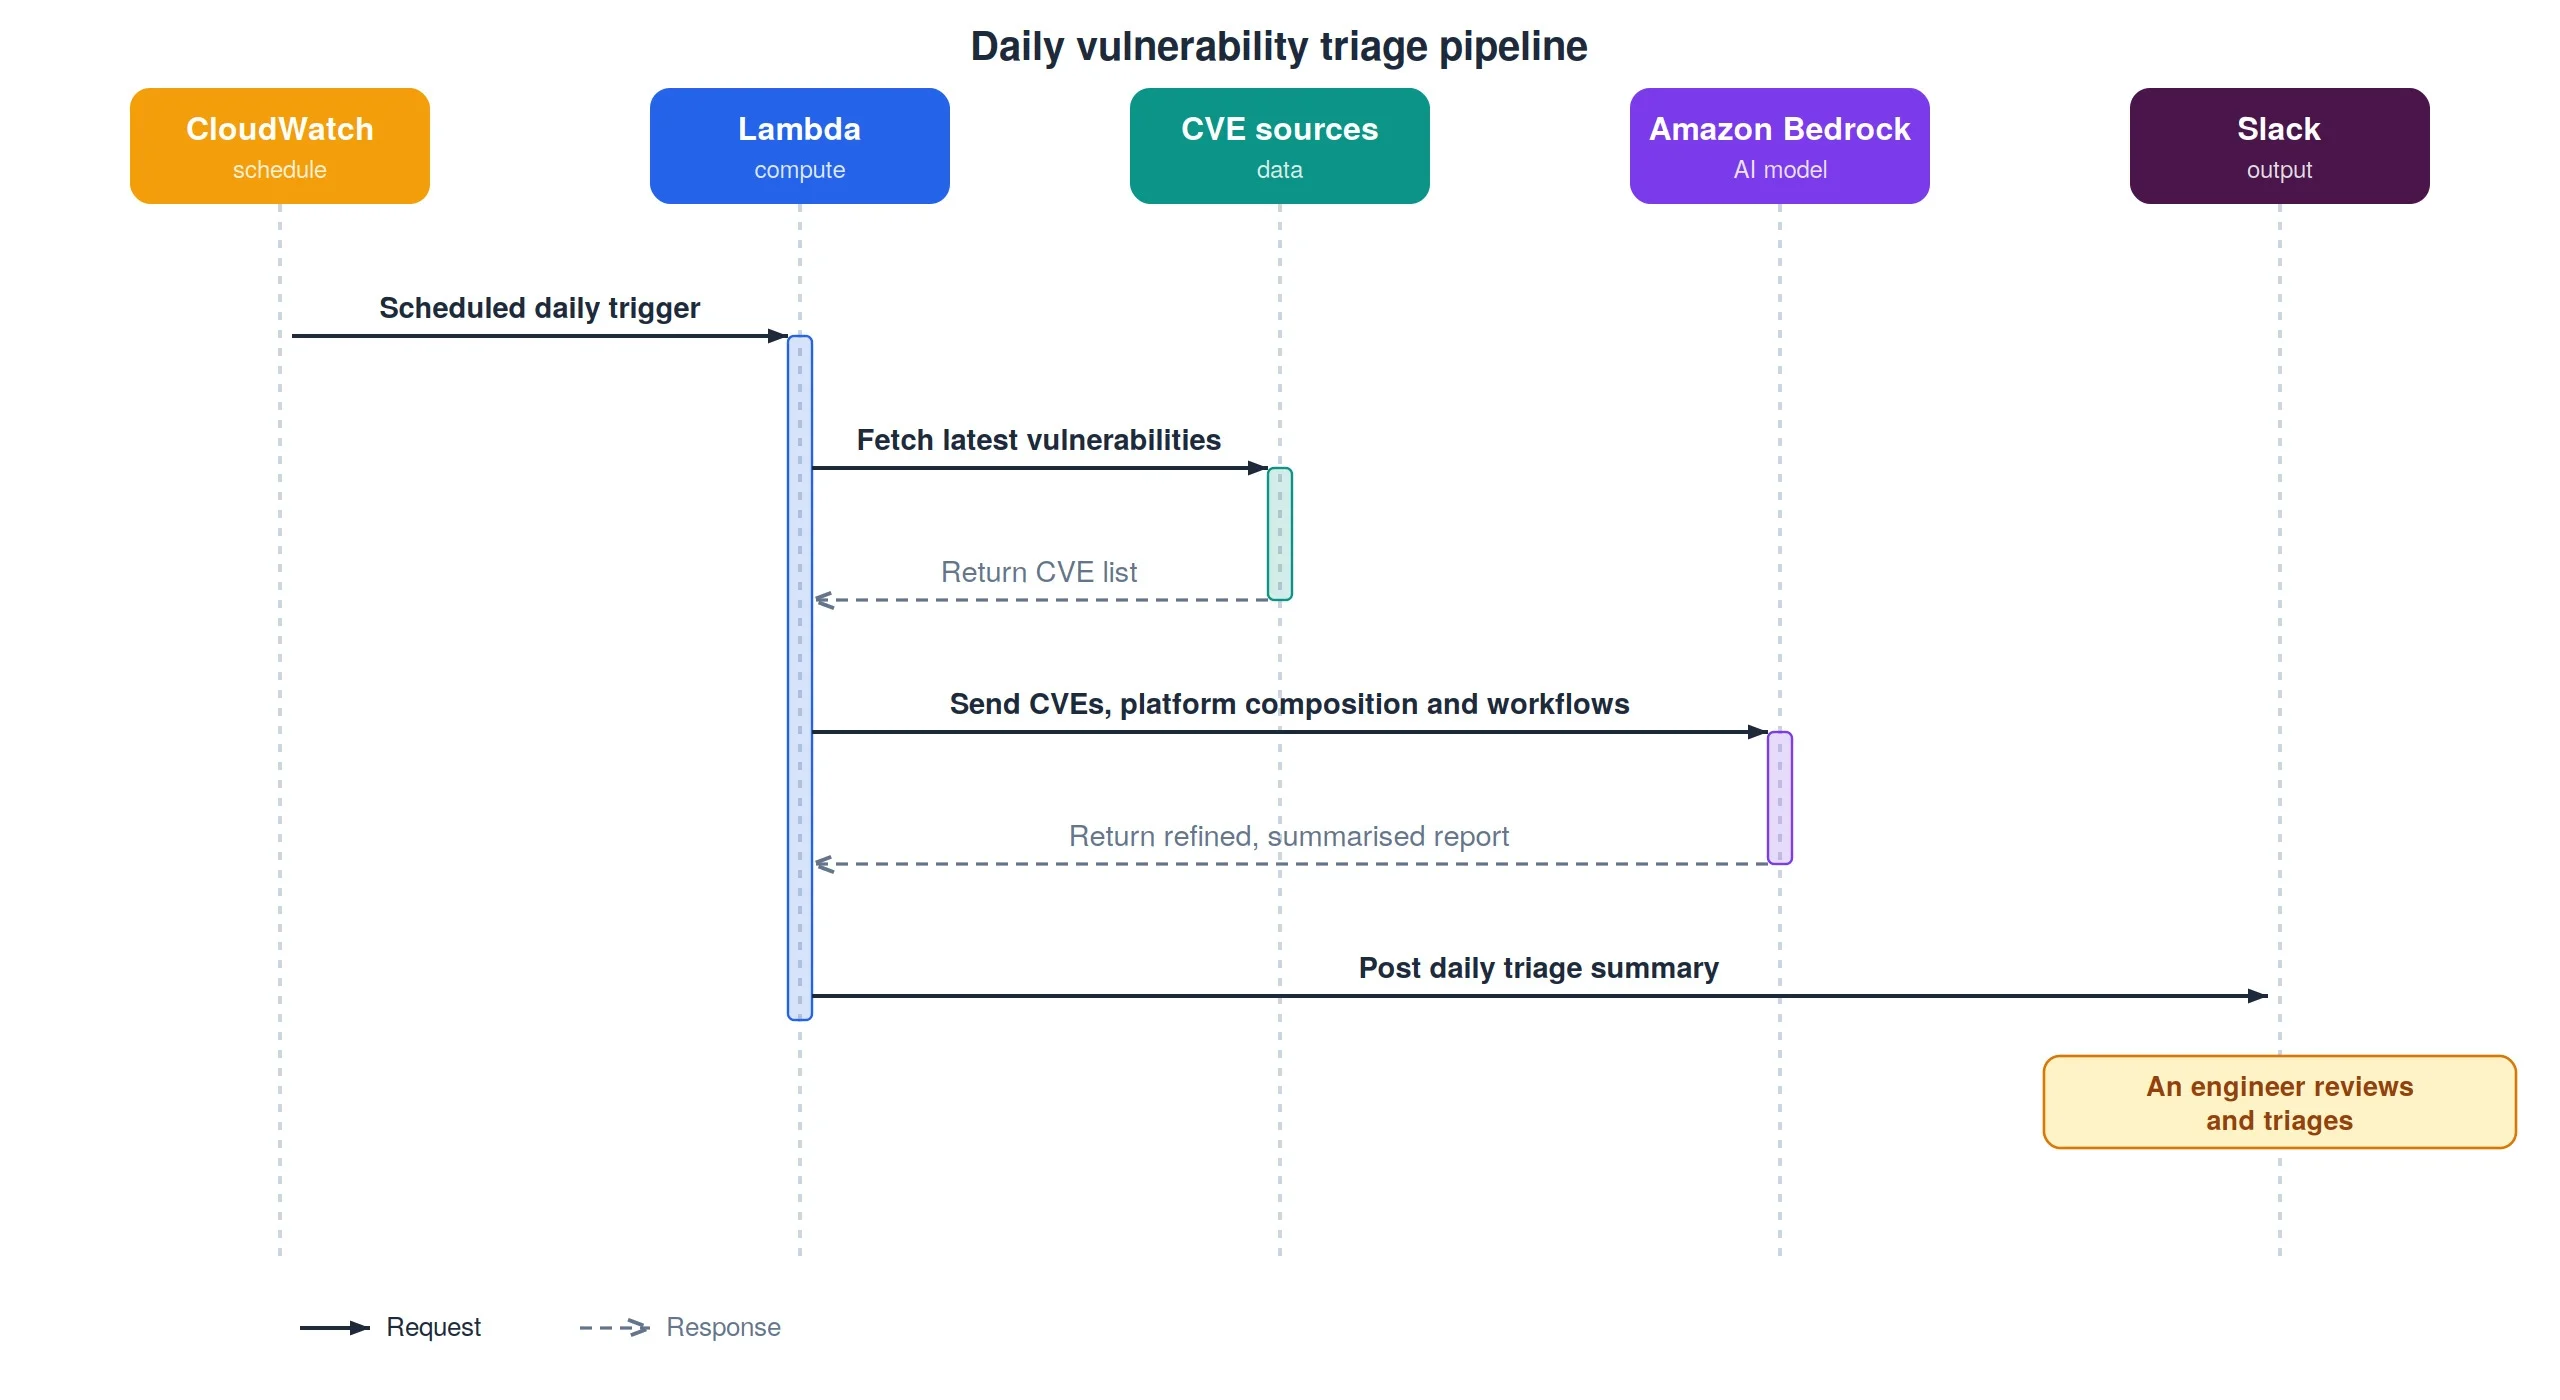
開発スケジュールを守るための実効的な対応戦略は、LLMによる脆弱性レポートを単なるイシューチケットではなく「再現可能なCIテストコード」へ自動的に変換するパイプラインを構築することです。中堅SaaS企業でAIベースの脆弱性トライアージパイプラインを自動化した事例が、その効果を立証しています。
このパイプラインは、レポート受付、正規化および重複除去、リスクスコアリング、CI/CDトリガー、自動修正、フィードバックループの8段階で設計されました。特に、セマンティック埋め込みとフィンガープリントハッシュを活用した重複除去工程を経て、重複レポートを65%削減しました5。リスクスコアの算出時には、CVSSスコア(35%)に加えて、資産重要度(30%)、エクスプロイト成熟度(20%)などを重み付けとして考慮します5。
スコアが算出されると、開発スケジュールに即時影響を与える自動ルーティングが行われます。Critical(85点以上)のイシューが発生すると、直ちにホットフィックスチケットが作成され、CI/CDパイプラインはvuln-{id}ブランチを作成して失敗するテストケースを注入し、SAST/DASTおよび依存性スキャンをトリガーします5。このワークフローを適用した結果、自動化導入前には数週間単位の長さであった「致命的(Critical)イシューの中央値修正時間」が48〜72時間へと大幅に短縮されました5。曖昧または危険な項目のみ人間のレビューを経由させ、破壊的テストはサンドボックスと合成データを使用させるルールを併用することが、こうした速度向上を可能にしました5。
持続可能なリリースのためのリスク管理フレームワーク
LLMによる脆弱性発見速度の増加は、「完全な防御」と「安定したリリース」という開発の前提を根底から揺るがしています。脆弱性を発見するAIの速度は10〜15分でエクスプロイトを生成する水準に達しましたが、実際の企業のパッチ周期が43日に延長している現実は、この新たな脅威を人間中心の過去のプロセスで対応することは不可能であることを物語っています1。
エンジニアリングチームのリーダーは、この新しい開発リズムをスプリントやリリーススケジュールに反映させる必要があります。まず、バックポートコミットの急増による新機能レビュー遅延(例:PostgreSQL 19)に備え、開発スケジュールに「AIトライアージ専用リソースバッファ」を確保しなければなりません2。同時に、自動化された検証ループ(ASAN、サンドボックス)をCI/CDパイプラインに2〜4週間の事前チューニング期間を設けて構築する必要があります4。LLMが発見した脆弱性の深刻度について、AIが提示するスコア(91.5%が致命的と評価)に全面的に依存せず、資産重要度やエクスプロイト成熟度を反映した複合的なスコアリング体系を通じて、Criticalイシューの対応時間を「月単位から48〜72時間」へと圧縮するパイプラインが求められる時代です315。
参考文献
- AI 보안 취약점 발견 속도, 기업 대응 시스템 추월... ‘안전 마진’ 붕괴 위기 · aeiai.net↩
- Postgres 19 is late, and it's AI's fault · rhaas.blogspot.com↩
- ↩
- ↩
- Automating Vulnerability Triage: Pipeline to Fixes · wecloud.pro↩