Los ritmos de desarrollo preferidos por los equipos de ingeniería son los sprints predecibles y los lanzamientos tranquilos. Sin embargo, a medida que la velocidad con la que la IA generativa encuentra vulnerabilidades de seguridad aumenta de manera exponencial, los cronogramas de desarrollo existentes se están viendo sacudidos de manera abrupta. Dado que la IA revela al instante defectos en bases de código de décadas que los desarrolladores no habían descubierto, se está produciendo un fenómeno en el que los recursos destinados al desarrollo de nuevas funciones se trasladan masivamente hacia parches de seguridad urgentes. En definitiva, el aumento en la velocidad de detección de vulnerabilidades por parte de los LLM se ha convertido no solo en un reto para los equipos de seguridad, sino en un riesgo estructural para los cronogramas de desarrollo que conlleva retrasos en los lanzamientos de proyectos y distorsiones en los ciclos de despliegue. Analizamos cómo se manifiesta este cambio en proyectos reales y cómo se puede responder a nivel de flujos de trabajo y pipelines para evitar el colapso de los cronogramas, basándonos en casos concretos.
La desaparición del «golden time» y el cambio forzoso de los recursos de desarrollo
La aceleración drástica en la velocidad de descubrimiento de vulnerabilidades está comprimiendo los márgenes temporales tradicionales del ciclo de vida del desarrollo de software (SDLC). En el pasado, existía lo que se conoce como «golden time», un periodo tras la detección de una vulnerabilidad para analizarla y preparar su parche. No obstante, actualmente la IA encuentra vulnerabilidades y genera exploits en tan solo 10-15 minutos, mientras que el ciclo medio de aplicación de parches en las empresas se ha alargado, pasando de 32 días en 2024 a 43 días según los datos de 2026 1. Esta «ventana de exposición» entre el descubrimiento y el parche se ha convertido en una vía principal de intrusión para los atacantes (31% de las rutas de acceso inicial) 1. Microsoft también ilustra esta faceta de la explosión de parches al revelar en su actualización de seguridad mensual de julio de 2026 más de 570 vulnerabilidades, una cifra récord que agravó la carga sobre los sistemas 1.
Estas presiones han conducido directamente a retrasos en los lanzamientos de importantes proyectos de código abierto. En el proyecto PostgreSQL, tras descubrirse en masa mediante LLM errores ocultos que llevaban 40 años presentes, se produjo un aumento explosivo en el número de commits de corrección (backporting) fusionados en las ramas master y de estabilización 2. En el caso de la rama REL_19_STABLE, el número pasó de 724 en el periodo de abril a septiembre de 2025 a 1.169 en el mismo periodo de 2026, un incremento superior al 60%; la rama REL_18_STABLE aumentó de 248 a 433, un salto superior al 74% 2.
| Rama | Commits (abr-sep 2025) | Commits (abr-sep 2026) | Tendencia |
|---|---|---|---|
| master | 1.037 | 1.443 | Ligero aumento |
| REL_19_STABLE | 724 | 1.169 | Aumento superior al 60% |
| REL_18_STABLE | 248 | 433 | Aumento superior al 74% |
Comparación de commits de backporting por rama en PostgreSQL 2
El problema crítico en los cronogramas de desarrollo que sugieren estos datos es el «cambio forzoso de recursos» 2. Los recursos de ingeniería que debían haberse asignado a la revisión y pruebas de nuevas funciones para el lanzamiento v19 fueron destinados a la corrección de problemas de seguridad y errores en las versiones existentes detectados por los LLM (resolución de defectos de una base de código de 40 años). Como resultado, PostgreSQL 19 se retrasó hasta más allá de noviembre, saliendo del patrón habitual (septiembre-octubre), y sufrió confusión al revertirse funciones clave como UPDATE/DELETE FOR PORTION OF y SQL/PGQ en fechas tardías, entre el 27 de agosto y el 15 de septiembre 2. Esto se debió a que, aunque los LLM generan propuestas de corrección, surge un cuello de botella porque los desarrolladores humanos deben revisar directamente el cumplimiento de estándares y la precisión en casos como PostgreSQL, lo que ha aumentado drásticamente los tiempos de validación 2.
Cuello de botella en la triage y discrepancias en los datos
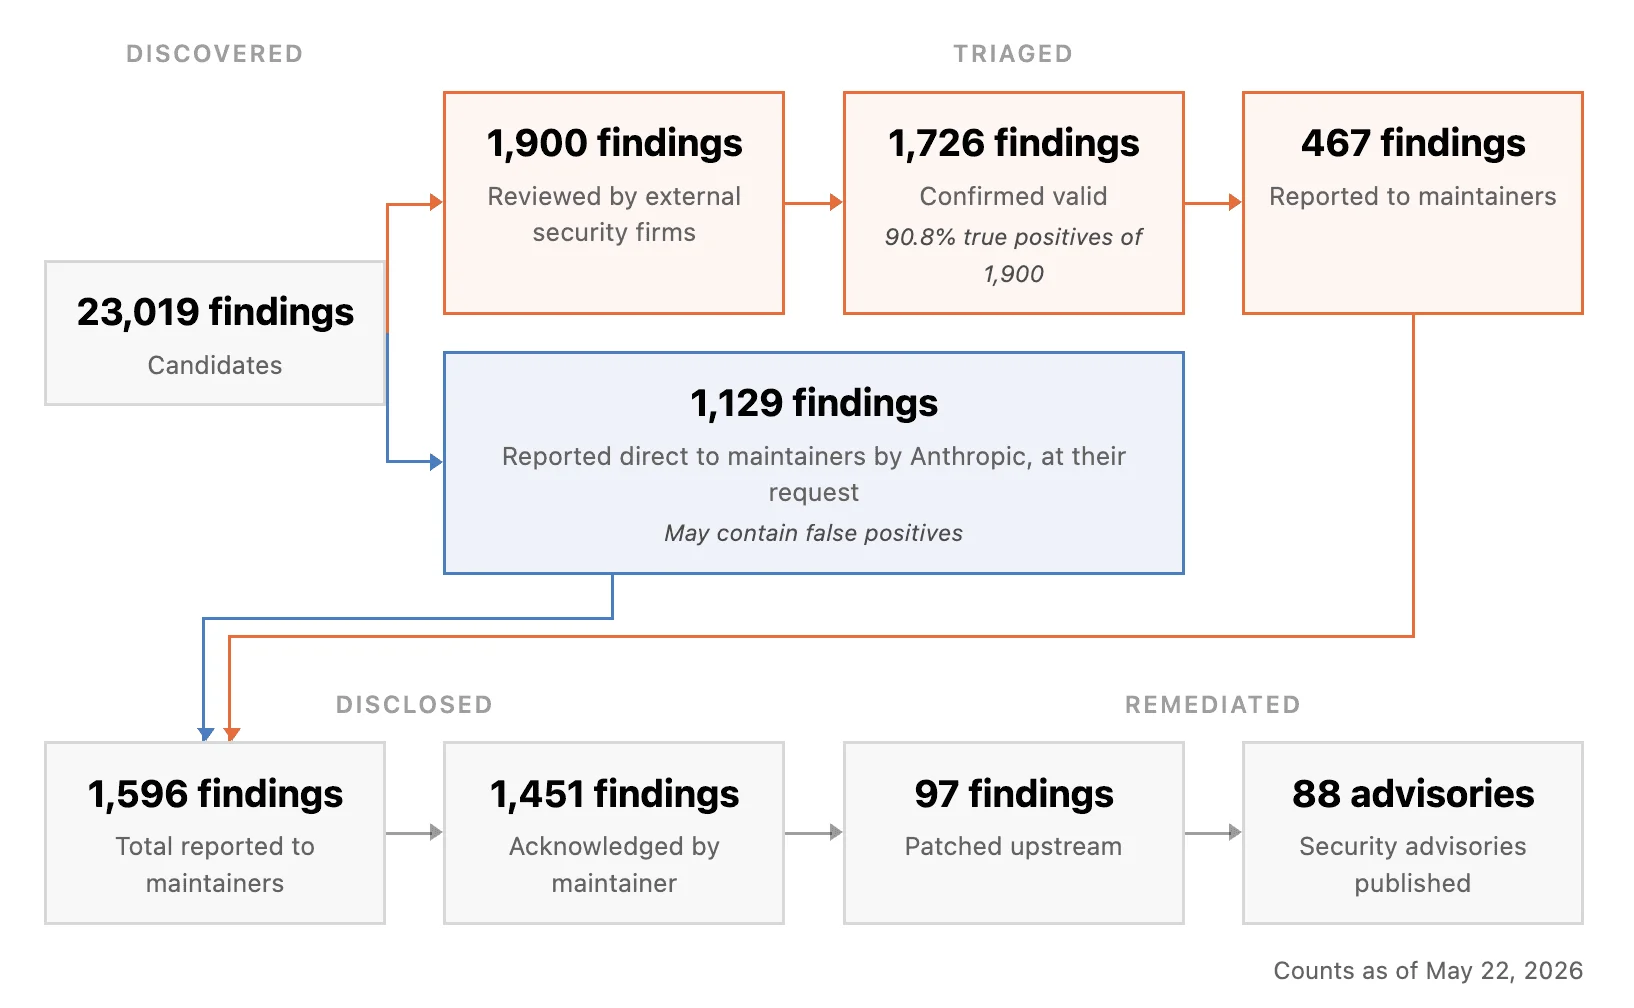
La segunda razón por la que el descubrimiento de vulnerabilidades mediante LLM colapsa los cronogramas de desarrollo es que el proceso humano de triage, que determina «por dónde empezar a corregir» las vulnerabilidades encontradas, no logra seguir el ritmo de la automatización. El caso del Project Glasswing de Anthropic lo demuestra claramente. En este proyecto, la IA descubrió de forma autónoma más de 10.000 vulnerabilidades de alto riesgo en cuestión de semanas, pero solo el 9,8% del total de hallazgos pudo llegar finalmente a los mantenedores 3. Las vulnerabilidades registradas en el inventario representaban apenas el 10,5% del total de informes (26.153), y la proporción finalmente corregida fue de tan solo el 0,8% (202 casos) 3.
Existe además una gran discrepancia entre las expectativas excesivas sobre la precisión y la evaluación de la gravedad de las vulnerabilidades propuestas por los modelos de IA y los datos reales del terreno. Mientras que los modelos de IA calificaron el 91,5% de las vulnerabilidades como «críticas o altas», la proporción de gravedad con la que estuvieron de acuerdo los mantenedores reales fue de solo el 51,3% 3. En el caso de Daniel Stenberg, creador de curl, entre los 5 informes hechos por la IA solo 1 era una vulnerabilidad real, mostrándose un patrón donde incluían numerosos errores falsos y bugs no relacionados con seguridad 3.
De este modo, si se incorporan al cronograma de desarrollo la enorme cantidad de informes de vulnerabilidades generadas por la IA sin refinar, los equipos de ingeniería consumen sus recursos habituales tratando falsos positivos y bugs no relacionados con la seguridad. Si surgen problemas de consistencia de datos posteriores, como la discrepancia entre los 421 parches registrados en el inventario de datos de la IA y los 202 registros reales del inventario principal, la velocidad de los sprints de los desarrolladores se ralentizará notablemente debido a la validación de parches y al tratamiento de informes duplicados 3.
Construcción de una infraestructura de ciclo de validación (Validation Loop)
El descubrimiento de vulnerabilidades basado en agentes de IA no es únicamente la causa de los retrasos en los lanzamientos. Si se construye previamente una infraestructura de validación que los filtre adecuadamente, es posible mantener la productividad de los equipos de desarrollo y superar los límites del análisis estático tradicional. El caso en que el modelo de IA de Anthropic, Claude, descubrió 14 vulnerabilidades en Mozilla Firefox lo demuestra. Estos hallazgos se produjeron en un breve periodo de 2 semanas, equivalentes a aproximadamente el 20% de la totalidad de los bugs de alto riesgo corregidos en Firefox durante todo el año 2025 4. Quedó registrado como un caso exitoso no de una simple demostración, sino en un entorno operativo real.
| Método de prueba | Características | Profundidad / Comprensión del contexto | Comparación con la base en agentes de IA |
|---|---|---|---|
| Fuzzing tradicional | Amplio alcance | Profundidad baja | Vulnerable ante errores lógicos |
| Revisión manual | Alta precisión | Excelente comprensión del contexto | Muy lento |
| Pruebas basadas en agentes | Rápido | Detección de errores lógicos/y de máquinas de estados | Velocidad + contexto simultáneamente 4 |
Comparación de enfoques de pruebas de seguridad
El fuzzing tradicional, pese a su amplio alcance, tiene poca profundidad y es fácil que pase por alto errores lógicos. En cambio, las pruebas basadas en agentes proporcionan simultáneamente comprensión contextual al analizar el código fuente y datos históricos de CVE para identificar superficies de ataque como fronteras IPC o lógica de analizadores, junto con rapidez 4.
No obstante, para absorberlo en el cronograma de desarrollo, se requiere un periodo previo de preparación indispensable. Debido a que muestra una tasa media de falsos positivos, es necesario construir una infraestructura de «ciclo de validación» que ejecute automáticamente en entornos sandbox, como AddressSanitizer (ASAN), el código de prueba de concepto (PoC) generado por el LLM para verificar si se producen fallos reales o violaciones 4. Ajustar esta lógica de filtrado de falsos positivos y puntuación de la gravedad requiere recursos previos durante 2-4 semanas, y si no se prepara, la velocidad del equipo de ingeniería se estancará en el tratamiento de los falsos positivos 4. Reflejar en el cronograma de desarrollo la inversión de recursos durante el periodo inicial de calibración es la clave que decide el éxito o fracaso de la adopción de la IA.
De semanas a 48 horas en el tiempo de respuesta a vulnerabilidades: pipelines de triage automatizados
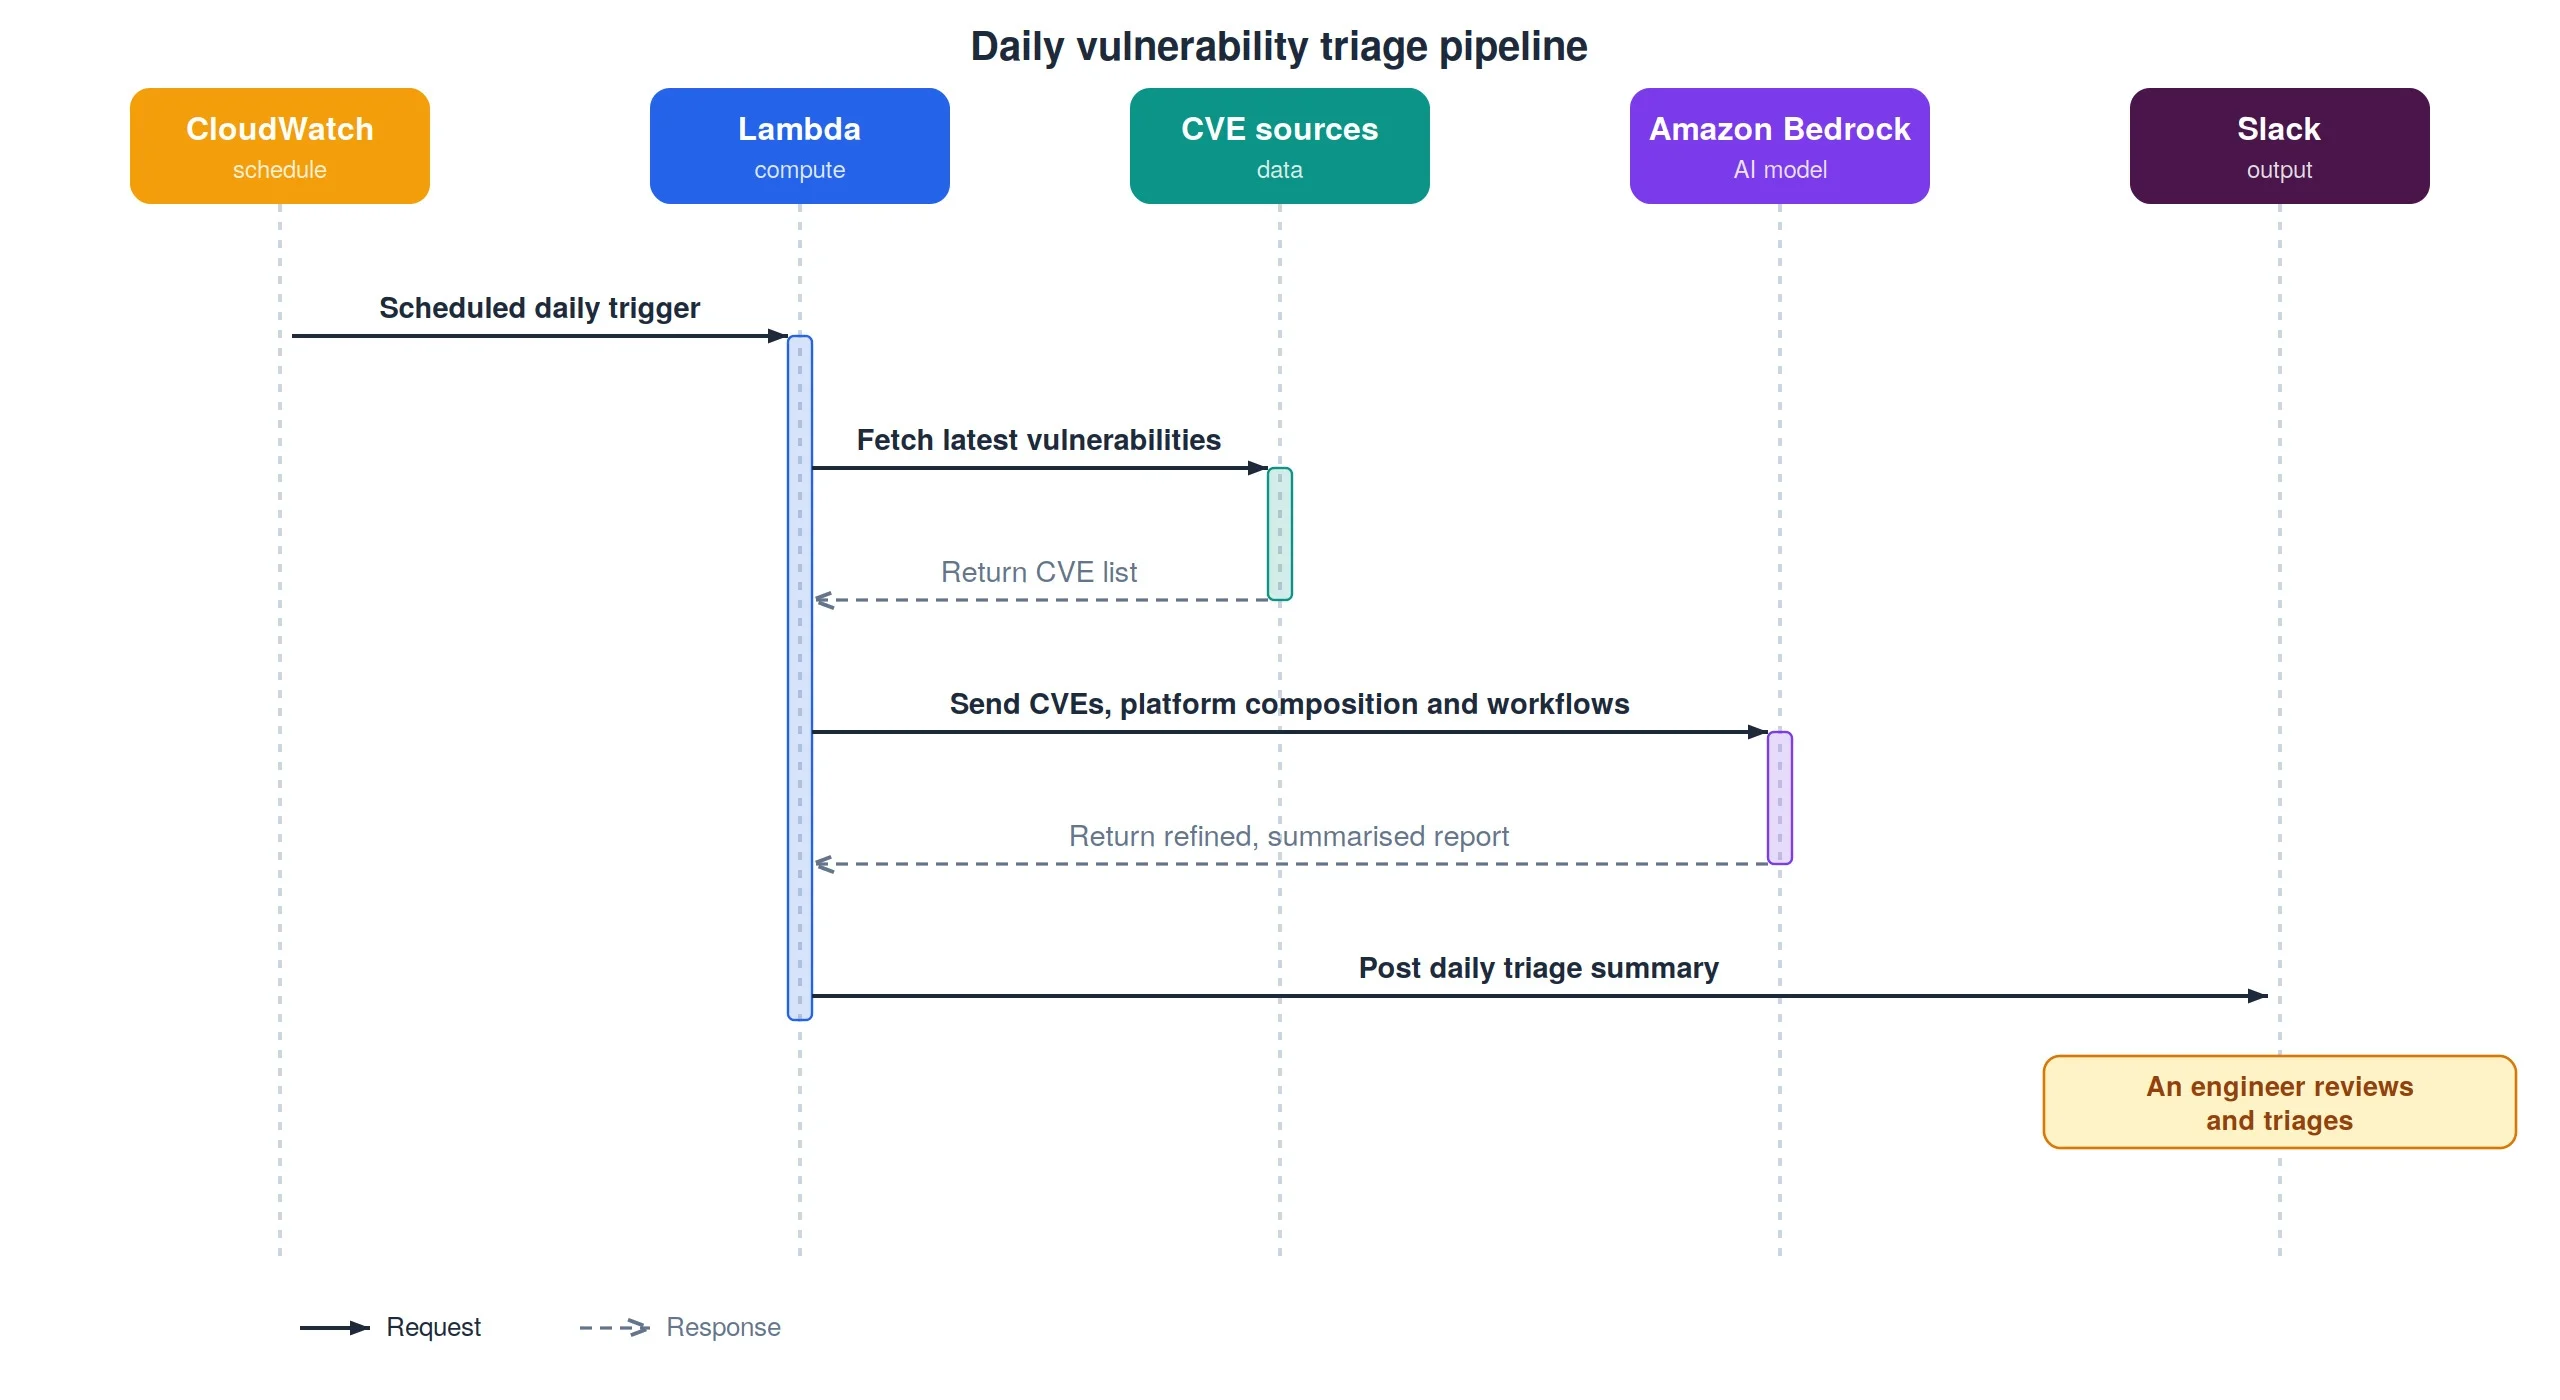
La estrategia de respuesta práctica para mantener el cronograma de desarrollo es construir un pipeline que convierta automáticamente los informes de vulnerabilidades de los LLM de simples tickets de incidencia en «código de pruebas CI reproducible». El caso de una empresa mediana de SaaS que automatizó un pipeline de triage de vulnerabilidades basado en IA demuestra su efectividad.
Este pipeline se diseñó en 8 etapas: recepción de informes, normalización y eliminación de duplicados, puntuación de riesgo, disparador de CI/CD, corrección automática y ciclo de retroalimentación. En particular, al incorporar una fase de eliminación de duplicados que utiliza embebidos semánticos y hash de huellas digitales, se redujo un 65% los informes duplicados 5. Al calcular la puntuación de riesgo, además de la puntuación CVSS (35%), se consideran como pesos la importancia del activo (30%), la madurez del exploit (20%), entre otros 5.
Una vez calculada la puntuación, se realiza un enrutamiento automático que afecta inmediatamente al cronograma de desarrollo. Cuando surgen incidencias críticas (puntuación ≥85), se generan tickets de hotfix de inmediato, y el pipeline CI/CD crea una rama vuln-{id}, inyecta los casos de prueba que fallan y dispara los escaneos SAST/DAST y de dependencias 5. Como resultado de aplicar este flujo de trabajo, el «tiempo medio de corrección de incidencias críticas», que antes de la automatización alcanzaba plazos de varias semanas, se redujo notablemente a 48-72 horas 5. La revisión humana se limita solo a los elementos ambiguos o peligrosos, pero se combinan reglas que obligan a que las pruebas destructivas se realicen usando sandboxes y datos sintéticos, lo que permitió esta mejora de velocidad 5.
Marco de gestión de riesgos para lanzamientos sostenibles
El aumento en la velocidad de descubrimiento de vulnerabilidades por parte de los LLM está sacudiendo desde sus cimientos las premisas del desarrollo de una «defensa perfecta» y un «lanzamiento estable». Si bien la velocidad de la IA para encontrar vulnerabilidades ha alcanzado el nivel de crear exploits en 10-15 minutos, la realidad de que el ciclo de parches en las empresas se alargue a 43 días indica que este nuevo peligro no puede ser asumido mediante procesos antiguos centrados en humanos 1.
Los líderes de los equipos de ingeniería deben reflejar este nuevo ritmo de desarrollo en los cronogramas de sprints y lanzamientos. Lo primero es asegurar en la planificación un «buffer de recursos dedicados al triage de IA» para hacer frente a los retrasos en la revisión de nuevas funciones debido al aumento explosivo de commits de backporting (ej. PostgreSQL 19) 2. Simultáneamente, es necesario integrar en el pipeline CI/CD un ciclo de validación automatizado (ASAN, sandbox) con un periodo previo de ajuste de 2-4 semanas 4. Es el momento de requerir un pipeline que no dependa exclusivamente de la puntuación propuesta por la IA para la gravedad de las vulnerabilidades halladas por los LLM (91,5% calificadas como críticas), sino que comprima el tiempo de respuesta ante incidencias críticas de «meses a 48-72 horas» mediante un sistema de puntuación compuesto que refleje la importancia del activo y la madurez del exploit 315.
Referencias
- AI 보안 취약점 발견 속도, 기업 대응 시스템 추월... ‘안전 마진’ 붕괴 위기 · aeiai.net↩
- Postgres 19 is late, and it's AI's fault · rhaas.blogspot.com↩
- ↩
- ↩
- Automating Vulnerability Triage: Pipeline to Fixes · wecloud.pro↩